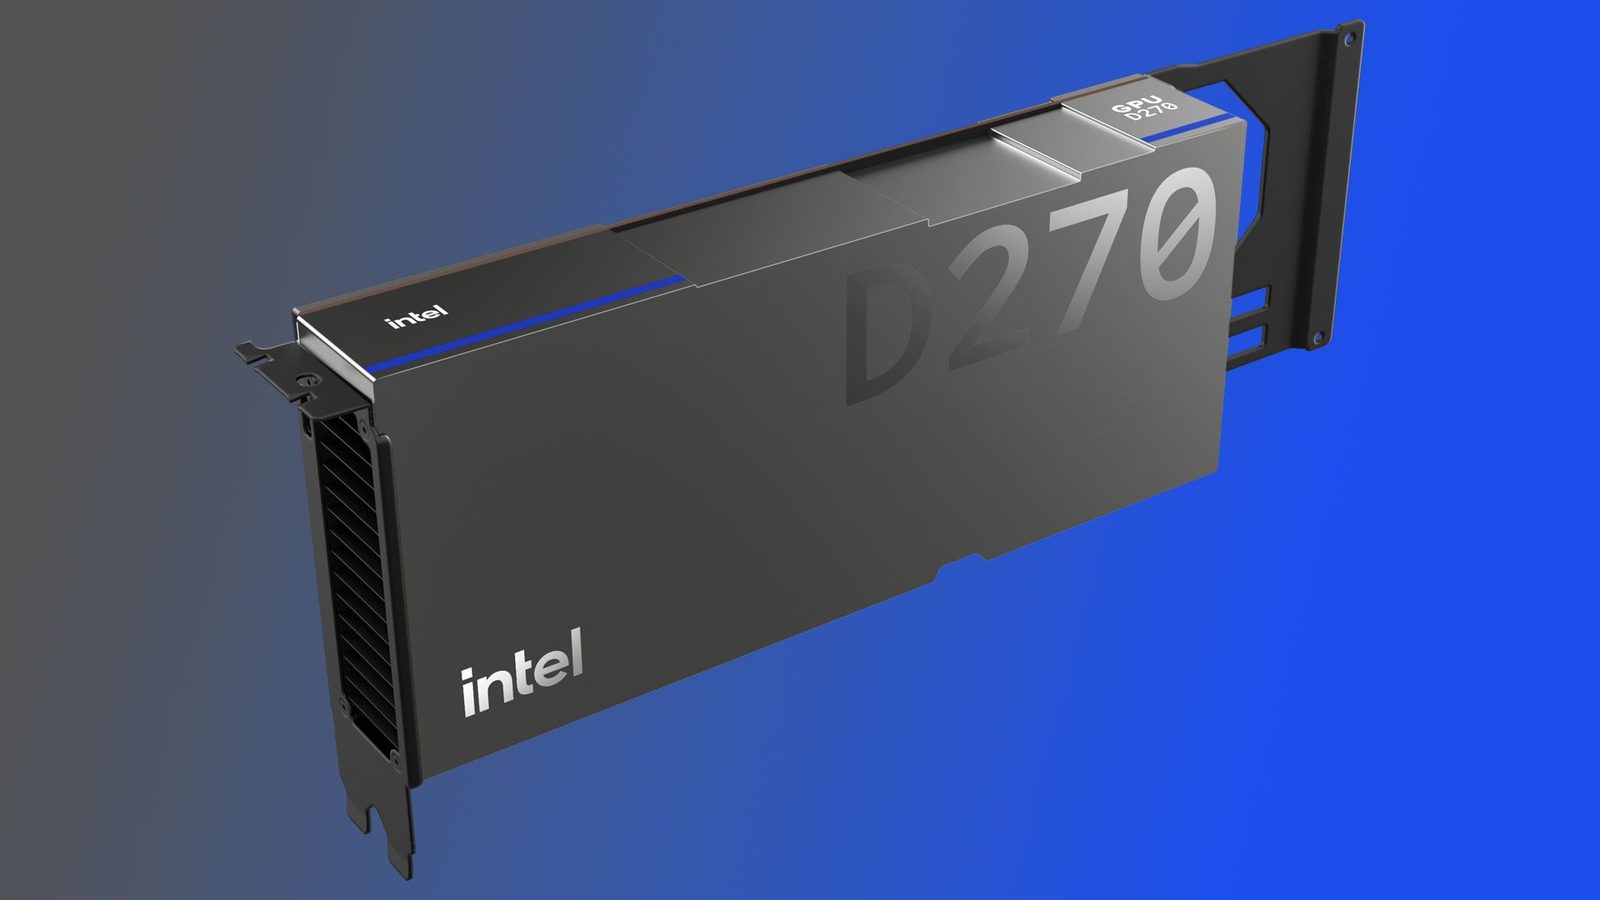
Intel офіційно назвала Crescent Island серією GPU D-Series, цільова повітряно-охолоджена AI-інференція
На OCP 2026 Intel назвала прискорювач Crescent Island серією Intel GPU D-Series та розкрила 1,3 PFLOPS пікових FP8 обчислень, пропускну здатність пам'яті 1,5 TB/s, повітряно-охолоджений PCIe дизайн із 350W та пам'ять LPDDR5X до 480GB.
Intel офіційно назвала Crescent Island серією GPU D-Series
Сьогодні на OCP 2026 Intel дала офіційну назву своєму AI-прискорювачу Crescent Island: Intel GPU D-Series. Разом із заявою компанія також розкрила теоретичну пікову продуктивність чипа на рівні 1,3 PFLOPS у FP8 обчисленнях та показник пропускної здатності пам’яті 1,5 TB/s для цих прискорювачів AI-інференції.
Оприлюднені дані додаються до поступового потоку інформації, яку Intel публікувала про Crescent Island протягом 2026 року. Crescent Island — це перший чип, побудований на основі графічної архітектури Intel Xe3P. Це масово-паралельний обчислювальний дизайн, якому бракує більшості або всіх функціональних блів, притаманних графіці, які зустрічаються в справжньому GPU.
Повітряно-охолоджений PCIe дизайн із пам'яттю LPDDR5X до 480GB
Intel випускає продукти GPU D-Series у форм-факторі PCIe з повітряним охолодженням, TDP 350W та пам'яттю LPDDR5X до 480GB. Ці чипи помітно нижчі у порівнянні з GPU Rubin від Nvidia: у системі Nvidia Vera Rubin NVL72 кожен з 72 Rubin GPU теоретично забезпечує пропускну здатність 17,5 PFLOPS у FP8, але кожен чип потребує рідинного охолодження і, ймовірно, має TGP, виміряний у кіловатах.
Замість того, щоб виступати конкурентом у цьому сегменті, Intel націлюється на традиційні стійкові сервери з повітряним охолодженням, які масштабуються до восьми GPU, подібно до систем Nvidia HGX. У такій конфігурації, за словами Intel, чипи GPU D-Series можуть забезпечувати інференцію для моделей, які містять більше одного трильйона параметрів. Компанія також дослідила відповідність чипа великим мовним моделям, інференції з довгим контекстом та одночасним інференс-сервісам, що створює основу для багатокористувацьких AI-сервісів, робототехніки та інших чутливих до низької затримки навантажень.
Програмний стек та екосистема
Для розгортання розподіленого інференсу, де багато GPU працюють разом, Intel потрібен міцний програмний стек. Компанія вказує на загальну програмну основу Xe, яку вона вже створила для інтегрованих у свої Xe Cores для AI та дискретних GPU-продуктів. Щоб довести прискорювачі Xe до центрів даних, Intel заявляє про роботу з широкою екосистемою, включаючи OЕM, ODM, неоклауди, незалежних розробників програмного забезпечення, постачальників застосунків та AI-нативні компанії.
Отримання зразків продуктів GPU D-Series користувачами вже триває, однак Intel не надала деталей широкого запуску. Продукт представляє спробу Intel отримати основу AI-прискорювача після невдачі сімейства Data Center GPU Max із кодовою назвою Ponte Vecchio, його заморожених нащадків і тих закупівель кремнію, які ніколи не склали послідовну AI-стратегію. Невідомо, чи отримає GPU D-Series визнання, але перевірена архітектурна форма, що безпосередньо орієнтована на інференс у доступному термічному та електричному конверті, може бути тим, що Intel потрібно в умовах зростання значення моделей і агентних робочих процесів.
Джерела: Tom'S Hardware
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.