Ai2 випустив Olmo-core 3 для навчання масштабованих MoE-моделей до трильйона параметрів
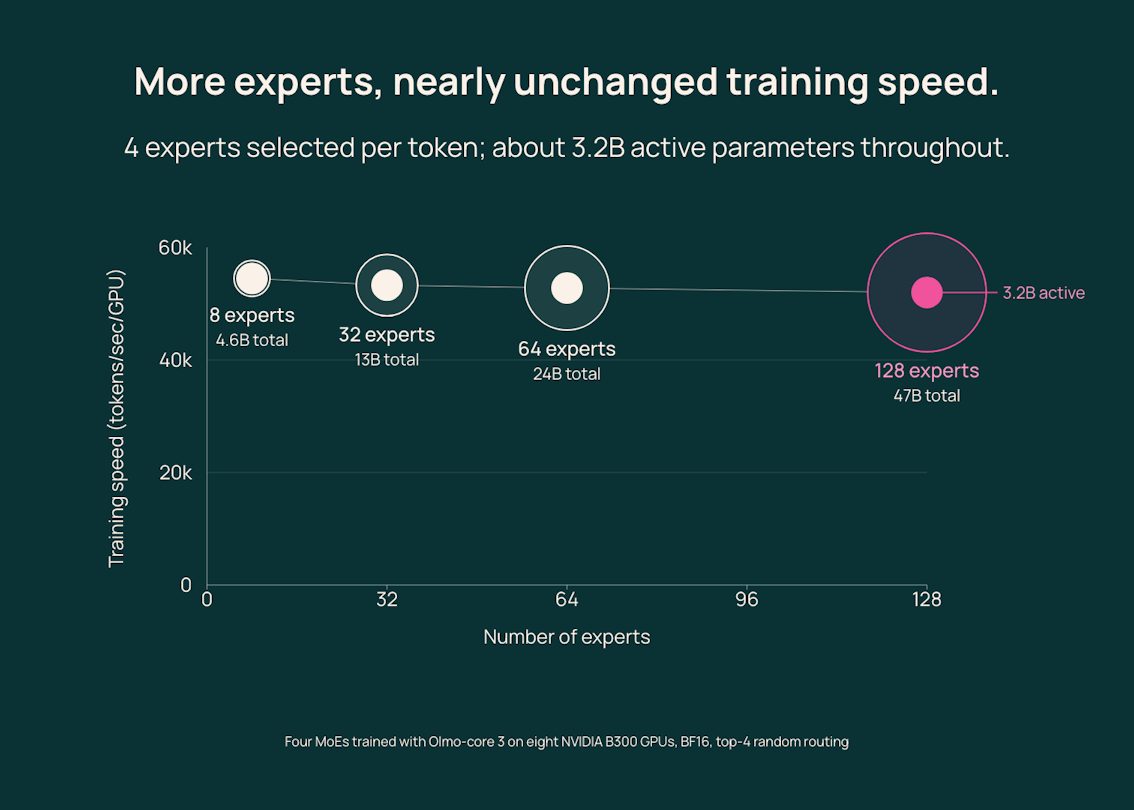
Ai2 випустив відкриту систему Olmo-core 3, яка масштабує навчання MoE-моделей до трильйона параметрів. В одному бенчмарку кількість експертів зросла з 8 до 128, а пропускна здатність навчання зменшилася менш ніж на 5%.
Ai2 (Allen Institute for AI) 1 жовтня випустив Olmo-core 3. Це оновлення її відкритого фреймворку з переробленою системою навчання MoE (суміші експертів). За заявою інституту, він розрахований на масштабування до трильйона параметрів і є однією з основних систем наступного покоління Olmo.
MoE-модель використовує лише частину для кожних даних, однак зберігання всієї моделі та маршрутизація даних до правильних експертів створює витрати, які зростають разом із розміром.
Що змінює Olmo-core 3
В одному бенчмарку кількість експертів зросла з 8 до 128, при цьому на кожен токен знову обиралося чотири експерти, кількість активних параметрів на токен залишилася на рівні близько 3,2 мільярда. Загальна ємність параметрів зросла з 4,6 мільярда до 47 мільярдів, а пропускна здатність зменшилася менш ніж на 5%.
Стара версія використовувала повністю шардований паралелізм даних (FSDP), а Olmo-core 3 перейшов на схему розподіленого паралелізму даних (DDP): експерти залишаються на GPU, дані спрямовуються до них.
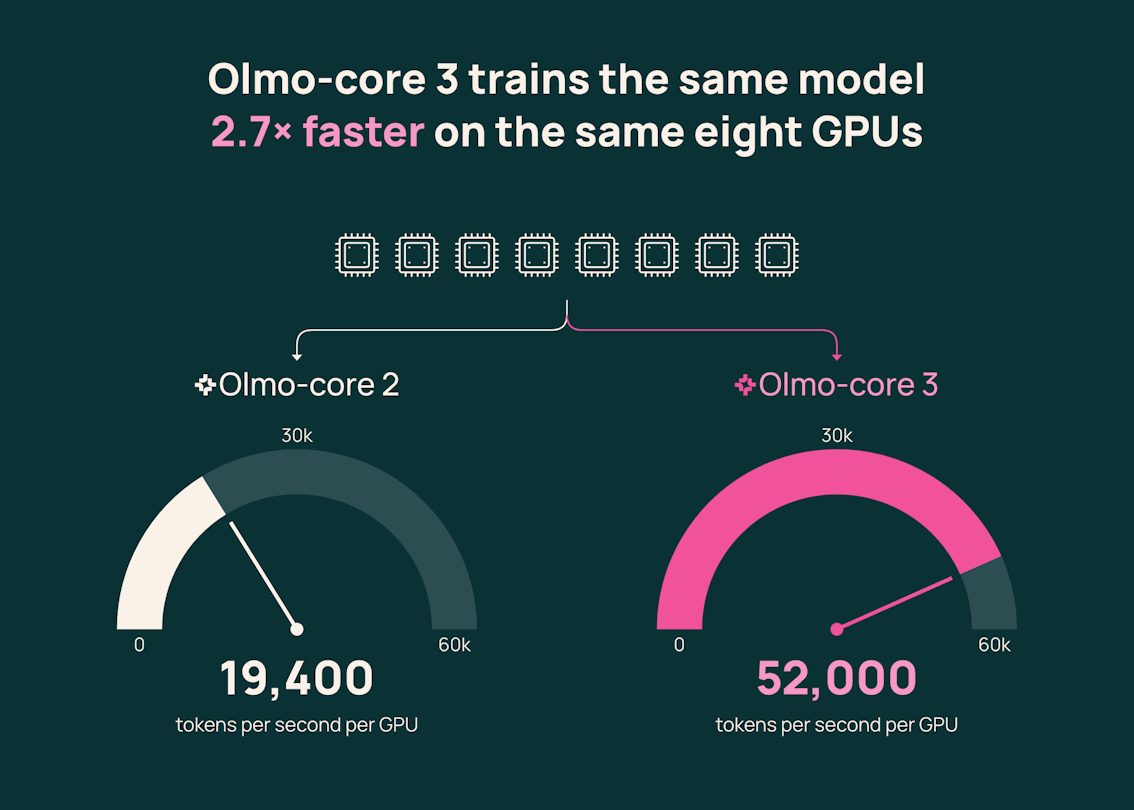
На восьми GPU B300 від NVIDIA MoE-модель із 47 мільярдами параметрів з новою системою обробляла 52 000 токенів на секунду на одному GPU, зі старою версією — 19 400, тобто приблизно в 2,7 рази більше.
Масштабування до трильйона параметрів
Olmo-core 3 розподіляє моделі на апаратному забезпеченні за допомогою паралелізму експертів і конвеєра, а також розподіленого оптимізатора. Метадані залишаються на GPU, маршрутизовані дані потрапляють безпосередньо в буфер експерта, а згрупований GEMM об'єднує невеликі обчислення.
Система також підтримує MXFP8, формат низької точності: на чотирьох GPU B300 вона показала приблизно на 21% більшу пропускну здатність порівняно з BF16, а пікова активна пам'ять впала з 103 GiB до 95 GiB.
Ai2 також протестувала модель із 1,2 трильйона параметрів на 512 GPU, де на один токен припадало 58,36 мільярда активних параметрів; максимальна пропускна здатність на одному GPU становила 858 TFLOP/s. Тести вимірювали роботу системи з випадковою маршрутизацією, а не якість моделі; експеримент DeepEP v2 досяг 2,38 трильйона параметрів у короткому тесті.
Відкрита інфраструктура
Він використовує архітектуру Olmo MoE наступного покоління і має стати найпотужнішим Olmo, навченим на найбільшому наборі даних і з найдовшим контекстом. Система повністю відкрита: дослідники можуть навчувати на ній власні MoE-моделі та адаптувати їх до іншого апаратного забезпечення; технічний звіт, код і інтерактивне демо вже доступні.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.