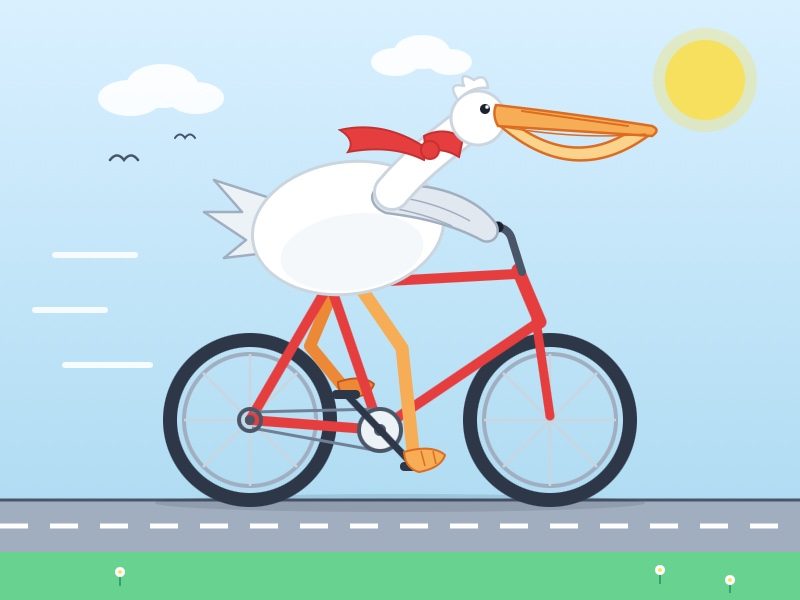
Kimi K3: 2,8 трлн параметрів і пелікан за 25 центів
Moonshot AI представила Kimi K3 — модель на 2,8 трлн параметрів, яку називає першою «відкритою системою класу 3T»; відкриті ваги обіцяють до 27 липня 2026 року.
Китайська AI-лабораторія Moonshot AI у четвер представила Kimi K3, описуючи її як «найздатнішу модель на сьогодні, з 2,8 трлн параметрів». Модель уже доступна через сайт компанії та API, а реліз із відкритими вагами обіцяно «до 27 липня 2026 року».
Позиціонування та ціна
Moonshot називає K3 першою «відкритою моделлю класу 3T», округлюючи 2,8 трлн до трьох трильйонів і забираючи це звання в DeepSeek 1.6T v4 Pro. За власними бенчмарками компанії K3 у більшості порівнянь випереджає Claude Opus 4.8 max і GPT-5.5 high, але поступається Claude Fable 5 та GPT-5.6 Sol. Незалежний оцінювач Artificial Analysis виміряв Elo 1547 у своєму приватному тесті довготривалої інтелектуальної роботи — на 732 пункти більше за Kimi K2.6 і лише після Claude Fable 5 — за 0,94 долара за завдання, проти 1,04 долара в GPT-5.6 Sol і 1,80 долара в Opus 4.8. Витрати токенів в Intelligence Index знизилися на 21% порівняно з K2.6. Модель також очолює арену Frontend Code від Arena.ai, випереджаючи Claude Fable 5.
Найпомітніша зміна — ціна: 3 долари за мільйон вхідних токенів і 15 доларів за мільйон вихідних, на рівні серії Claude Sonnet від Anthropic і найдорожче на сьогодні рішення китайської лабораторії — різке зростання порівняно з Kimi K2.6 за 0,95 і 4 долари.
Як вона малює пелікана на велосипеді
Саймон Віллісон, який 21 місяць проганяє свій SVG-промпт «пелікан на велосипеді» через нові моделі, згенерував такого з K3 через OpenRouter. Запуск використав 95 вхідних і 16 658 вихідних токенів, з них 13 241 — токени міркування, що коштувало 25 центів. Отримавши готове зображення як вхідні дані, модель точно його описала — приблизно за 0,6 цента. Промпт також показав, що K3 поки має лише один рівень міркування — «max», а саме лише «hi» тарифікується у 86 токенів, що натякає на прихований системний промпт приблизно на 85 токенів, який модель відмовилася розкрити.
Що цей тест ще показує
Віллісон прямо каже, що пелікан — поганий бенчмарк і його не варто використовувати для рейтингу моделей: він нічого не говорить про виклик агентних інструментів чи надійність у довгих розмовах, а його давніша кореляція з якістю моделей зруйнувалася — пелікани GPT-5.6 і Claude Fable 5 поступаються GLM-5.2. Цінність тесту вужча: він змушує справді запустити модель, дає приблизну оцінку витрат і обсягу міркувань, підтверджує коректний SVG і базове просторове мислення та дозволяє порівнювати моделі в межах однієї родини, де птах K3 помітно кращий за Kimi 2.5.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.