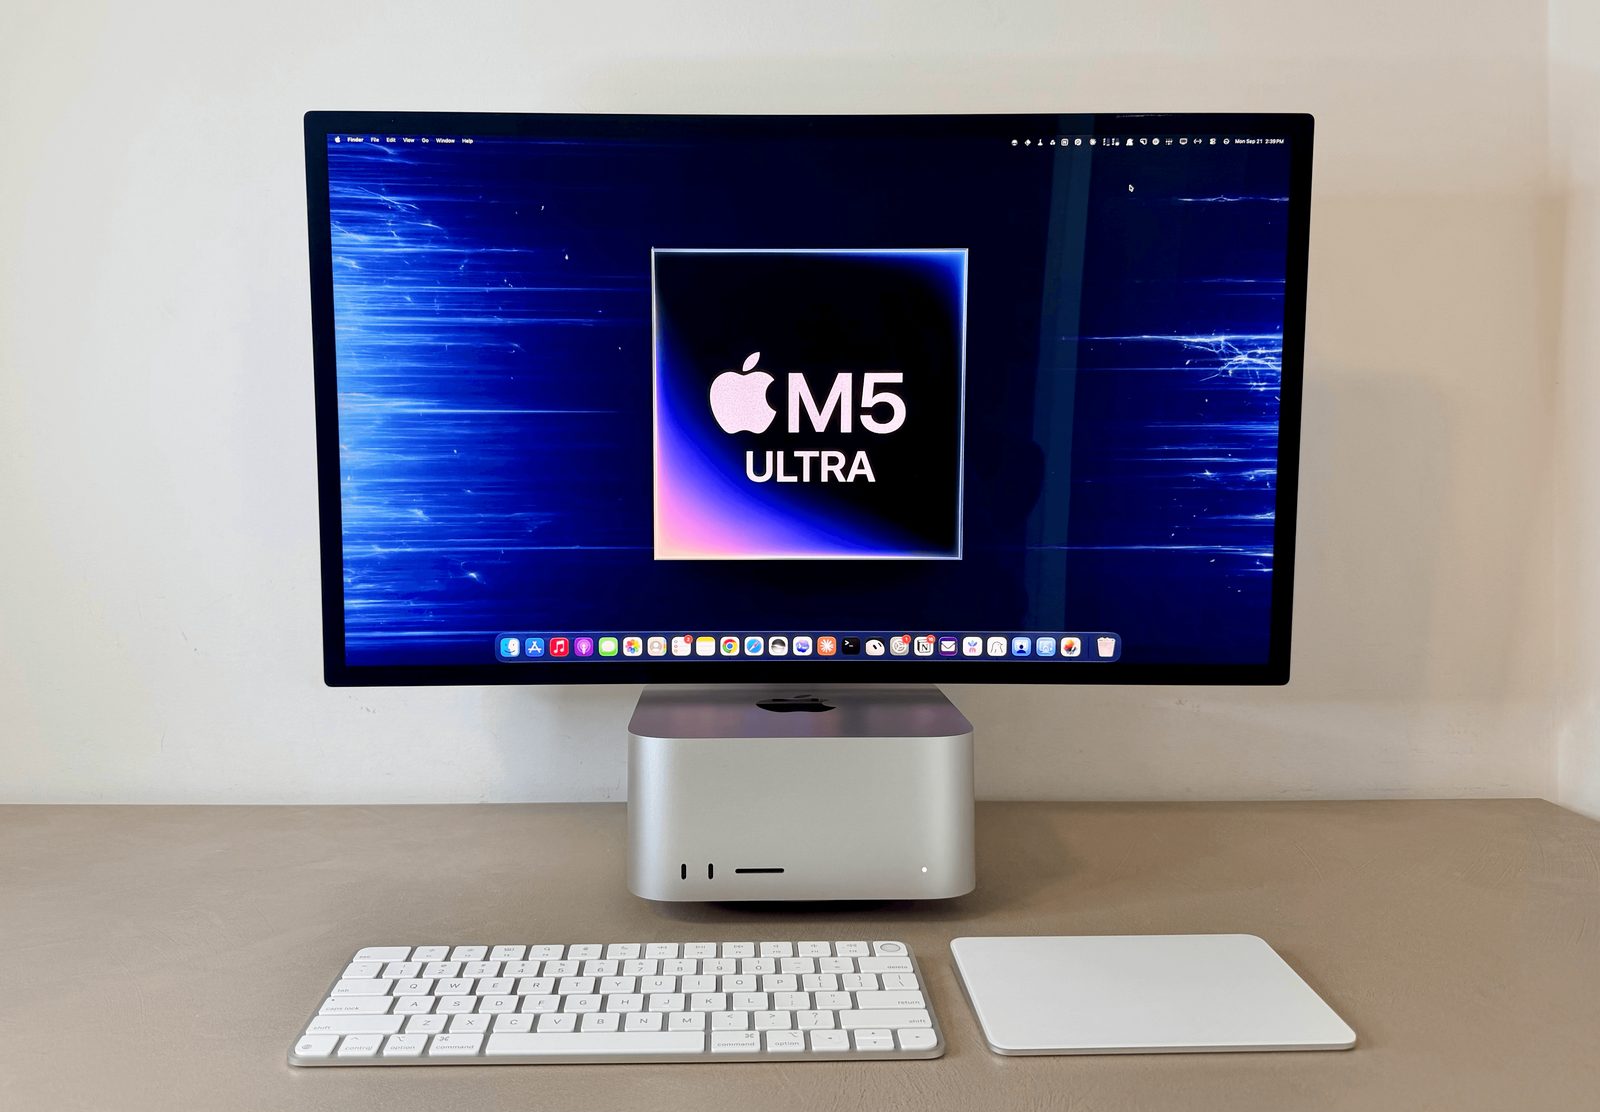
Огляд M5 Ultra Mac Studio: стрибок для локальних ШІ-агентів
MacStories чотири дні тестував M5 Ultra Mac Studio на 256 ГБ у порівнянні з M3 Ultra та ПК з RTX 5090. За оглядом, обробка промптів зросла в середньому на 150%, що робить локальних агентів практичними.
MacStories опублікував огляд M5 Ultra Mac Studio — комп'ютера, який сьогодні очолює лінійку настільних Mac від Apple. Автор Федеріко Вітіччі чотири дні тестував конфігурацію з 256 ГБ пам'яті, порівнюючи її з попередником M3 Ultra на 512 ГБ і власним ігровим ПК з RTX 5090. Його висновок: це перший Mac, який робить локальних ШІ-асистентів практичними, а не експериментальними.
Нова архітектура в незмінному корпусі
Зовні M5 Ultra ідентичний моделі M3 Ultra, яку він замінює, але кремній новий: Apple за допомогою UltraFusion з'єднує два чіпи M5 Max із подвійним кристалом у чотирикристальну конструкцію — вперше в історії компанії. GPU має 80 ядер, кожне з Neural Accelerator, що дає до 4,5 раза більше пікової обчислювальної потужності для ШІ порівняно з M3 Ultra. Об'єднана пам'ять, на якій тримаються локальні моделі через MLX, досі доступна у варіантах 256 і 512 ГБ, а її пропускна здатність зросла з 819 ГБ/с до 1,2 ТБ/с, тобто на 50%. Модель на 512 ГБ має вийти наприкінці жовтня.
Виміряні результати
За чотири дні тестів у macOS 27 з oMLX 0.7.0.dev2 і моделлю Qwen3.8-Flash-Next швидкість обробки промпту зросла в середньому на 150% — приблизно у 2,5 раза порівняно з попереднім стендом автора: промпт на 16 тисяч токенів читався зі швидкістю 2 887 токенів за секунду проти 1 143 на M3 Ultra. Генерація в тому ж порівнянні була приблизно на 70% швидшою, а графіки показують зниження від 91 до 75 токенів за секунду в міру зростання контексту від 4K до 256K. На промпті 256K із холодним кешем M3 Ultra потребував близько 245 секунд до першого видимого токена, тоді як M5 Ultra — 102 секунди. На трьох одночасних запитах (по ~6,5 тис. токенів) новіший Mac видав 81,5 токена за секунду сумарно — на 23% більше, ніж на одному запиті; M3 Ultra додав лише 4%.
RTX 5090 досі попереду, але з обмеженнями
Карта NVIDIA залишається швидшою, поки модель уміщається в її пам'ять: на промпті з 6 тисяч токенів вона читала близько 3 000 токенів за секунду проти приблизно 1 700 у M5 Ultra, а в генерації мала 25% переваги завдяки пропускній здатності 1,79 ТБ/с проти 1,2 ТБ/с. Її стеля — 32 ГБ VRAM: з 8-бітним кешем уваги вона завершувала довгі контексти на 49,6, 40,4 і 30 токенах за секунду для 64K, 128K і 256K, але щойно довелося позичати системну пам'ять через PCIe, ці показники впали до 4,6, 2,9 і 1,5. Автор також зазначає, що ПК значно більший, гучніший і гарячіший, тоді як вентилятор Mac Studio у звичайній роботі з локальними моделями не чути.
Чому локальні агенти важливі для автора
Інтерес Вітіччі практичний. Його дослідницька система для літнього огляду iOS та iPadOS 27 трималася на агентах, що працювали цілодобово 99 днів над проєктом із 310 документів, із загальною вартістю $0 — навантаження, яке, за його словами, було б непідйомним через хмарні API. Локальну модель він зробив типовим вибором у застосунку Open Minis для iOS. Оптимальною квантизацією для моделі на 256 ГБ він називає 5-бітну.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.