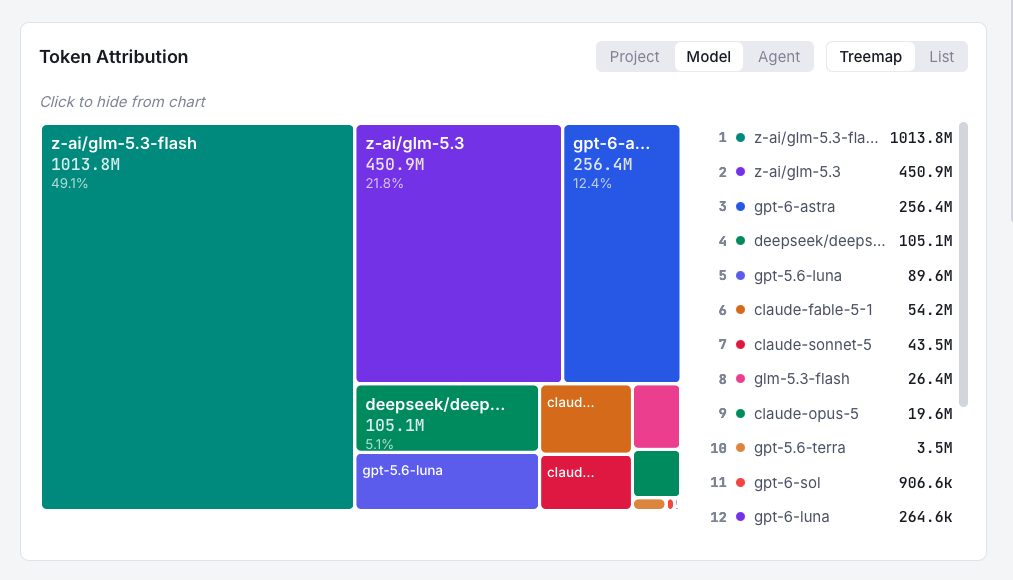
Виклик GLM 5.3 Flash на місяць завершився з 50% використання
Місячна спроба використовувати GLM 5.3 Flash для всіх AI-завдань завершилася тим, що половина 2B токенів пішла на цільову модель. Тест виявив витрати прототипу, обмеження потужності провайдера та вартість вимірювання ефективності.
Розподіл використання та витрати прототипу
Експеримент із запуском ефективної відкритої моделі у вересні дав показник 50% привласнення. З GLM 5.3 Flash було оброблено лише 1B токенів з 2B, хоча у першій половині він виконав усю роботу. Його заявлене використання не перевищувало бюджет у 68 доларів, приблизно 4kWh енергії та 365 грамів вуглецевих емісій. Для другої половини знадобилося 1B токенів на інших моделях.
Одне з несподіванок було пов'язано з експериментальним Wagtail MCP сервером, який описували як прототип, створений вайб-кодингом. Вибір моделі спричинив витрату 450M токенів, 150 доларів та 5kWh енергії лише за одну ніч. Сервер працював добре та продемонстрував свої можливості, однак за оцінкою команди, подібний результат можна було досягти з витратою в п'ять разів менше та незначними додатковими зусиллями. Цей випадок ще раз підтвердив, що для експериментів потрібен бюджет і моделі слід обирати ретельно.
Доступність інфраструктури
Доступність провайдерів була ще однією проблемою. Провайдери інференсу, які використовувала команда, часто працювали, але популярний вибір не мав такої ж потужності, як великі лабораторії. GLM 5.3 Flash показав знижену продуктивність, ймовірно через те, що для роботи команди він знаходився на високій позиції на фронті Парето. Доступний вибір також був обмежений лише відкритими моделями, розміщеними в європейських центрах даних. Це спричинило перехід на подібні моделі, DeepSeek V4.1 Flash та Qwen 3.8 Flash, що було простою зміною і не очікувалося.
Цінність для рутинної розробки
Використання однієї моделі в рутинній інженерії не усунуло необхідність тестування широкого спектру пропозицій. Команда починає бенчмаркінг моделей на завданнях Wagtail і потребує порівняльних даних, щоб рекомендувати легші варіанти для здібностей агентів та нового CLI прототипу, який має добре працювати з агентами.
GLM 5.3 Flash все одно був оцінений як відмінний для виробничої роботи завдяки вікну контексту на 1M токенів, підтримці зору та доступності багатьох провайдерів. Його використовували на Wagtail та сайтах, побудованих з його допомогою, а також для UI завдань, AI досліджень та розробки, документації та оглядів.
Уроки для наступного тесту
Виклик на жовтень зосереджений лише на рутинній виробничій роботі, а не на дослідженнях і розробці. Заплановані зміни включають неперервне локальне звітування про використання токенів, енергоспоживання, витрати та конкретні результати. Команда також планує встановити чіткі бюджети для експериментів, покращити відбір промптів, використовувати багатоагентні робочі потоки на основі ролей та продовжити тестування ефективних моделей.
Широкіша мета полягає в тому, щоб більшість роботи AI-інференсу виконувалася однією або двома дешевими моделями flash-класу, а прогрес оцінювався не кількістю токенів, а витратами або енергоспоживанням. Команда також спостерігатиме за дифузійними моделями рішень у стилі Jev, якщо вони працюють ефективно, тоді як нові флагманські моделі розглядатимуться як кроки в правильному напрямку.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.