Ai2 випустила модель з відкритими вагами AstaBrief 8B: готує наукові звіти в 3,5 рази швидше
Ai2 (Allen Institute for AI) випустила модель з відкритими вагами AstaBrief 8B: вона готує цитовані звіти з дослідницьких запитів та знайденої літератури та працює в Fast mode в середньому за 51,1 секунди, що в 3,5 рази швидше Thinking mode.
Allen Institute for AI (Ai2) 2 жовтня випустила модель з відкритими вагами AstaBrief 8B. Модель готує цитовані звіти з фрагментів дослідження та знайденої літератури та вже працює в Asta у режимі Fast mode, поруч з Thinking mode.
У повному пайплайні Fast mode готує один звіт в середньому за 51,1 секунди, порівняно з 178,5 секундами Thinking mode, тобто приблизно в 3,5 рази швидше. Модель пише звіт за один прохід і пропускає етапи резюмування та кластеризації; за словами Ai2, якість не постраждала.
Відкрита модель для наукових звітів
AstaBrief 8B — це модель з восьма мільярдами параметрів на базі Qwen3-8B. Дослідники Ai2 працювали переважно з post-training даними та оцінкою. Відкриті ваги дозволяють інститутам запускати модель на власній інфраструктурі, за фаєрволом, що важливо для чутливих досліджень.
Як тренували модель
AstaBrief тренували у два етапи: supervised fine-tuning (SFT) та direct preference optimization (DPO). Ai2 обрала простіший шлях замість дорогого та нестабільного RL-підходу. Тренувальні запити взяли з логів реальних користувачів: після фільтрації залишилося 90 тисяч дослідницьких запитів.
Для SFT цільові звіти створив пайплайн ScholarQA (Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, GPT-4.1); після фільтрації залишилося 47 тисяч прикладів. Для DPO пари порівнювали дві моделі-судді (GPT-4.1 та DeepSeek-R1), у фінальному наборі до 6 тисяч прикладів. З чотирьох статистичних фільтрів найбільший приріст дав відсів прикладів з низькою щільністю цитат.
Результати та використання
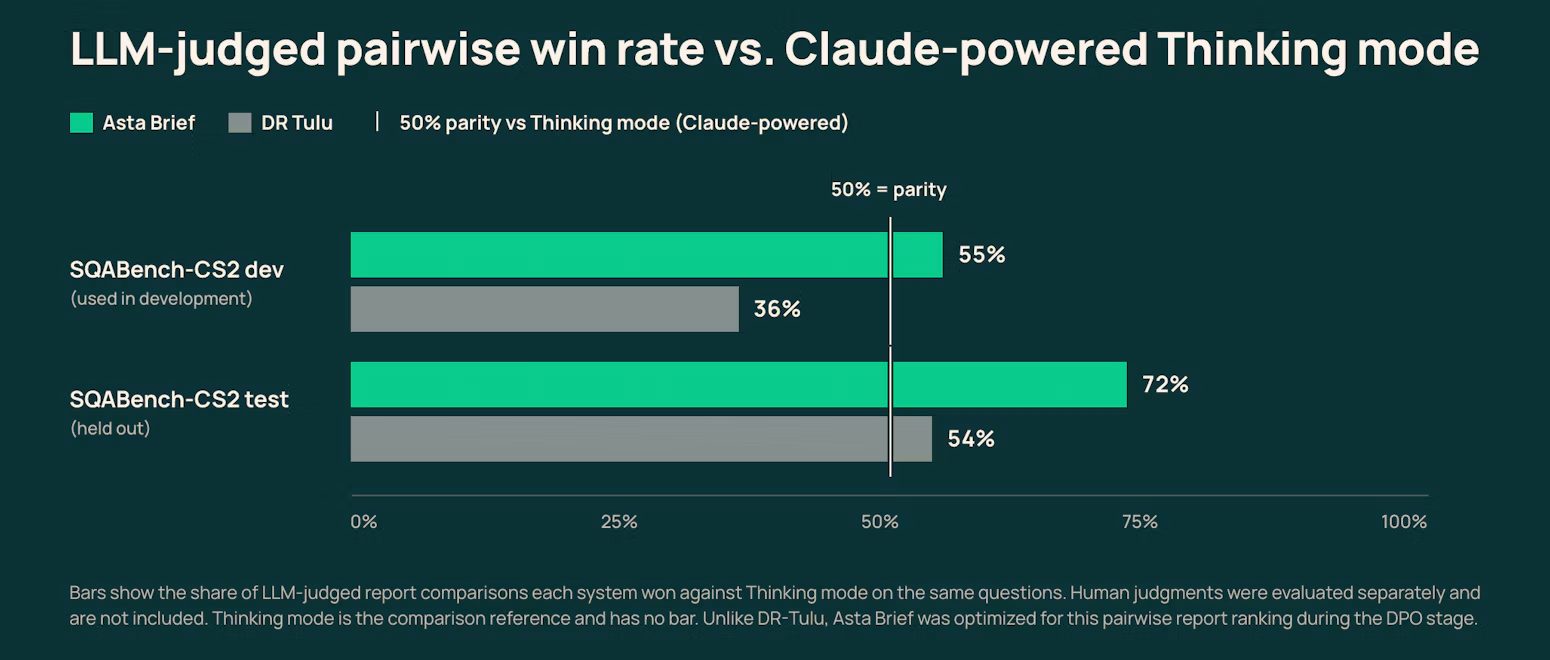
Основною метою оцінки був SQABench-CS2: 200 запитань з комп'ютерних наук. Виміряли оцінку за рубрикою, точність відповіді, точність цитат та повноту; додатково перевірили на DeepScholarBench (63 запитання) та провели людське дослідження з 14 запитань.
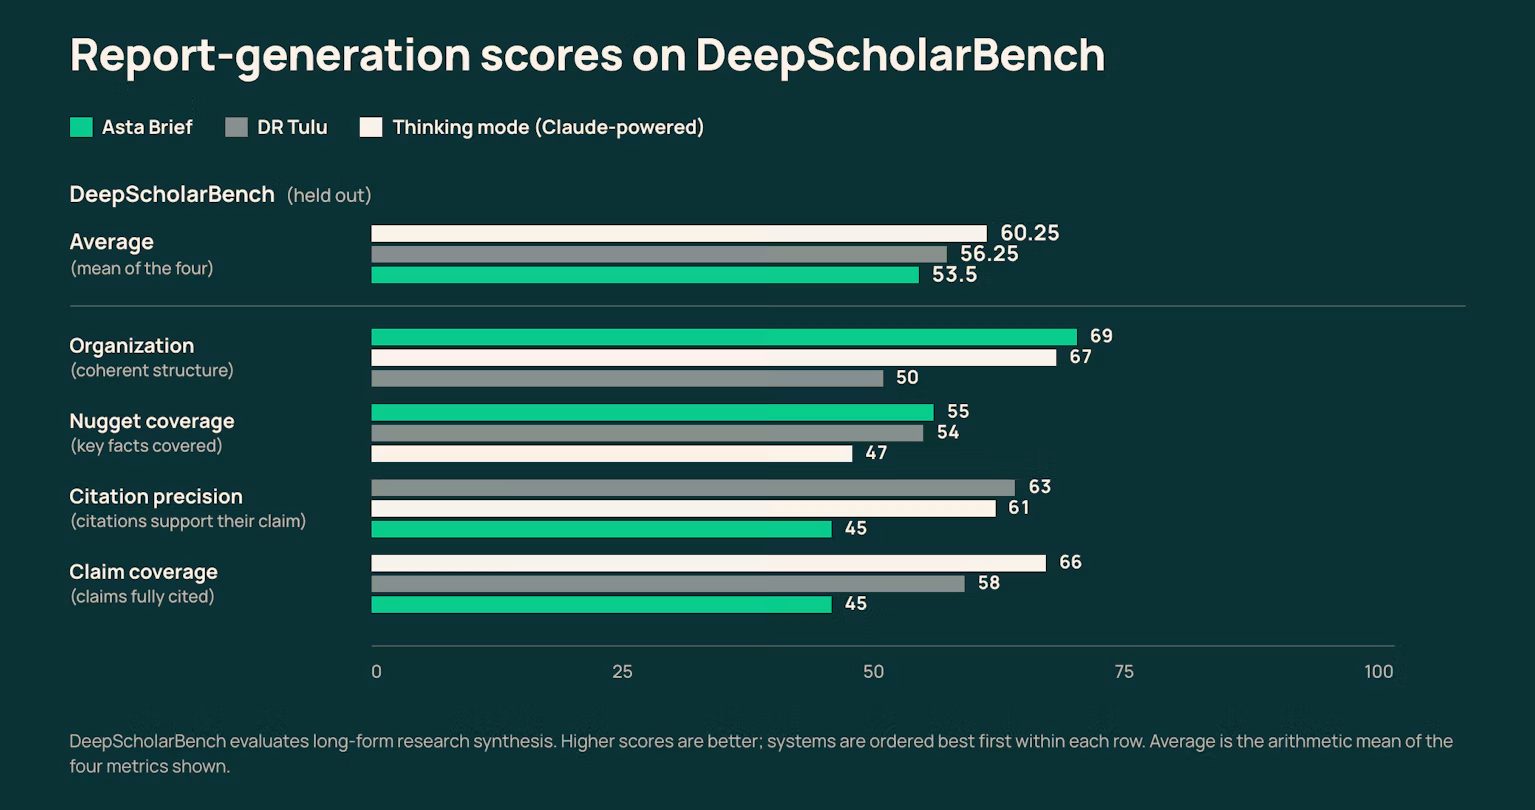
AstaBrief конкурентоспроможна з пайплайном на основі Claude та DR Tulu. У людському дослідженні загалом перемагає DR Tulu, однак двоє з трьох дослідників віддали перевагу AstaBrief у точності цитат. Ai2 зазначає, що оцінка проводилася переважно у 2025 році та не повторювалася з сучасними моделями.
Раннє використання позитивне: Fast mode спробували 374 користувачі, 29,1% використовують його два або більше днів, в середньому створюють 3,67 треди звітів. 23% віддали перевагу залишитися у Fast mode, 18% перемикалися між режимами, а 40% тредів провели у Fast mode. Позитивний відгук в обох режимах подібний: 84,2% для Fast mode та 85,2% для Thinking mode.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.