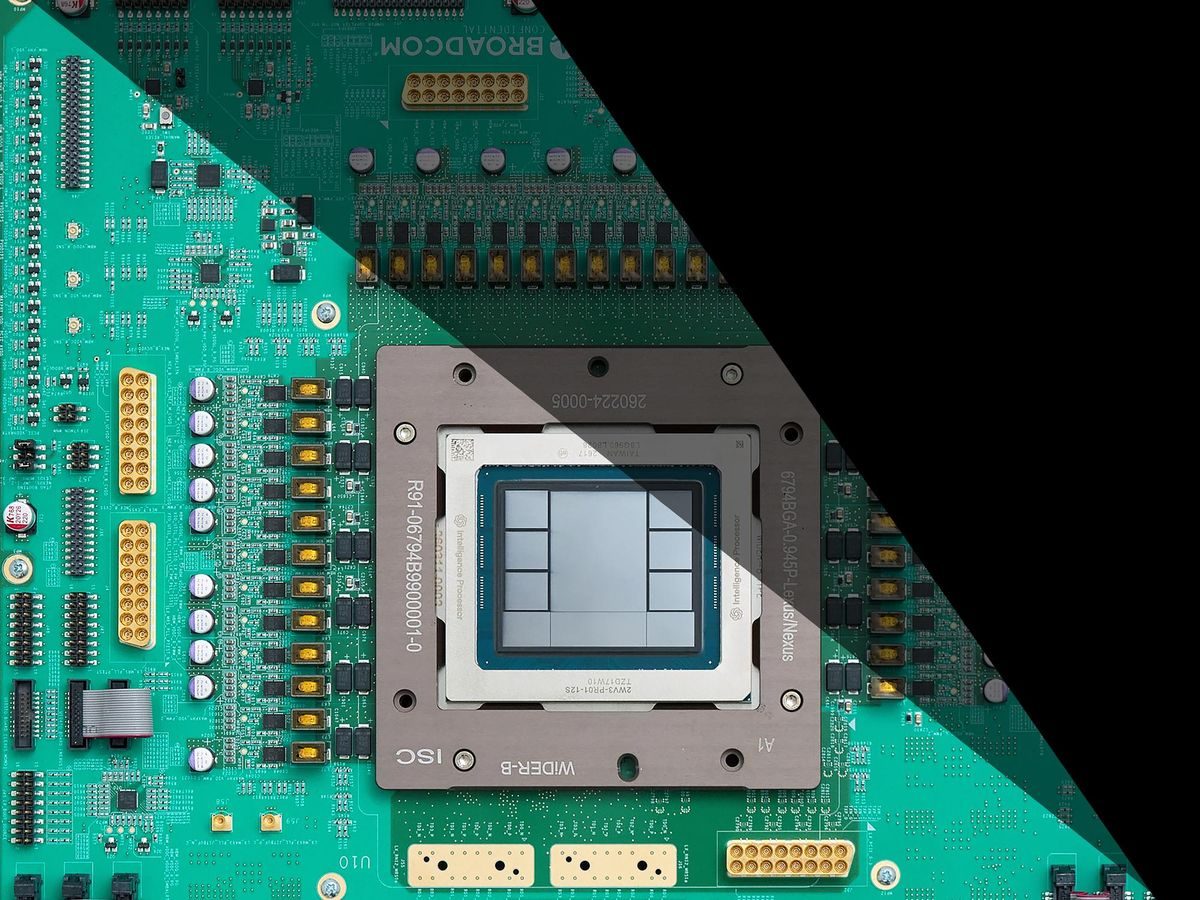
Як OpenAI спроєктувала свій чип Jalapeño за допомогою власних LLM
Перший AI-прискорювач OpenAI Jalapeño пройшов шлях від концепції до кремнію менш ніж за 20 місяців — пришвидшили роботу власні мовні моделі компанії.
Що сталося
За даними IEEE Spectrum, Jalapeño — перший AI-прискорювач OpenAI — проєктували за допомогою власних великих мовних моделей компанії. Від першої архітектурної концепції до першого кремнію минуло менш ніж 20 місяців, а від першого RTL до tape-out — лише дев’ять.
Jalapeño забезпечує до 13,4 петафлопс 4-бітних обчислень, 232 ГБ пам’яті HBM4 і пропускну здатність 15,4 ТБ/с. За оцінками OpenAI, він скорочує наскрізну затримку до 3,6 раза порівняно з Nvidia GB300, споживаючи менше енергії.
Чому це важливо
«Моделі дають нашим інженерам суперсили», — каже Річард Хо, віцепрезидент OpenAI з апаратного забезпечення. У команді було менш ніж 100 людей, які працювали разом із Broadcom, що відповідала за фізичний дизайн. Експерти вважають цей графік реалістичним — і припускають, що скоро він здаватиметься повільним.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.