Qwen3.8-27B на одній RTX 3090 проти двох: +20% декоду, +14% холодного prefill, 3x на кешованих запитах
Тест Qwen3.8-27B у vLLM: одна RTX 3090 проти двох карт у режимі tensor parallelism. Друга карта додає 15–30% до швидкості декодування та в середньому 14% до холодного prefill, а решта приросту належить prefix cache.
Qwen3.8-27B — щільна модель на 27,8 млрд параметрів, випущена 14 серпня, — у квантизації W4A16 вміщується на одній 24-гігабайтній карті. Arsen Apostolov виміряв, що насправді дає друга RTX 3090 у режимі tensor parallelism.
Що вимірювали
Обидва сервери працюють на vLLM із увімкненим prefix caching, з одного образу й з тими самими вагами Qwen3.8-27B-W4A16-AutoRound-fast. Одна карта має 22,6 ГБ VRAM і контекст на 131 072 токени; пара розподіляє ваги по 21,7 ГБ на карту й подвоює контекст до 262 144 токенів. Машина несе три RTX 3090, два Xeon E5-2660 v4, 60 ГБ RAM і Ubuntu 26.04.
Вимірювання — скрипт на 150 рядків: запити чотирьох розмірів (від 600 до 9 300 токенів), кожен тричі, з медіаною, max_tokens=256 і temperature=0. Кожен холодний запит має унікальний перший рядок, тож жоден кешований префікс не збігається.
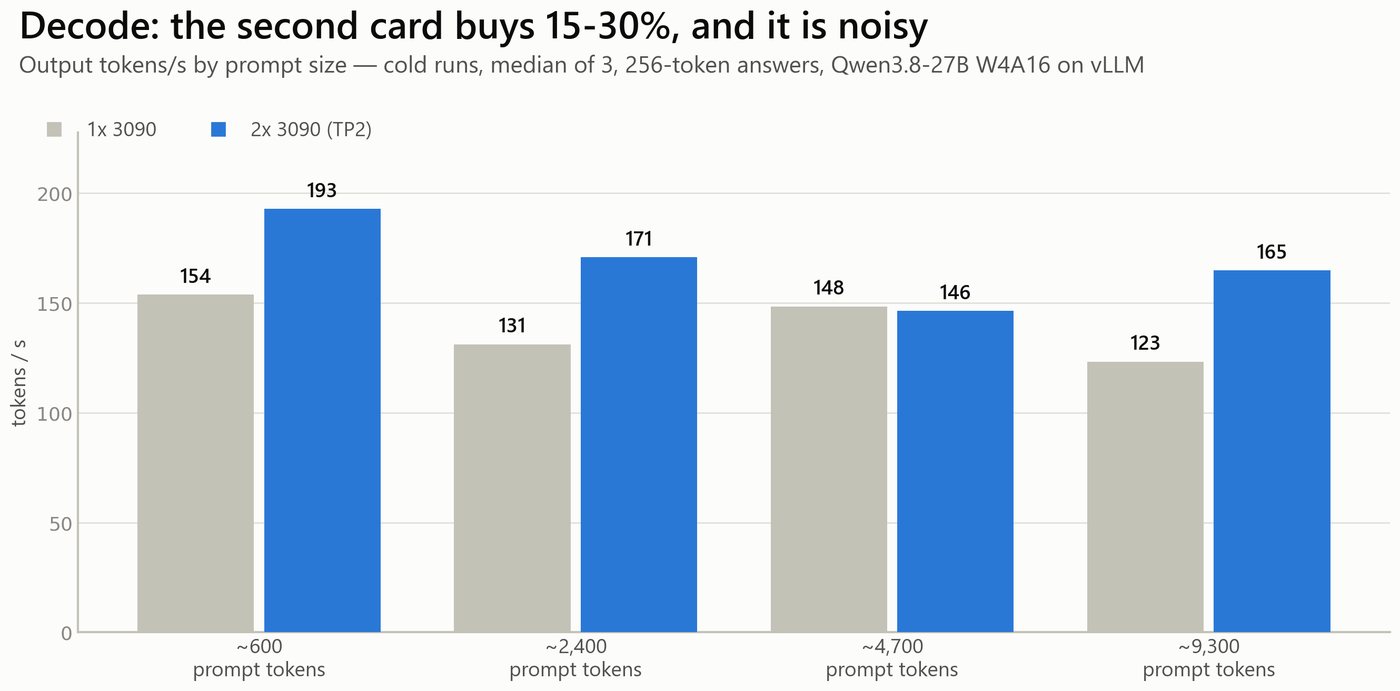
Декодування: 15–30% від другої карти
Одна карта тримає 123–154 токени за секунду, пара — 146–193. Приріст склав у середньому +22% у цьому прогоні та +13% годиною раніше, бо однопотокове декодування коливається приблизно на 10% за годину. Автор навмисно не округлює: кажіть 15–30% і орієнтуйтеся на нижню межу.
Prefill: холодний — карти, теплий — кеш
Холодний prefill залежить від обчислень: одна карта обробляє 1 100–1 220 токенів за секунду, пара — 1 230–1 360. Час до першого токена зростає з 0,53 с до 8,5 с на одній карті, коли запит росте з 600 до 9 300 токенів, і з 0,50 с до 6,9 с на двох — розрив 6% на 600 токенах, 23% на 9 300, у середньому 14%.
Теплі запити показують інше: повторений запит повертається за 0,5–0,75 с на парі проти 0,5–1,7 с на одній карті; ця різниця у 2–3 рази належить prefix cache, а не залізу. Підказка в арифметиці: 8 600 токенів за 0,56 с — це 15 000 токенів за секунду, вдесятеро більше, ніж дві 3090 реально видають на моделі 27B.
Скільки це коштує
Коли обидва контейнери обслуговують запити, машина споживає 620 Вт від розетки. Мільйон згенерованих токенів за 150 токенів за секунду займає близько 6 667 секунд, тобто 1,15 кВт·год — 0,34 BGN удень або 0,21 BGN уночі за болгарським двозонним тарифом, приблизно $0,20 чи $0,12. DeepInfra оцінює Qwen3.8-27B у $3,00 за мільйон вихідних токенів.
Apostolov не стверджує, що через це API — погана угода: у ціну входять енергія датацентру, охолодження та простій. Вужчий висновок: на залізі, яке вже працює, кожен відданий токен — майже чиста маржа. Автор позначає й межі тесту: вимірювання одного запиту, continuous batching не перевірявся.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.