Податок токенізатора: чому неангломовні користувачі ШІ платять більше за токени
Дослідження Коаліції за мовну рівність у дослідженнях ШІ каже, що моделі ШІ можуть використовувати набагато більше токенів для деяких мов, підвищуючи вартість, затримку та обмеження контексту для неангломовних користувачів.
Дослідження Коаліції за мовну рівність у дослідженнях ШІ виявило, що моделі ШІ можуть потребувати набагато більше токенів для одних мов, ніж для інших, створюючи прихований податок токенізатора. Цей ефект може робити ШІ дорожчим для людей, які використовують менш поширені мови, особливо з меншою присутністю в інтернеті. Токени: одиниці тексту або даних, які обробляють моделі ШІ.
Як кількість токенів залежить від мови
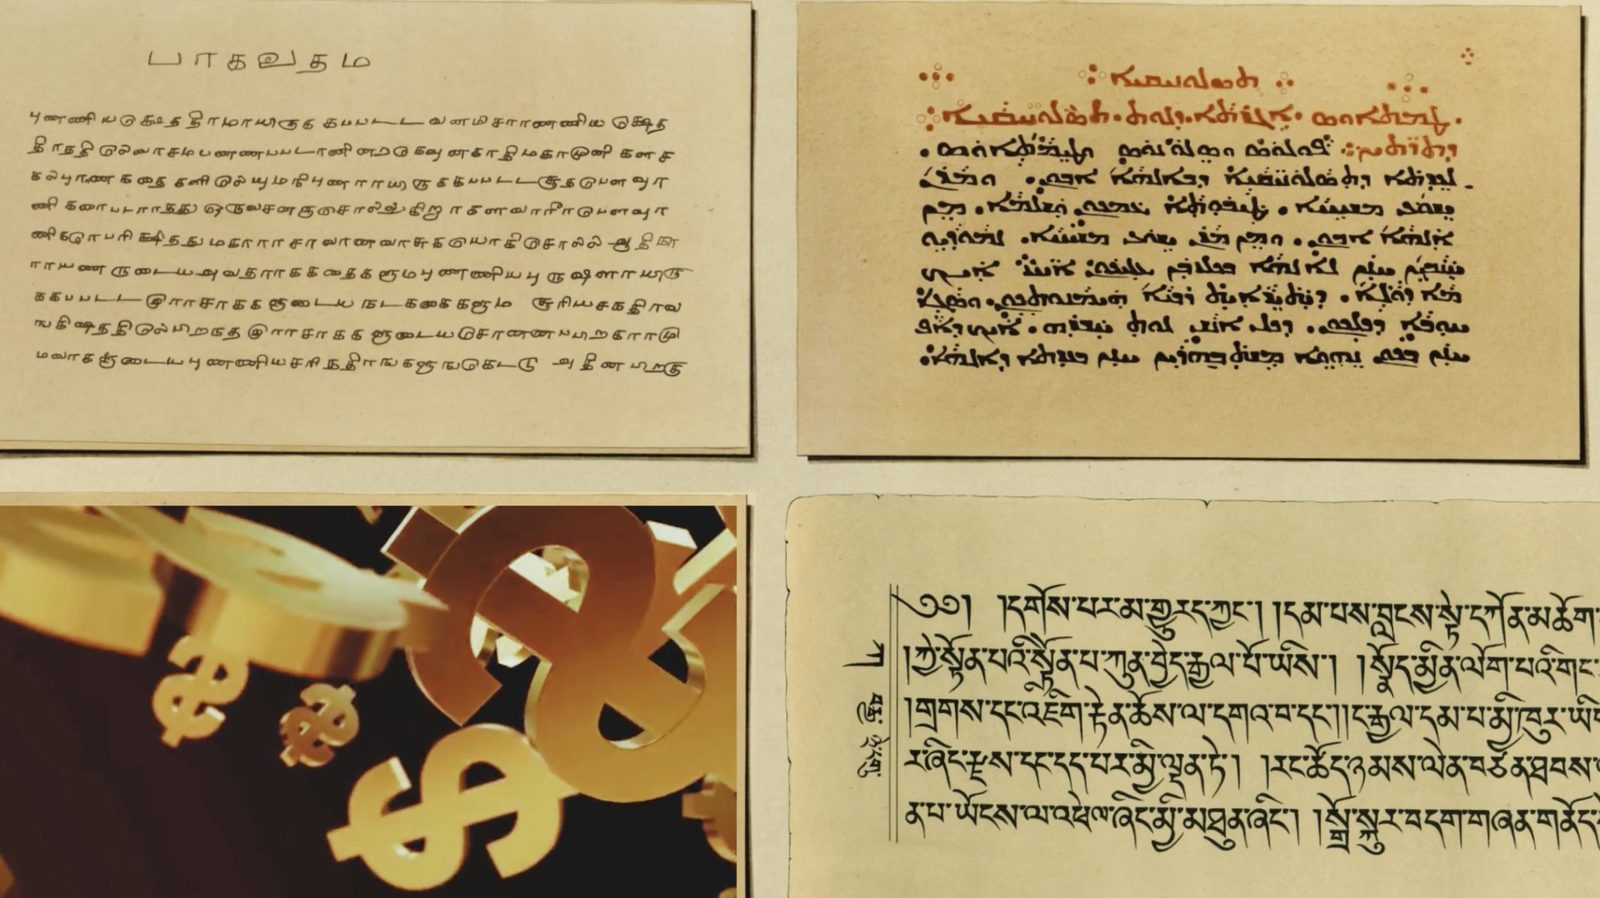
Токенізатори розбивають необроблений текст, зображення або аудіо на токени. У прикладі англійське речення розбили на впізнавані слова, тоді як те саме речення малаялам розбили на кілька фрагментів на слово без урахування багатобайтових символів. Навіть серед 20 найпопулярніших мов інтернету дослідження виявило розрив у використанні токенів: найдорожча з цих мов використовувала від 1,5 до 5 разів більше токенів, ніж найдешевша. Коли набір розширили до 200 мов, розрив у вартості токенів в одній моделі ШІ зріс у 17 разів. Дослідження зазначило, що стартап у Бенгалуру може платити надбавку за кожен запит і відповідь, тоді як його конкурент в Остіні не платить надбавку.
Вартість не є єдиним недоліком
Більша кількість токенів також означає вищу затримку та меншу ефективну ємність контексту, зазначило дослідження. Неангломовні мови залишають менше місця для документів або історії розмови і вимагають більше роботи для створення відповіді, за словами Пратюша Чоудхурі, співзасновника Activate AI. Він порівняв проблему з репетитором, який запам'ятовує попередні помилки й пояснення учня: якщо ця історія заповнює вікно контексту набагато швидше однією мовою, то недолік впливає на якість послуги. Дослідження зазначило, що ці покарання найсильніше б'ють там, де обчислювальні ресурси й зв'язок уже обмежені, і що нерівність токенізаторів обмежує участь в економіці ШІ.
Писемність, дані та дизайн мають значення
Рідкість мови не є єдиним чинником використання токенів; велику роль відіграє писемність. Астурійська, яка має відносно мало носіїв і відсутня в Common Crawl, отримує перевагу латинської писемності та представлення від споріднених романських мов, таких як італійська. Мови, записані писемностями, які токенізатори рідко бачили, зокрема бірманська, тибетська, тифінаг, кхмерська, лаоська та ол-чикі, були в найбільшому несприятливому становищі майже в усіх моделях аналізу. Дгіманат Редді, генеральний директор Maya Research, сказав, що багато токенізаторів залишаються непропорційно оптимізованими для англійської та інших мов з великою кількістю ресурсів, а основна проблема полягає в браку якісних цифрових даних. Один із способів покращити обробку мов: покращити вихідні дані. Рауль Нанаваті, співзасновник і генеральний директор Navana.ai, вказав на RESPIN, спільну ініціативу з Індійським інститутом науки, профінансовану Фондом Гейтсів, яка зібрала текст від носіїв 38 діалектів разом із прочитаним мовленням.
Як усунути розрив
Лише кращі навчальні дані не виправлять токенізатор, попередив Редді. Ціни на токени швидко падають, тож прямий вплив на вартість з часом має стати менш суворим, а кращі багатомовні та синтетичні дані мають покращити якість моделі. Але справжнє усунення прогалини в токенізації все одно вимагатиме, щоб лабораторії свідомо проєктували майбутні токенізатори для кращої роботи з цими мовами та писемностями. Чоудхурі сказав, що мовна ефективність має бути вимогою до продукту поряд із точністю, швидкістю та надійністю. Він сказав, що ідеальна рівність може бути нереалістичною, але великі стійкі нерівності мають вимагати пояснення та плану вдосконалення, і він закликав кожну велику лабораторію опублікувати таблицю оцінок за мовами, яка показувала б, скільки коштує успішно виконати порівнянні завдання, та взяти на себе зобов'язання щодо вимірюваних покращень для мов, які обслуговуються найгірше.
Джерела: Rest Of World · Techmeme
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.