Meta використовує простоюючі резервні GPU та контрольні точки, щоб підтримувати навчання ШІ в Prometheus
Meta заявляє, що понад 11 відсотків GPU у суперкластері Prometheus непрацездатні або стоять у резерві для захисту навчання ШІ. Компанія згадує контрольні точки, роботу над NVLink і менше перерв при масштабуванні до мільйона прискорювачів.
Резерв поглинає відмови
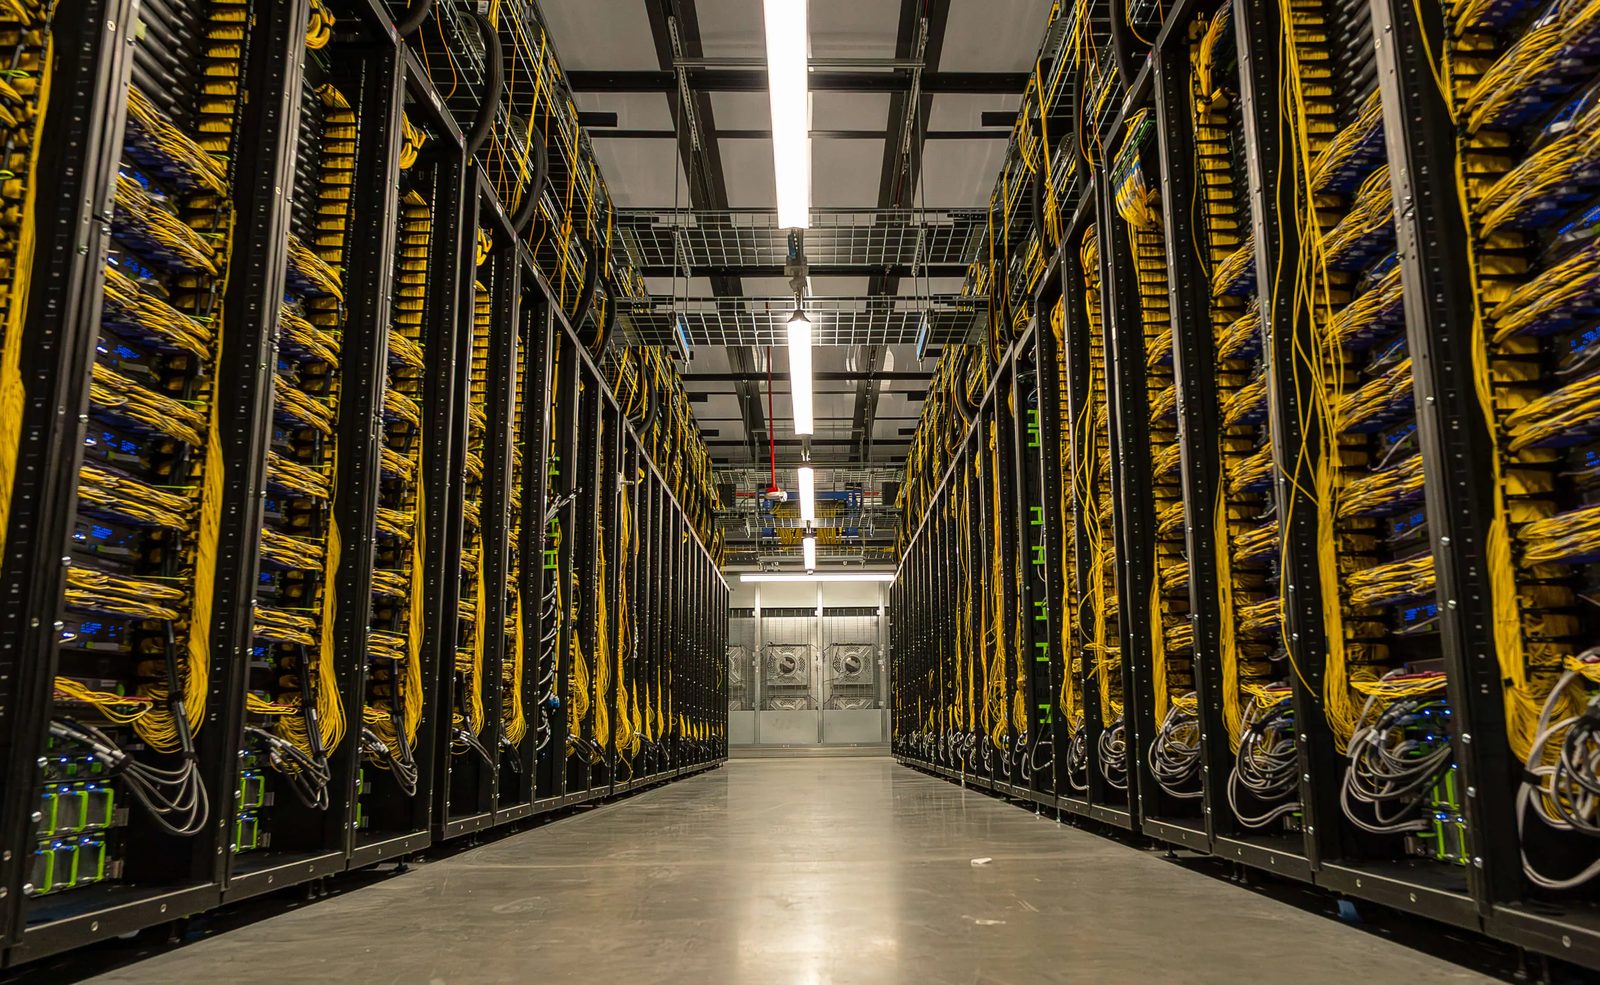
Meta заявила, що понад 11 відсотків GPU у її суперкластері Prometheus в Нью-Олбані, штат Огайо, непрацездатні або простоюють в очікуванні заміни відмовленого вузла. Резервний пул є частиною архітектури системи, яка, за словами Meta, з часом досягне потужності близько гігавата та близько мільйона прискорювачів, використовуючи стійкові системи Nvidia Grace Blackwell, а згодом і системи Vera Rubin.
Поточний кластер використовує системи GB200 та GB300 із 72 GPU в кожному домені NVLink, але в будь-який момент часу застосовуються лише 64. Інші вісім служать гарячим резервом. Meta заявила, що це важливо, оскільки один відмовлений GPU інакше міг би вивести з ладу всю стійку і перервати прогін навчання. За наявності резерву заміну можна встановити, хоча відмова все одно спричиняє коротшу перерву.
Коли Prometheus розпочав свою першу фазу, Meta заявила, що спостерігала приблизно 1000 перерв на день на кожні 8000 GPU. Перерва означає, що щось аварійно завершилося, вийшло з ладу або перевищило тайм-аут, і прогін навчання відкатувався до останньої відомої справної контрольної точки. Meta заявила, що приблизно за рік зменшила кількість перерв на 99 відсотків, до приблизно 11 на день на кожні 8000 GPU.
Контрольні точки обмежують відкат
Meta також описала, як ізолює збої всередині великих навчальних завдань, які використовують паралелізм даних, де кілька копій моделі розміщені в кластері. Якщо збій може бути ізольований в одній репліці моделі з паралелізмом даних, ця репліка переходить в автономний режим, тоді як решта кластера повторює крок і продовжує навчання. Ушкоджений зріз потім перезапускається на резервних хостах і повторно синхронізується, перетворюючи те, що могло б стати повною зупинкою, на тимчасове зниження сумарної пропускної здатності.
Якщо збій виходить за межі домену паралелізму даних, Meta покладається на контрольні точки. Компанія заявила, що її розподілена архітектура контрольних точок асинхронно зберігає стан моделі, включно з градієнтами та даними оптимізатора, на кілька рівнів сховища. Це дозволяє прогону відновитися зі збереженого стану, а не починати спочатку. Meta назвала цю роботу необхідною, щоб утримувати моделі, такі як Muse Spark і більш нова Muse Wonder, у графіку.
Зв'язки та живлення визначають масштаб
Однією з проблем було змушувати структури NVLink поводитися як один великий прискорювач. Meta заявила, що раніші системи H100 та H200 мали вісім GPU на один домен NVLink, тоді як Nvidia Blackwell збільшила це в дев'ять разів. Із понад 600 000 з'єднань NVLink навіть незначне погіршення сигналу викликало часті цикли відновлення. Meta заявила, що використовувала безперервну телеметрію та діагностичні прожиги L11, щоб виявляти слабкі зв'язки перш ніж системи вводилися в експлуатацію.
Енергоспоживання було ще однією проблемою. Meta заявила, що розгін і зупинка десятків тисяч GPU для прогону навчання можуть створювати великі перехідні процеси в енергоспоживанні, які можуть перевантажити обладнання електропостачання. Компанія заявила, що, віддаючи пріоритет стабільності та надійності кластера, досягла понад 85 відсотків goodput для попереднього навчання та понад 90 відсотків для навчання з підкріпленням на Muse Wonder. На майбутнє Meta хоче зменшити частоту перерв до двох на день на кожні 8000 GPU, або приблизно 100 000 годин GPU середнього часу між перервами.
Джерела: The Register
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.