لايا: محرك قرارات مفتوح بُني قبل عام من تسمية مختبر متقدّم الفكرة بالإنجاز الجديد
بعد أن أطلقت مختبرات ممولة جيدًا نموذجًا مشابهًا كإنجاز علمي، أصدر مهندس لايا: نماذج قرارات مفتوحة من نوع System 1 تعيد احتمالات معايرة خلال 32.8 ملي ثانية على معالج رسومي واحد.
أصدر مهندس نشر نماذج قرارات غير انحدارية قبل عام بديلًا مفتوحًا بالكامل، بعد أن قدّم مختبر متقدّم ممول جيدًا معمارية مشابهة كإنجاز علمي جديد.
فكرة عمرها عام تُقدَّم كجديدة
يكتب نانداكيشور موكونّوت، مؤسس ومدير ConvAI Innovations، أنه بنى المقاربة في آذار/مارس 2025: ورقة على arXiv عن مسارات التحويل التسلسلي، وأوزان النموذج ومجموعة بيانات مفتوحة على Hugging Face. وفي أيلول/سبتمبر 2026 أطلقت TypeSafe AI — التي أسّسها دييغو ألميدا، أحد مخترعي ChatGPT — نموذج Jev، الذي يصفه الكاتب بالتصور نفسه للقرارات غير الانحدارية، لكن من دون أوراق تقنية أو أوزان مفتوحة أو بيانات تدريب مفتوحة. يعتمد Jev على أخذ العينات بالتوازي بما يسميه RLCD، ويسعّر 0.042 دولار لكل مليون رمز إدخال، مع زمن استجابة نموذجي يقارب 150 ملي ثانية.
ما هي لايا
بدلًا من البقاء في المرارة، أعاد بناء الفكرة باسم لايا: محرك قرارات من نوع System 1 لا يولّد نصًا، بل ينتج توزيعات احتمالية فوق مخططات منظمة. ويجيب عبر ثلاثة عناصر: choice الذي يختار مفتاحًا واحدًا من قاموس ويعيد التوزيع وثقة معايرة؛ وscore الذي يضع مستندًا على سلّم ترتيبي مثل 0 إلى 3؛ وnoul وهو سؤال منطقي يعيد P(true). ولأن فضاء الخرج أرقام فقط، فالنموذج لا يمكنه الهلوسة ويستحيل إنتاج JSON مشوّه، بحسب الكاتب. وباستخدام مُرمِّزات ثنائية الاتجاه يجيب خلال 32.8 ملي ثانية على معالج رسومي واحد، أو 7.2 ملي ثانية لكل سؤال في الدفعات، وهو ما تقول الصفحة إنه أسرع بستة إلى ثمانية أضعاف من Jev، مع أوزان Apache 2.0 ومن دون تكلفة API.
ثلاث نقاط حفظ وموجّه
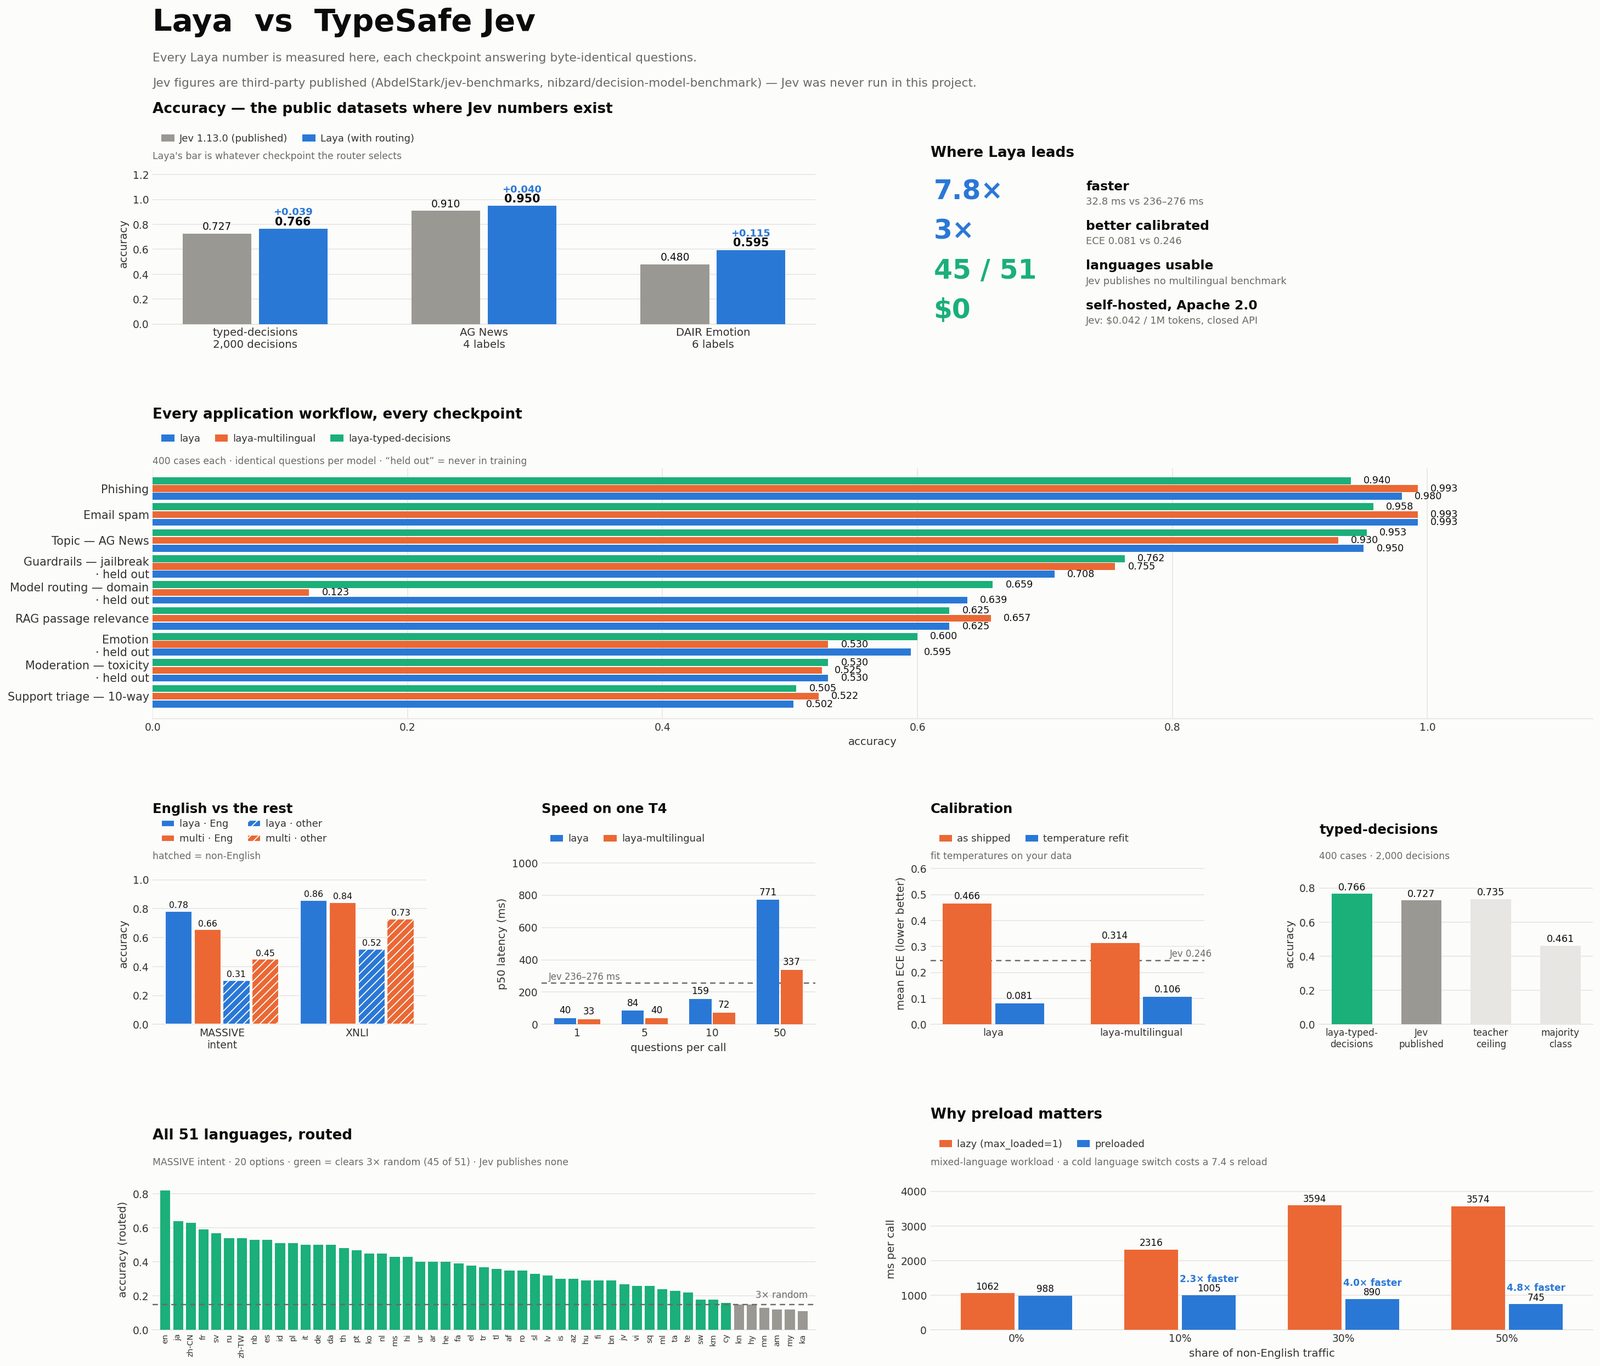
تضم العائلة ثلاث نقاط حفظ في مستودع واحد على Hugging Face: laya (ModernBERT-large، 421 مليون معامل، سياق 512 رمزًا) لتصنيف النصوص الإنجليزية وفرز البريد؛ وlaya-multilingual (mmBERT-base، قاموس من 256 ألف رمز، 322 مليون معامل) لأكثر من 100 لغة؛ وlaya-typed-decisions لسيناريوهات الوكلاء بدقة 0.766. وأظهر مسح لـ51 لغة في اختبار MASSIVE كيف تنهار النماذج الإنجليزية خارج الكتابة اللاتينية: في الخميرية حقّق النموذج دقة 0.000 بثقة متوسطة 0.952. ولم تنزل الثقة يومًا عن 0.885 سواء كانت الدقة 82% أو صفرًا، لذا لا يحمي الفلترة بالثقة، ويجب اتخاذ قرار التوجيه قبل التمرير الأمامي. ويفحص موجّه لايا كتابات يونيكود في 22 أبجدية مضيفًا 0.09 ملي ثانية للإنجليزية و0.54 ملي ثانية للكتابات الهندية و0.73 ملي ثانية لملفات JSON المتداخلة الكبيرة.
الاختبارات وحدود صريحة
في الاختبارات المشتركة يسجّل النظام الموجَّه 0.950 مقابل 0.910 لـJev في AG News، و0.595 مقابل 0.480 في DAIR Emotion، وخطأ معايرة متوقع 0.081 مقابل 0.246، وزمن استجابة وسيط 32.8 ملي ثانية مقابل 236–276. وتسرد الصفحة أيضًا السقوف: تتراجع مخططات choice فوق 20 خيارًا — ففي Banking77 بـ77 تصنيفًا حصلت لايا على 0.425 مقابل 0.870 لـJev؛ وتستقر النماذج الأساسية عند نحو 0.35 قبل الضبط الدقيق؛ ومعايرة قيمة حرارة واحدة لكل نوع سؤال تخفض خطأ المعايرة من 0.466 إلى 0.081.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.