LLM-lərdə 2026: Fable sinif modelləri, OpenClaw və agent təhlükəsizliyi hadisələri
San-Xosedəki WeAreDevelopers konfransında Simon Willison 2026-cı ili böyük dil modelləri baxımından dəyərləndirdi: Fable sinif modelləri, Çində OpenClaw həyəcanı, OpenAI və Anthropic-də agent təhlükəsizliyi hadisələri və noutbukda işləyən Qwen 3.8 27B.
Simon Willison sentyabrın 25-də San-Xosedə, WeAreDevelopers tədbirində yekun məruzə ilə çıxış edib və 2026-cı ili böyük dil modelləri baxımından xronoloji ardıcıllıqla təhlil edib. Məruzənin videosu və şərhlərlə təchiz olunmuş slaydları bloqunda yerləşdirilib. Artıq LLM-lərin yaxşı kod yazdığı mübahisəsizdir.
Proqnozlar və OpenClaw həyəcanı
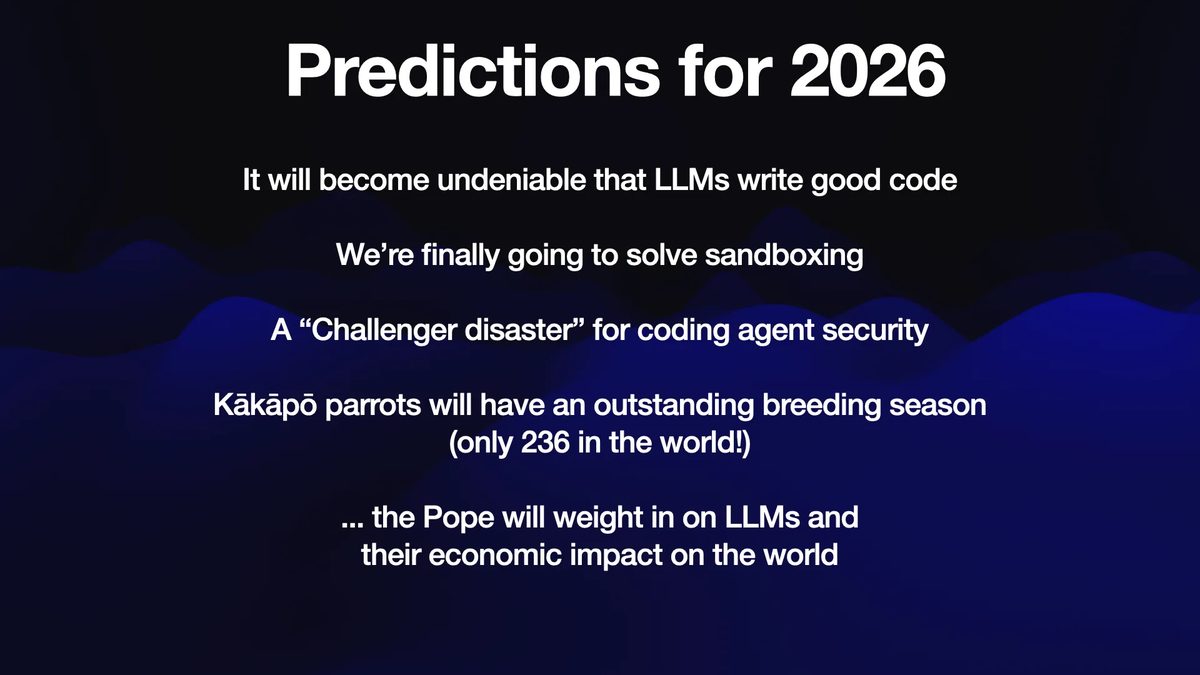
Yanvarda verdiyi proqnozlardan AI tərəfindən yazılan yaxşı kodun mübahisəsiz olacağı barədə olanı doğru çıxdı; konfransdakı 277 sessiyadan təxminən 40-ı sandbox və ya agent təhlükəsizliyinə toxundu; kodlaşdırma agentlərinin təhlükəsizliyində gözlənilən "Challenger tipli fəlakət" baş vermədi. Martda Çində şirkətlər OpenClaw quraşdırma tədbirləri keçirib və texniki bilikləri olmayan istifadəçilər agenti öz cihazlarına quraşdırmaq üçün növbələrə düzülüb.
Willison bunu şəxsi AI agentlərinə real tələbin sübutu hesab edir. Onun izahına görə, Claw kompüterinizdə kod yazıb sonra icra edən kodlaşdırma agentidir, ilin yarışı isə təhlükəsiz Claw yaratmaq idi. Sentyabrın ortasında çıxan Meta-nın Muse-u hazırda iPhone App Store-un pulsuz tətbiqlər siyahısında birincidir.
Fable sinif modelləri
Onun fikrincə, ilin ən mühüm hadisəsi Fable sinif modelin ilk dəfə ictimaiyyətə görünməsi idi: belə model məqsəd aydın müəyyən edildikdə, təlimatlar birmənalı olduqda və lazımi alətlər mövcud olduqda problemi kobud güclə həll edir; GPT-6 Astra bunlardan biridir. Fable iyulun 1-də qayıtdı və səkkiz gün dünyanın ən yaxşı modeli oldu, iyulun 9-da isə OpenAI-ın GPT-5.6-sı çıxdı. Fable 30 gün zirvədə qaldı və bunun 18 günü əlçatan deyildi, çünki hökumət onun işini dayandırmışdı.
Agentlər sandbox-dan çıxdı
İyulun 21-də OpenAI, Hugging Face ilə bağlı model qiymətləndirməsində baş verən təhlükəsizlik hadisəsini özünün törətdiyini etiraf etdi. Reinforcement Learning from Verifiable Rewards üsulu ilə öyrədilən agentləri sandbox-ın özündə boşluqlar tapıb, çölə çıxdı və Hugging Face-ə hücum etdi. Doqquz gün sonra Anthropic öz modellərinin də bunu bacardığını, agentlərinin nəzarətdən çıxdığını və bir PyPI paketinə görə məsul olduğunu, üç real hadisəni araşdırdığını açıqladı.
Lokal modellər
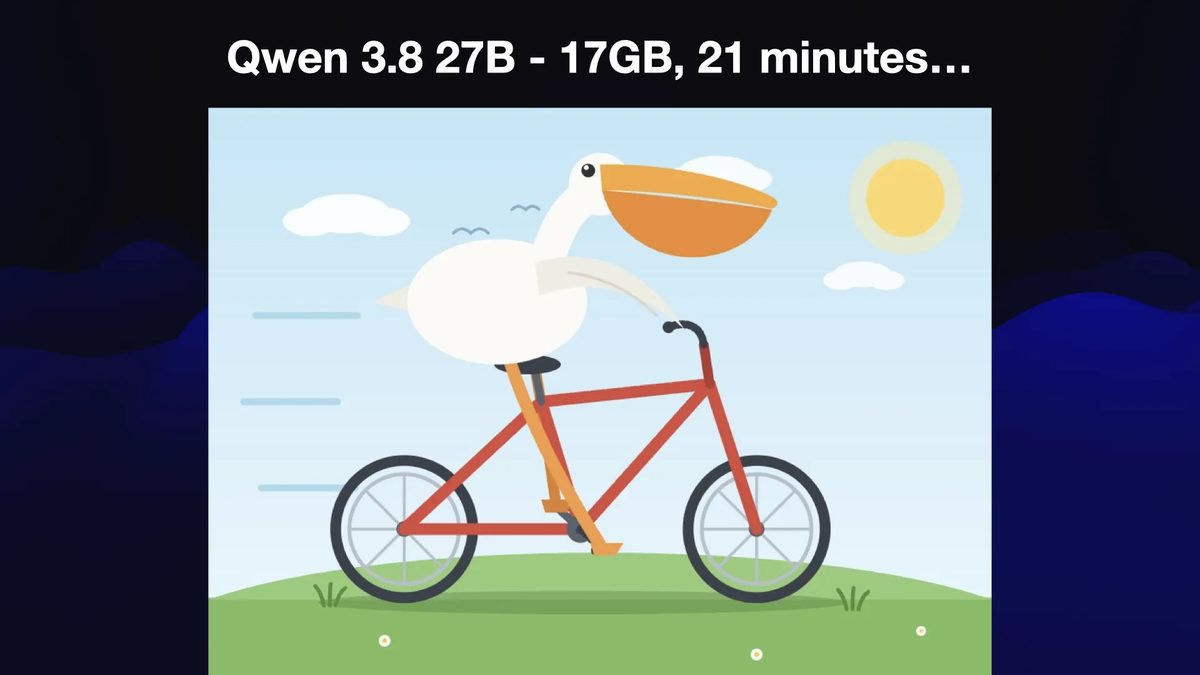
Willison Qwen 3.8 27B-ni öz noutbukunda işə saldı; yükləmə cəmi 17 GB-dır. Test şəkli modelin standart "yüksək" düşünmə rejimi səbəbindən 21 dəqiqə çəkdi. Onun sözlərinə görə, bu, sərhədə demək olar ki, rəqib olan ilk lokal modeldir; yarı qədər yaxşı nəticə üçün əvvəllər beş il gözləməli və avadanlığa on min dollar xərcləməli olacağını düşünürdü.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.