Liquid AI vizual-dil modellərini sürətləndirən DSpark draft modelini təqdim edib
Liquid AI LFM2.5-VL-3B vizual-dil modeli üçün eksperimental DSpark draft modelini təqdim edib: spekulyativ dekodlaşdırma cihazda 3,13 dəfəyə, H100-də isə 2,66 dəfəyə qədər sürətlənmə verir və çıxış keyfiyyətini dəyişmir.
Liquid AI sentyabrın 24-də vizual-dil modeli LFM2.5-VL-3B üçün eksperimental DSpark draft modelini təqdim edib. O, yaddaşda kiçik artım müqabilində nəzərəçarpan sürətlənmə verən spekulyativ dekodlaşdırma yolu əlavə edir; çıxış keyfiyyəti dəyişmir.
Draft modeli nə verir
Liquid AI-ın ölçmələrinə görə, dekodlaşdırma cihazda 3,13 dəfəyə, H100-də isə 2,66 dəfəyə qədər sürətlənir; başdan-başa gecikmə 2,62 və 2,27 dəfəyə qədər azalır. Model hədəfə 280 milyon parametr, yəni 3B modelin üzərinə 8,9% əlavə edir; llama.cpp, MLX-VLM və SGLang dəstəyi ilk gündən mövcuddur.
Vizual modellərdə spekulyativ dekodlaşdırma necə işləyir
Vizual draft modeli mətn əsaslı LFM2.5-DSpark modelləri ilə eyni arxitekturadan istifadə edir: hədəf modelin gizli vəziyyətlərini müəyyən laylarda oxuyub k namizəd tokenlik blok təklif edir. Şəklin hissələri və mətn tokenləri ortaq təsvirə çevrilir, buna görə model eyni ölçülü vektorlarla işləyir.
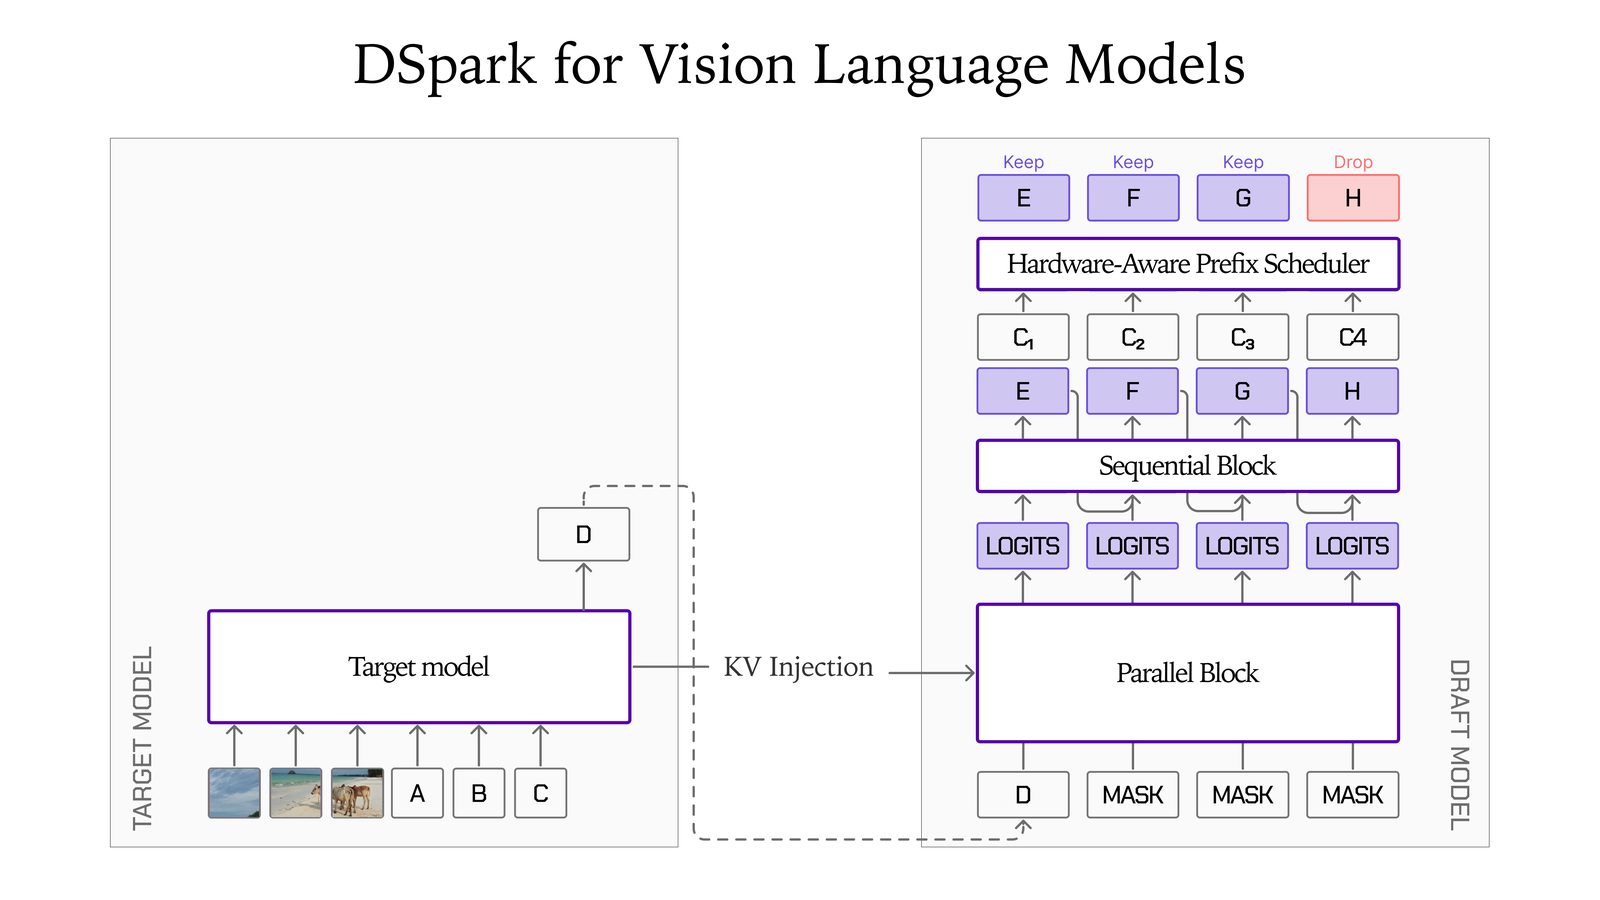
Təlim DSpark reseptinə uyğun, vizual-dil SFT məlumatları əsasında aparılıb: 3, 4 və 5 laylı variantların müqayisəsindən sonra diqqət mexanizminə əsaslanan 4 laylı draft modeli və 9 ölçülü blok seçilib. Model təqribən 279,5 milyon parametrdən ibarətdir.
Cihazda və H100-də sürətlənmə
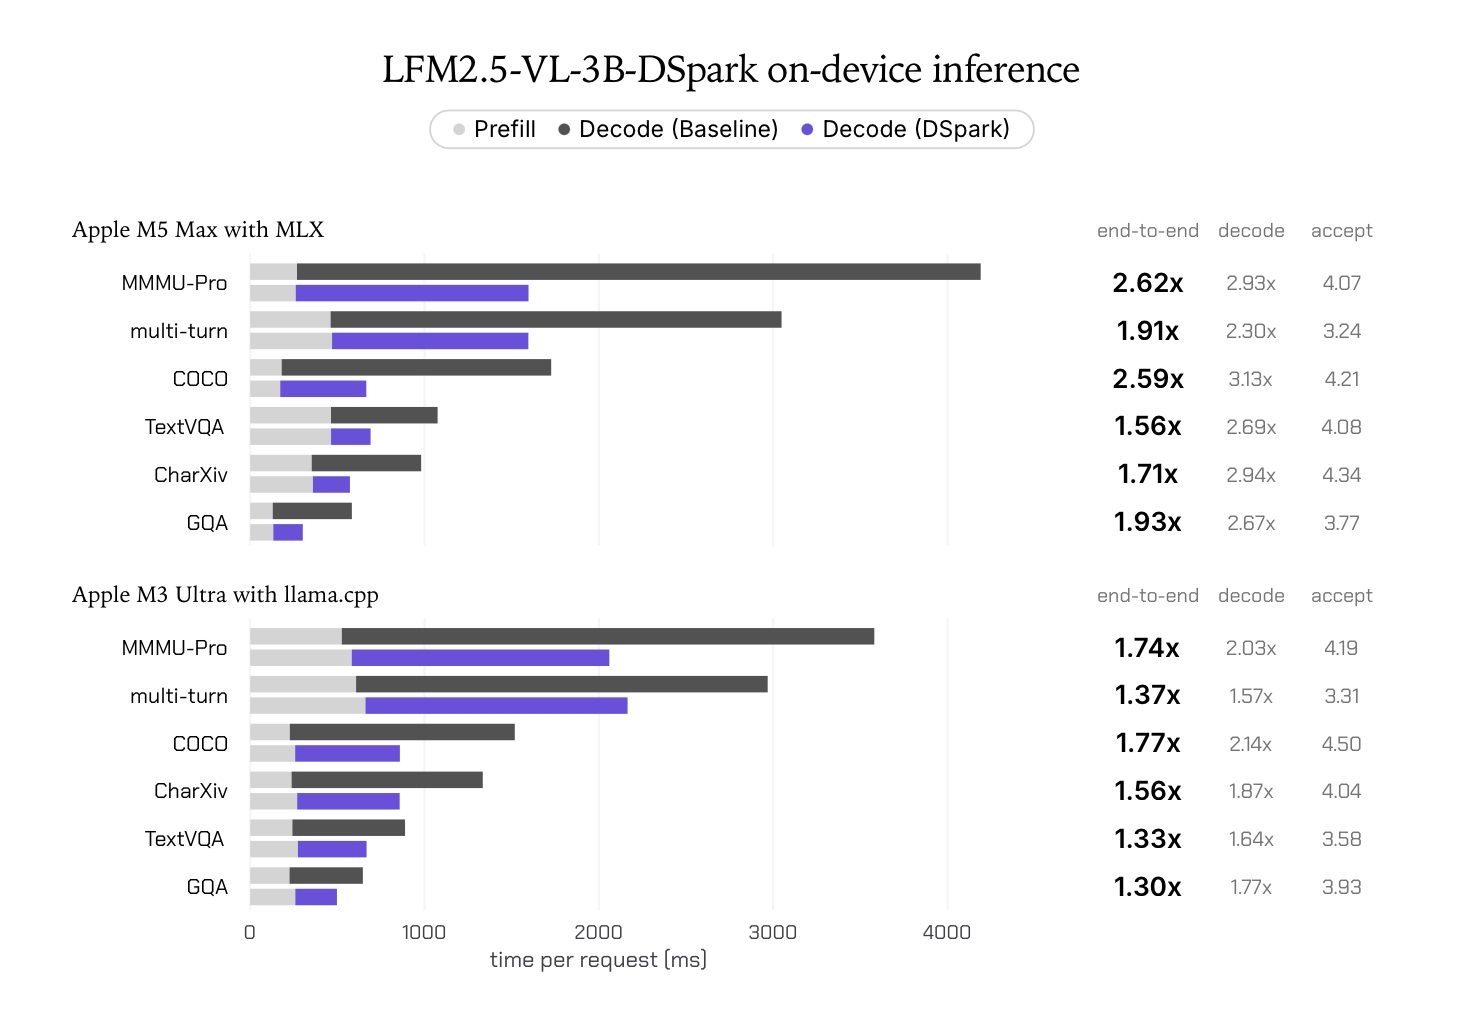
Ölçmələr 8 blok ölçüsü ilə MMSpec benchmarkına uyğun altı vizual tapşırıq üzərində aparılıb. M5 Max-da MLX ilə dekodlaşdırma 2,30 ilə 3,13 dəfə arasında sürətlənib, başdan-başa gecikmə 1,56 ilə 2,62 dəfə arasında yaxşılaşıb. M3 Ultra-da llama.cpp ilə dekodlaşdırma 1,57 ilə 2,14 dəfə, ümumi vaxt isə 1,30 ilə 1,77 dəfə yaxşılaşıb. H100-də dekodlaşdırma 2,66 dəfəyə qədər sürətlənir, gecikmə 1,64 ilə 2,27 dəfə arasında azalır.
Spekulyasiyanın kömək etmədiyi yer
Spekulyativ dekodlaşdırma yalnız dekodlaşdırmanı sürətləndirir, şəkil kodlaşdırmasını yox. Şəkil əvvəlcə vizual kodlayıcıdan keçir, sonra dil bazası yüzlərlə vizual tokeni sorğu ilə birlikdə emal edir; zəif cihazlarda bu mərhələ gecikmənin böyük hissəsini tutur. Bu mərhələlər vaxtın əhəmiyyətli hissəsini artıq sərf edirsə, dekodlaşdırmadakı böyük sürətlənmə belə başdan-başa ölçülü qazanc verir. Liquid AI bunu Amdahl qanunu ilə izah edir.
Draft modeli Hugging Face-də Safetensors və GGUF formatlarında təqdim olunur; llama.cpp, MLX-VLM və SGLang üçün DSpark dəstəyi olan buraxılışlar tələb olunur. Spekulyativ dekodlaşdırma dəqiqdir: hədəf model hər təklif olunan tokeni yoxlayır, buna görə tamahkar rejimdə nəticə hədəf modelin təkbaşına çıxışı ilə üst-üstə düşür.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.