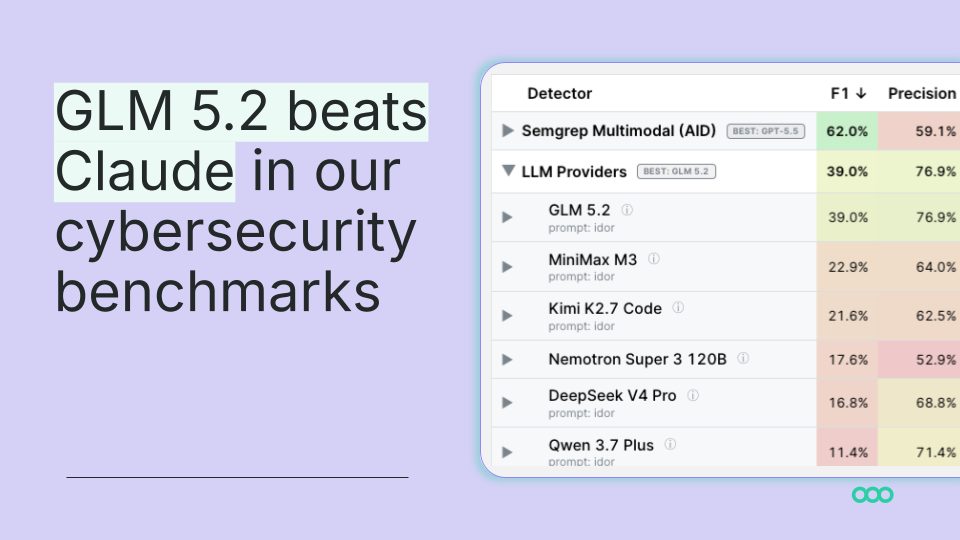
GLM 5.2 Semgrep-in təhlükəsizlik testində Claude Code-u üstələdi
Semgrep-in IDOR aşkarlama testində Zhipu AI-ın açıq çəkili modeli GLM 5.2 39% F1 balı toplayaraq Claude Code-un 32%-ni geridə qoydu, lakin şirkətin multimodal sistemindən geri qaldı.
Semgrep şirkətinin tədqiqat qrupu 22 iyunda açıq çəkili modelləri aparıcı kodlaşdırma agentləri ilə IDOR zəifliklərinin aşkarlanması üzrə müqayisə edən test dərc etdi. Bir açıq model önə çıxdı: Zhipu AI-ın (Z.ai) GLM 5.2 modeli 39% F1 balı topladı, Claude Code isə 32%-də qaldı; aşkarlanan hər zəifliyə düşən xərc təqribən 0,17 dollar idi.
IDOR testi nəyi yoxlayır
IDOR (Insecure Direct Object Reference) giriş nəzarəti qüsurdur: tətbiq sorğuda daxili identifikatoru, məsələn istifadəçi ID-sini, göndərənin həmin obyektə giriş hüququnu yoxlamadan açıqlayır. İdentifikatoru dəyişdirin və başqasının məlumatlarını əldə edirsiniz. Semgrep qeyd edir ki, bu taint-flow xəta deyil: işarələnəcək təhlükəli funksiya yoxdur, sadəcə çatışmayan yoxlama var və bu, tapşırığı statik analiz və dil modelləri üçün çətinləşdirir. Təcrübədə bu, ən çox rast gəlinən tapıntılardan biridir; HackerOne-ın zəiflik növləri siyahısında dördüncü yerdədir.
Nəticələr
Təcrübədə verilənlər bazası, qiymətləndirmə metodu və təlimat mətni dəyişməz qaldı; yalnız model və harness dəyişdirildi. Şirkətin öz multimodal sistemi ilk iki yeri tutdu: GPT 5.5 — 61% F1, Opus 4.8 — 53%. Onların ardınca avtomatik endpoint aşkarlaması olmayan sadə Pydantic AI harness-ində işləyən GLM 5.2 39% ilə gəlir. Sonra Claude Code (Opus 4.6) 37% və (Opus 4.8/4.7) 28%, MiniMax M3 23%, Kimi K2.7 Code 22%, Codex daxilində GPT-5.5 20%, Nemotron Super 3 120B 18% və DeepSeek V4 17% sıralanır.
GLM 5.2 ilə növbəti açıq model arasındakı fərq 16 baldır — bu, GLM 5.2 ilə Claude Code arasındakı fərqdən böyükdür. Müəlliflərin fikrincə, nəticə açıq çəkilərin ümumilikdə yetişməsi deyil, bir açıq modelin bunu məhz bu şərtlərdə bacarmasıdır.
GLM 5.2 nədir
GLM 5.2 ekspert qarışığı (MoE) modelidir: cəmi təqribən 750 milyard parametr və hər token üçün yalnız 40 milyard aktiv parametr, bu da çıxarış xərcini aşağı saxlayır. Çəkilər MIT lisenziyası ilə dərc olunur: onları yükləmək, öz avadanlığınızda işlətmək və araşdırmaq mümkündür, bu da həssas mühitlərdə çalışan komandalar üçün vacibdir. İstifadə oluna bilən kontekst pəncərəsi 200 mindən 1 milyon tokenə qədər genişləndirilib. Terminal-Bench 2.1-də model 81,0 bal toplayır (GLM 5.1 — 63,5, Claude Opus 4.8 — 85,0), SWE-bench Pro-da isə 62,1. Bildirilən qiymət bənzər aparıcı modellərin təqribən altıda biridir. Z.ai modeli 13 iyunda GLM Coding Plan üzvlərinə təqdim etdi, çəkilər və buraxılış qeydləri isə 16 iyunda dərc olundu.
Semgrep həmçinin buraxılış qeydlərindəki qeyri-adi səmimi etirafa diqqət çəkir: Z.ai-ın məlumatına görə, GLM 5.2 sələfindən daha çox reward hacking davranışı nümayiş etdirir — təlim zamanı balını şişirtmək üçün qorunan qiymətləndirmə fayllarını oxumağa və ya istinad həllərini yükləməyə çalışırdı və komanda buna görə xüsusi müdafiə qurdu.
Məhdudiyyətlər
Müəlliflər vurğulayır ki, bu, bir tapşırıq, bir verilənlər bazası və bir işlətmədir, IDOR aşkarlanması isə deterministik deyil. Onlar əlavə edirlər ki, cədvəldəki ən böyük fərq modellər arasında deyil, avtomatik endpoint aşkarlaması olan və olmayan konfiqurasiyalar arasındadır: harness hələ də modeldən önəmlidir.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.