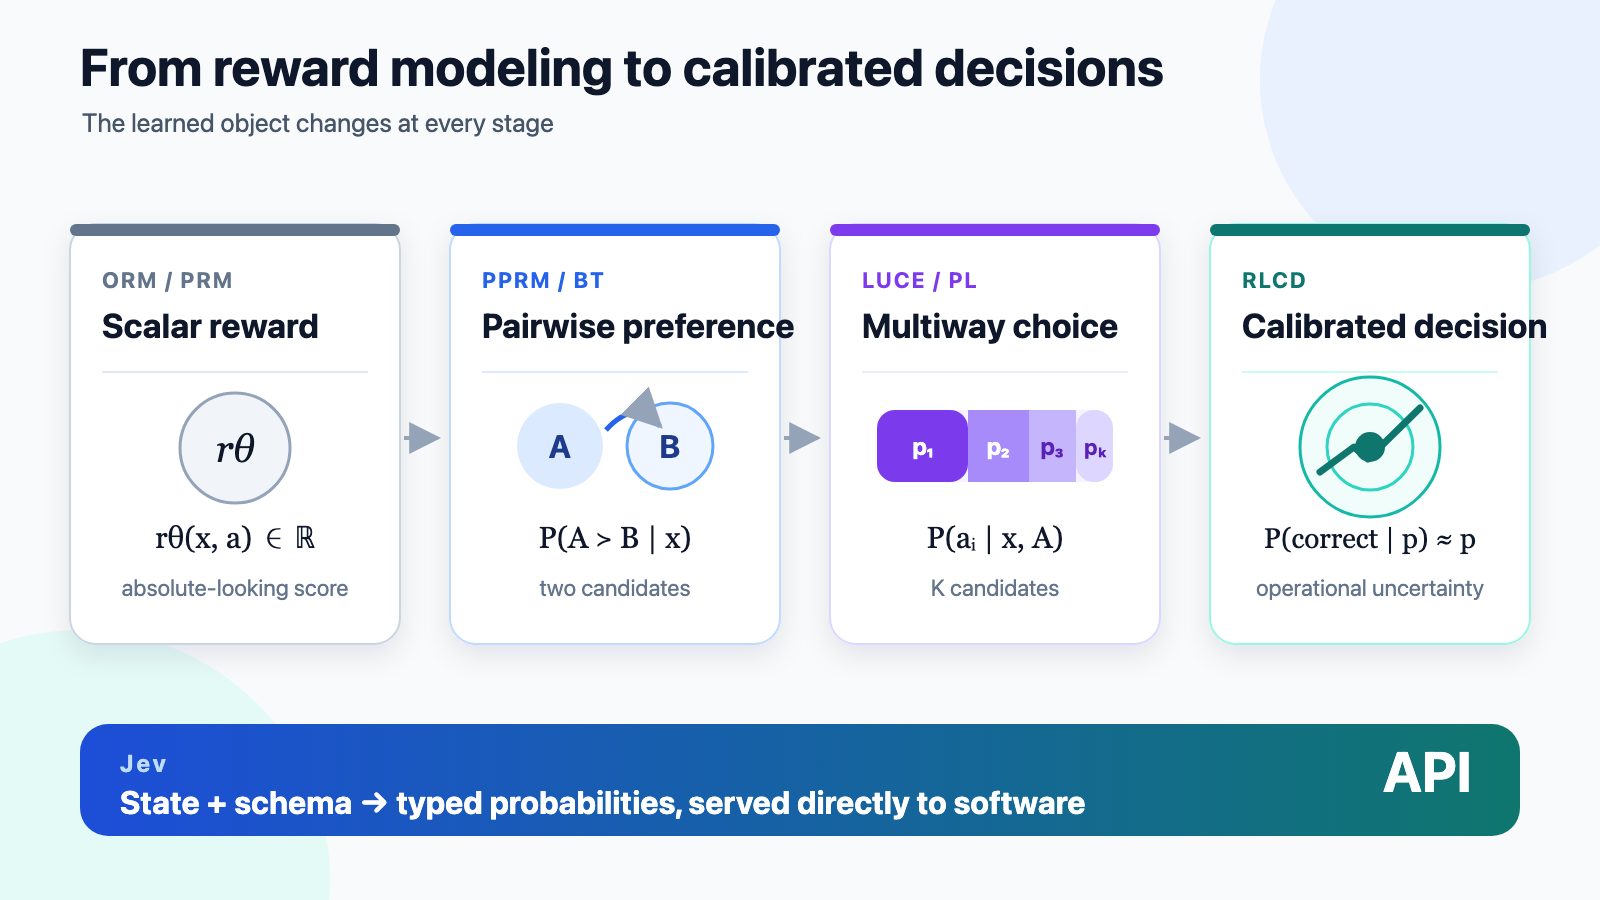
RLCD nədir? Jev-in arxasındakı kalibrlənmiş qərar modeli
RLCD çoxvariantlı üstünlük modelləşdirməsinə ehtimalların kalibrlənməsini əlavə edən, sxemlə şərtlənmiş Plackett-Luce hədəfidir. Texniki yazıya görə, Jev-in arxasındakı mükafat modeli artıq generatorun arxasında gizlənmir, məhsulun özünə çevrilir.
di-zhang-llm blogundakı texniki yazı RLCD-ni TypeSafe-in qərar modeli Jev-in arxasındakı sirr adlandırır: çoxvariantlı üstünlük modelləşdirməsi üstəgəl ehtimalların kalibrlənməsi, daha dəqiq desək, sxemlə şərtlənmiş Plackett-Luce hədəfi. Jev onu tipli çıxışlar və paralel inference ilə məhsula çevirir və mükafat modeli artıq generatorun arxasında gizlənmir: modelin özünə çevrilir.
Skalyar mükafatdan üstünlük ehtimalına
Klassik mükafat modeli kontekst və namizəd cavab üçün tək bir rəqəm qaytarır, lakin yazıya görə bu rəqəm mütləq deyil: 0,8 müxtəlif məsələlər və ya namizəd topluları üzrə sabit məna daşımır. LLaMA-Berry-nin Pairwise Preference Reward Model (PPRM) həqiqi siqnalı Bradley-Terry ehtimalı ilə açıq göstərdi və təxminən 7,8 milyon riyazi həll cütü ilə DPO vasitəsilə öyrədildi.
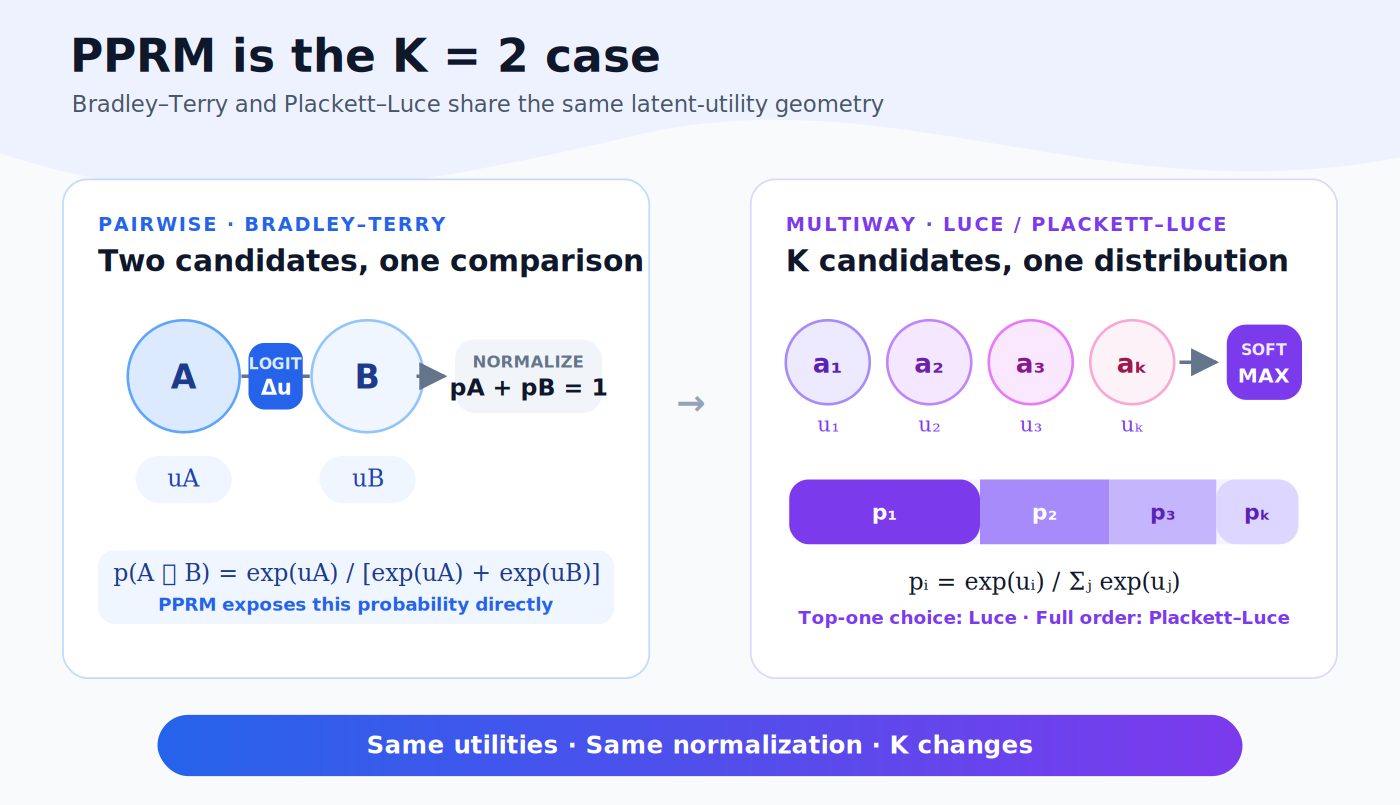
Plackett-Luce çoxvariantlı PPRM-dir
Qərar interfeysləri adətən ikidən çox namizəd görür. Luce seçim modeli, digər adı ilə multinomial logit, hər namizəd üçün faydanı normallaşdırır; iki namizəd olduqda isə dəqiq Bradley-Terry-yə qədər azalır. Tam sıralama verildikdə Plackett-Luce ehtimalı hər dəfə qalan ən yaxşı namizədi seçir və yazı bunu RLCD-nin riyazi mərkəzi adlandırır.
Kalibrlənmə paylanmanı qərara çevirir
Normallaşdırma kalibrlənmə deyil: softmax həmişə birə cəmlənir, lakin bu, 0,8 kimi bildirilən proqnozun 80% hallarda doğru olduğu demək deyil. Müqavilə belədir: 0,8 ehtimalı verilən proqnozların təqribən 80%-i doğru olmalıdır və yazıya görə TypeSafe Jev üçün eyni şeyi vəd edir.
Brier balı bu məqsədə qiymət qoyur: p=0,8 kimi bildirilən qərar hadisə baş verdikdə 0,04, baş vermədikdə 0,64 bal alır, yəni özündən əmin şəkildə səhv proqnoz on altı dəfə bahadır. Kalibrlənmiş inam proqramın qərarı icra etməsini və ya ötürməsini müəyyən edir.
Jev qiymətləndiricini interfeysə çevirir
Adi RLHF stekində mükafat modeli arxa planda, generatorun arxasında qalır. Jev bunu tərsinə çevirir: içinə vəziyyət və namizəd sxemi daxil olur, dışına qərarların kalibrlənmiş paylanması çıxır. Noul, Choice və Score eyni obyekt üzərində üç sxemdir: verilmiş vəziyyət, sual və namizəd çoxluğu üçün tipli nəticənin ehtimalı.
Yazı paralel inference iddiasını da açır: brendinqi kənara qoysaq, seçici sequence packing, attention mask və tipli qərar başlıqlarından ibarətdir, beləliklə bir forward pass bütün namizədləri token-token generasiya dövrü olmadan qiymətləndirir. Müəllifə görə TypeSafe yeni arxitektura elan edir, amma nə yeni attention operatoru, nə də ablasiya dərc edir.
Nəticədə RLCD-ni çıxış müqaviləsi müəyyən edir: tipli ehtimal paylanması. Jev mükafat modelinin məhsulu qiymətləndirməyi dayandırıb məhsulun özünə çevrildiyi haldır.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.