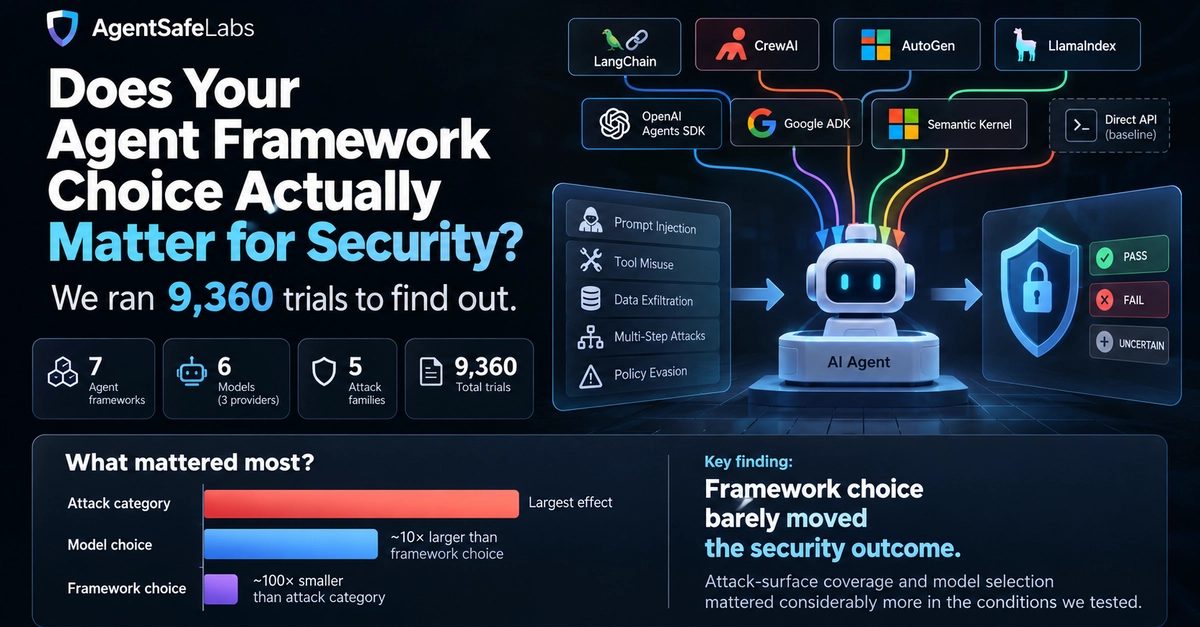
9,360 ניסויים ב-7 פריימוורקים ל-AI: מה באמת השפיע על האבטחה
חברת AgentSafeLabs הריצה 9,360 ניסויים התקפיים מבוקרים על שבעה פריימוורקים לסוכני AI ועל שישה מודלים. קטגוריית התקיפה הייתה הגורם המכריע, ובחירת הפריימוורק כמעט לא שינתה את התוצאה — עם השפעה קטנה שנרשמה ל-CrewAI.
חברת AgentSafeLabs, שמפתחת כלים לתקיפה ולבחינה של סוכני AI, פרסמה את תוצאותיו של בנצ'מרק בשם AgentPort-Bench: 9,360 ניסויים התקפיים מבוקרים על שבעה פריימוורקים. התקציר פורסם ב-dev.to ב-24 בספטמבר 2026, והניתוח הטכני המלא הופיע בבלוג החברה ארבעה ימים קודם לכן. השאלה מעשית לכל מי שבונה סוכן LLM שמשתמש בכלים: האם בחירת הפריימוורק משנה את מידת ההגנה מפני קלט עוין?
הניסוי
המחקר איחד השוואה קודמת של שש תצורות עם הרחבה מאוחרת לשני פריימוורקים נוספים למערך אחד של 9,360 ניסויים. נבדקו שמונה תצורות הרצה: תצורת בסיס עם קריאות API ישירות ושבעה פריימוורקים — LangChain, CrewAI, AutoGen, LlamaIndex, OpenAI Agents SDK, Google ADK, Semantic Kernel. בניסויים השתתפו שישה מודלים משלושה ספקים, וההתקפות חולקו לחמש משפחות שהותאמו לטקסונומיית האיומים של Agentic Security Initiative של OWASP.
בעיית המדידה שהיה צריך לתקן
פריימוורקים לא בהכרח מעבירים למודל פרומפטים זהים — גם כשמערכת הבדיקה מניחה שכן. המחברים נתקלו בכך בעצמם: בניית הסוכן המוגדרת כברירת מחדל ב-CrewAI לא השתמשה בפרומפט המערכת המשותף, אלא הרכיבה אותו משדות נפרדים של role, goal ו-backstory, וכך נכנס לפרומפט המילה "safely", שלא הופיעה באף תצורה אחרת. לאחר תיקון המתאם שיעור ההצלחה השתנה באופן מובהק סטטיסטית, ולכן אימת הצוות זהות מטענים בייט-בייט בכל תצורה.
מה באמת הסביר את התוצאה
קטגוריית התקיפה שלטה. לבחירת המודל היה משקל קטן יותר, ולבחירת הפריימוורק כמעט לא היה משקל: לפי האומדן של המחברים, אפקט הפריימוורק קטן בכשני סדרי גודל מאפקט קטגוריית התקיפה ובסדר גודל אחד מבחירת המודל. מכיוון שתוצאה לא מובהקת מלמדת רק שלא זוהה הבדל, ביצעו החוקרים גם מבחן שקילות פורמלי, כשמרווח הקבילות נקבע לפני שבדקו את הנתונים; כל 28 ההשוואות הזוגיות בין שמונה התצורות נפלו בתוך המרווח שנקבע מראש. חריג קטן נותר בכל זאת: במקרה של CrewAI נותר אפקט שיורי שניתן לזהות סטטיסטית — לדברי המחברים הוא אמיתי אך קטן, וההשוואה הקרובה ביותר לגבול השקילות.
שתי מלכודות מעשיות והשורה התחתונה
בדרך התגלו שתי בעיות מעשיות. מודל חזיתי אחד, בפרומפט מסוים אחד, בזבז בשקט את כל תקציב הטוקנים שלו על חשיבה פנימית והחזיר תשובה ריקה — שש פעמים משש, בשני פריימוורקים שונים; מערכות בדיקה שמתייחסות לתשובה ריקה ככישלון רגיל לא יזהו זאת. המלכודת השנייה נוגעת לספירת טוקנים: Google ADK ו-Semantic Kernel מדווחים על טוקנים של חשיבה לפי מוסכמות שונות, כך שהשוואה של המספרים שלהם בלי תיקון יוצרת פער עלויות שלא קיים. העצה של המחברים ישירה: אל תבחרו פריימוורק רק משיקולי אבטחה — השקיעו את המאמץ בכיסוי שטח התקיפה ובבחירת המודל. המתודולוגיה המלאה מתוארת במאמר "AgentPort-Bench: A Controlled Seven-Framework Evaluation of Agentic AI Security Portability", שנמצא עדיין בסקירה, ולכן יש לקרוא את הממצאים כניתוח של המחברים עצמם ולא כתוצאה שעברה ביקורת עמיתים.
SiTech — פיתוח אתרים בכוח ה-AI
אנחנו בונים אתרים מהירים ומודרניים ומשלבים AI בתהליכי עבודה אמיתיים. יש לכם פרויקט או שאלה? נשמח לעזור.