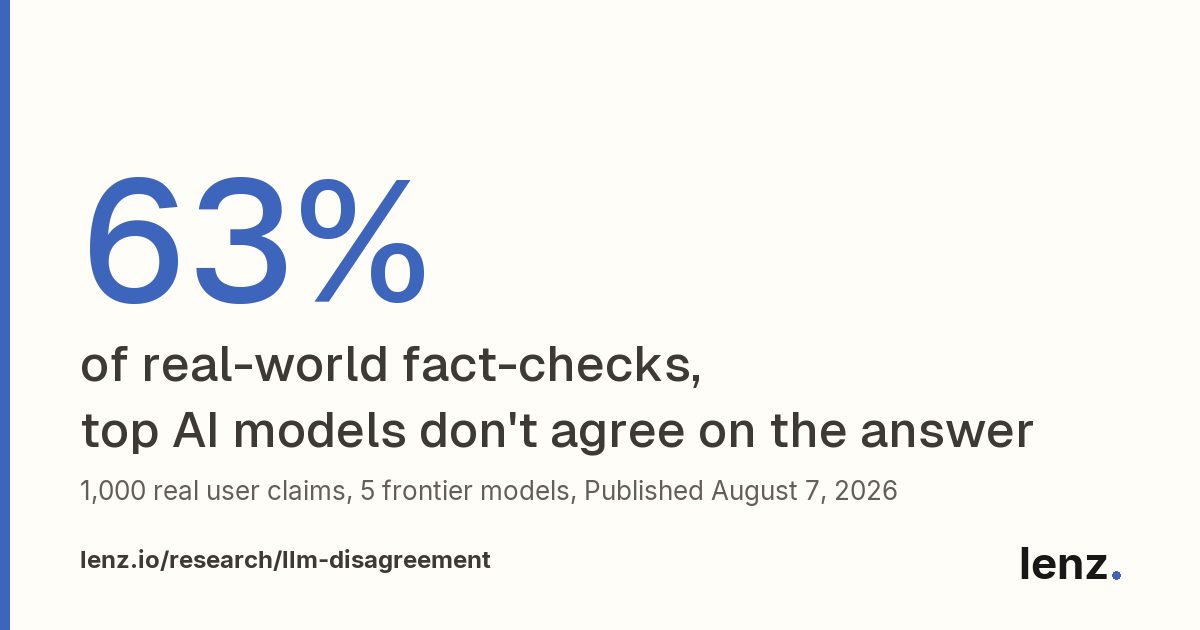
Հետազոտություն. ֆրոնտիեր LLM-ները տարաձայնվում են իրական փաստերի 67%-ում
Lenz-ը հինգ առաջատար մոդելի տվել է օգտատերերի 1000 իրական պնդում. դրանց 67%-ում պանելը բաժանվում է, 34%-ում գնահատականների միջև տարբերությունը հասնում է երկու և ավելի աստիճանի, այսինքն՝ առնվազն մեկ մոդել սխալվում է։
Փաստերի ստուգման Lenz հարթակը հրապարակել է ուսումնասիրություն այն մասին, թե որքան հաճախ են առաջատար ֆրոնտիեր լեզվական մոդելները տարաձայնվում իրական փաստերի գնահատման հարցում։ Ընկերությունը հինգ առաջատար մոդելի՝ GPT-5.4, Claude Opus 4.7, Gemini 3 Pro, որոնմամբ Gemini 3 Pro և Perplexity-ի Sonar Pro-ին տվել է օգտատերերի ներկայացրած 1000 վերջին պնդում և խնդրել ընտրել չորս գնահատականներից մեկը՝ ճիշտ, հիմնականում ճիշտ, ապակողմնորոշող կամ սխալ։
Պնդումների երկու երրորդում պանելը բաժանվում է
Պնդումների 67%-ում (1000-ից 672; 95% վստահության միջակայքը՝ 64-70) առնվազն մեկ մոդել չհամաձայնեց մեծամասնության գնահատականի հետ, կամ մեծամասնություն ընդհանրապես չձևավորվեց։ Եվս 34%-ում (343 պնդում) ամենաշատ տարաձայնվող զույգի միջև երկու կամ ավելի աստիճանի տարբերություն կար՝ սա էական տարաձայնություն է պատասխանի շուրջ, այլ ոչ թե պարզապես վստահության տատանում։
Մոդելների միջև համաձայնությունը էական էր, սակայն սահմանափակ՝ Krippendorff-ի ալֆան դասակարգային սանդղակում կազմում է 0.639։ Պանելը համընկնում է միանշանակ գնահատականների վրա և բաժանվում սանդղակի մեջտեղում. 328 պնդումներից, որտեղ հինգ մոդելներն էլ համաձայնեցին, միայն չորսում էր միաձայնություն «ապակողմնորոշող» գնահատականի շուրջ և ոչ մեկում՝ «հիմնականում ճիշտ»-ի։
Որտեղ են մոդելները համընկնում
Ամենամոտ զույգը Gemini 3 Pro-ն ու նրա որոնմամբ տարբերակն էին, որոնք համընկնում էին պնդումների 75%-ում. հեղինակների կարծիքով դա զարմանալի չէ, քանի որ նրանք կիսում են նույն բազային մոդելը։ Ամենահեռու զույգերը՝ 53%-ով, Claude Opus 4.7-ն էր Gemini-ի երկու տարբերակների հետ և Gemini 3 Pro-ն Sonar Pro-ի հետ։ Պանելի մնացած մասի հետ համաձայնությունը տատանվում է 69%-ից 81%։
Քանի որ յուրաքանչյուր պնդման համար միայն մեկ գնահատական կարող է ճիշտ լինել, ուսումնասիրությունը տալիս է նաև սխալի ստորին սահման։ Եթե ենթադրենք, որ պանելի ամենահանրաճանաչ գնահատականը ճիշտ է՝ ամենամեղմ մեկնաբանությամբ, ապա առնվազն մեկ մոդել սխալվել է պնդումների 67%-ում, առնվազն երկուսը՝ 45%-ում, իսկ առնվազն երեքը՝ 13%-ում, որտեղ ոչ մի գնահատական մեծամասնություն չհավաքեց։
Ինչ չի պնդում ուսումնասիրությունը
Lenz-ը շեշտում է, որ մոդելների մեծամասնությունը ճշմարտության չափանիշ չէ. մեծամասնությունը երբեմն սխալվում է, իսկ տարաձայնվող մոդելը՝ երբեմն ճիշտ է, և ընկերությունը մեծամասնությունը օգտագործում է միայն որպես կառուցվածքային հղման կետ։ Lenz-ի սեփական գնահատականները վերլուծության մեջ չեն ներառվել։ Կորպուսից բացառվել են մասնավոր պնդումները, աշխատակիցների ներկայացրածները, գրեթե նույնական գրառումները և դեպքերը, երբ որևէ մոդել չի կարողացել վերլուծելի գնահատական տալ։
Սա սառեցված պատկեր է՝ տարբերակ 1.0, տվյալները՝ 2026 թվականի մայիսի 21-ի դրությամբ, և յուրաքանչյուր պնդման CSV ֆայլը հրապարակային է։ Հաջորդ ուսումնասիրությունը յուրաքանչյուր պնդում կնշի մարդկային գնահատականով և այդ գնահատականները կօգտագործի որպես հղման ճշմարտություն՝ քարտեզագրելու, թե որտեղ են ֆրոնտիեր պանելներն ու ինքը Lenz-ը շեղվում մարդկային կոնսենսուսից։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։