NVIDIA-ն և IIT Madras-ը թողարկել են 2,8 տրիլիոն տոկենի հնդկական նախնական ուսուցման կորպուս
NVIDIA-ն, IIT Madras-ը և AI4Bharat-ը հրապարակում են Nemotron-pretraining-Indic-v1-ը՝ մոտ 2,8 տրիլիոն տոկեն պարունակող կորպուս՝ 22 հնդկական լեզուներով, և բաց, GPU-արագացված կոնվեյեր, որով այն ստեղծվել է։
Կորպուս՝ 22 հնդկական լեզուների համար
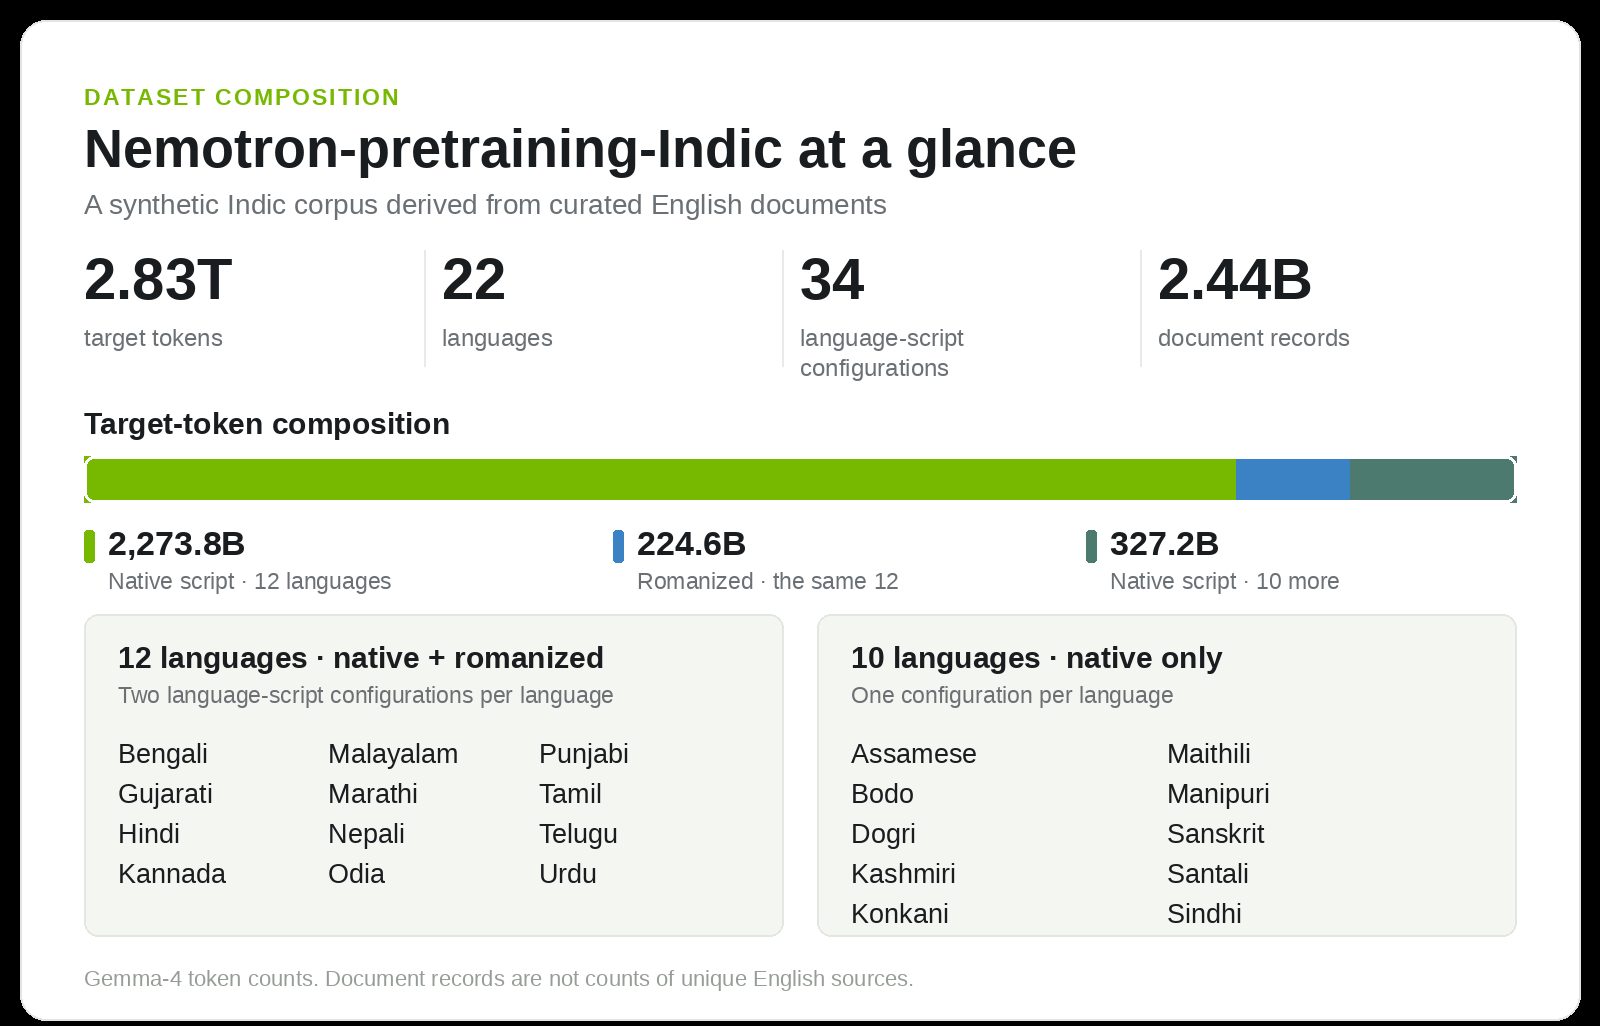
NVIDIA-ն IIT Madras-ի և դրա AI4Bharat լաբորատորիայի հետ միասին ներկայացրեց Nemotron-pretraining-Indic-v1-ը՝ նախնական ուսուցման կորպուս, որը պարունակում է մոտ 2,8 տրիլիոն տոկեն Հնդկաստանի սահմանադրությամբ նշված 22 լեզուներով։ Թողարկումը նաև ներառում է բաց, GPU-արագացված տվյալների ստեղծման կոնվեյեր, որն օգտագործվել է այն ստեղծելու համար և ընդգրկում է թարգմանություն, որակի գնահատում և ուղղում։
Կորպուսը պարունակում է 2 601,0 միլիարդ տոկեն մայրենի գրային համակարգում և 224,6 միլիարդ ռոմանիզացված տոկեն Gemma-4 տոկենայիզերով հաշվարկված։ Այն ընդգրկում է լեզու-գիր 34 կոնֆիգուրացիա՝ մայրենի գրային համակարգի տվյալներ բոլոր 22 լեզուների համար և ռոմանիզացված տեքստ դրանցից տասներկուսի համար։ Յուրաքանչյուր գրառում կապված է կուրացված սկզբնաղբյուր փաստաթղթի հետ, և յուրաքանչյուր արդյունք ստուգվում է իր մուտքագրման հետ, որպեսզի սինթետիկ տեքստը հիմնվի իրական տեղեկատվության վրա։
Անգլերեն սկզբնաղբյուրներից դեպի հնդկական ուսումնական տվյալներ
Կոնվեյերը սկսվում է 15 Nemotron-CC-v2 ենթախմբի փաստաթղթերից, որոնք ընդգրկում են վեբ տեքստ, հարց-պատասխան նյութեր, մաթեմատիկա, կոդ և այլ մասնագիտացված բովանդակություն։ NVIDIA-ի բաց կոդով NeMo Data Designer շրջանակն իրականացնում է թարգմանություն, որակի ստուգումներ և նպատակային ուղղումներ՝ պահպանելով սկզբնաղբյուրի նույնացուցիչները, որպեսզի արդյունքները հետևելի լինեն իրենց սկզբնական փաստաթղթերին։
Տասներկու լեզվի համար փաստաթղթերը ամբողջությամբ թարգմանվում են Gemma-4-31B-it-ի կիրառմամբ, որն ընտրվել է մոդելների լիարժեք փաստաթղթերի համեմատությունից հետո։ Multidimensional Quality Metrics-ից ոգեշնչված ռուբրիկան ընդգրկում է նշանակությունը, հոսունությունը, տերմինաբանությունը, ոճը և ձևաչափումը, և պահպանվում են միայն այն արդյունքները, որոնք 100-ից հավաքում են առնվազն 75 միավոր։ Ցածր միավոր ունեցող արդյունքները շտկվում են գնահատման հետադարձ կապով և կրկին գնահատվում, և այս գործընթացում վերականգնվեց 438,4 միլիարդ տոկեն։ Ստացված մայրենի գրային համակարգի թարգմանությունները նաև փոխակերպվում են լատինատառ համակարգի ռոմանիզացված մասի համար։
Մնացած տասը լեզուն օգտագործում է առանձին աշխատանքային գործընթաց, որը կառուցված է Indic Translate-ի վրա՝ Bodhan AI-ի փաստաթղթային մակարդակի թարգմանության մոդելի հիման վրա։ Ավելի երկար Santali փաստաթղթերի համար համընկնող պատուհանները թարգմանվում և վերակառուցվում են; Manipuri-ի համար տեքստը թարգմանվում է բենգալյան գրին, այնուհետև փոխակերպվում Meitei Mayek-ի։
Nemotron մոդելների վրա ազդեցությունը
Nemotron 3.5 Super VL-ի շարունակվող նախնական ուսուցումը ավելացրել է 10 միլիարդ հնդկական տոկեն՝ վերցված կորպուսի տասներկու լեզու ունեցող ենթախմբից և բնական հնդկական տեքստից։ Միավորները բարձրացել են բոլոր հինգ նշված հնդկական գիտելիքների և բանականության բենչմարկներում՝ աճը տատանվում է 4,98-ից մինչև 9,82 տոկոսային կետ։ Թողարկված մոդելը նաև ավելի բարձր միավոր է ստանում, քան Nemotron 3 Super-ը, վեց հնդկական առաջադրանքների բենչմարկներից հինգում, և լավանում է IndiVibe-ի բոլոր չորս չափումներում, թեև IFEval 1.5-ում հրահանգների կատարումը նվազել է 2,04 կետով։
Թիմը նախատեսում է այս կորպուսի հիման վրա կառուցել հաջորդ Nemotron մոդելները և խորհուրդ է տալիս այն միավորել բնական կերպով գրված հնդկական տեքստի հետ՝ տեղական գիտելիքների և մշակութային համատեքստի համար։
Աղբյուրներ: Hugging Face Blog
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։