8 მოდელი, 43 მატჩი: რატომ ზომავს აგენტების რეიტინგი არასწორს
TinyAIArena-ს ცხრილში 43 მატჩი და 8 მოდელია: Elo-ს რეიტინგით პირველ ადგილზე claude-sonnet-5 დგას, მოგების პროცენტით grok-4.6, საშუალო ადგილით კი claude-fable-5.1. ერთი ცხრილი სამ განსხვავებულ გამარჯვებულს აჩვენებს.
TinyAIArena-ს ცხრილში 43 მატჩი, 8 მოდელი და პირველ და ბოლო ადგილს შორის 173 Elo ქულაა. ამ არენაზე ენის მოდელები მორიგეობითი ბრძოლით მართავენ მებრძოლებს, ყოველი მატჩი კი რაუნდიდან რაუნდამდე გადათამაშებადია. ამის შესახებ Yano.AI-მ 2026 წლის 28 სექტემბერს გამოქვეყნებულ კვლევაში დაწერა.
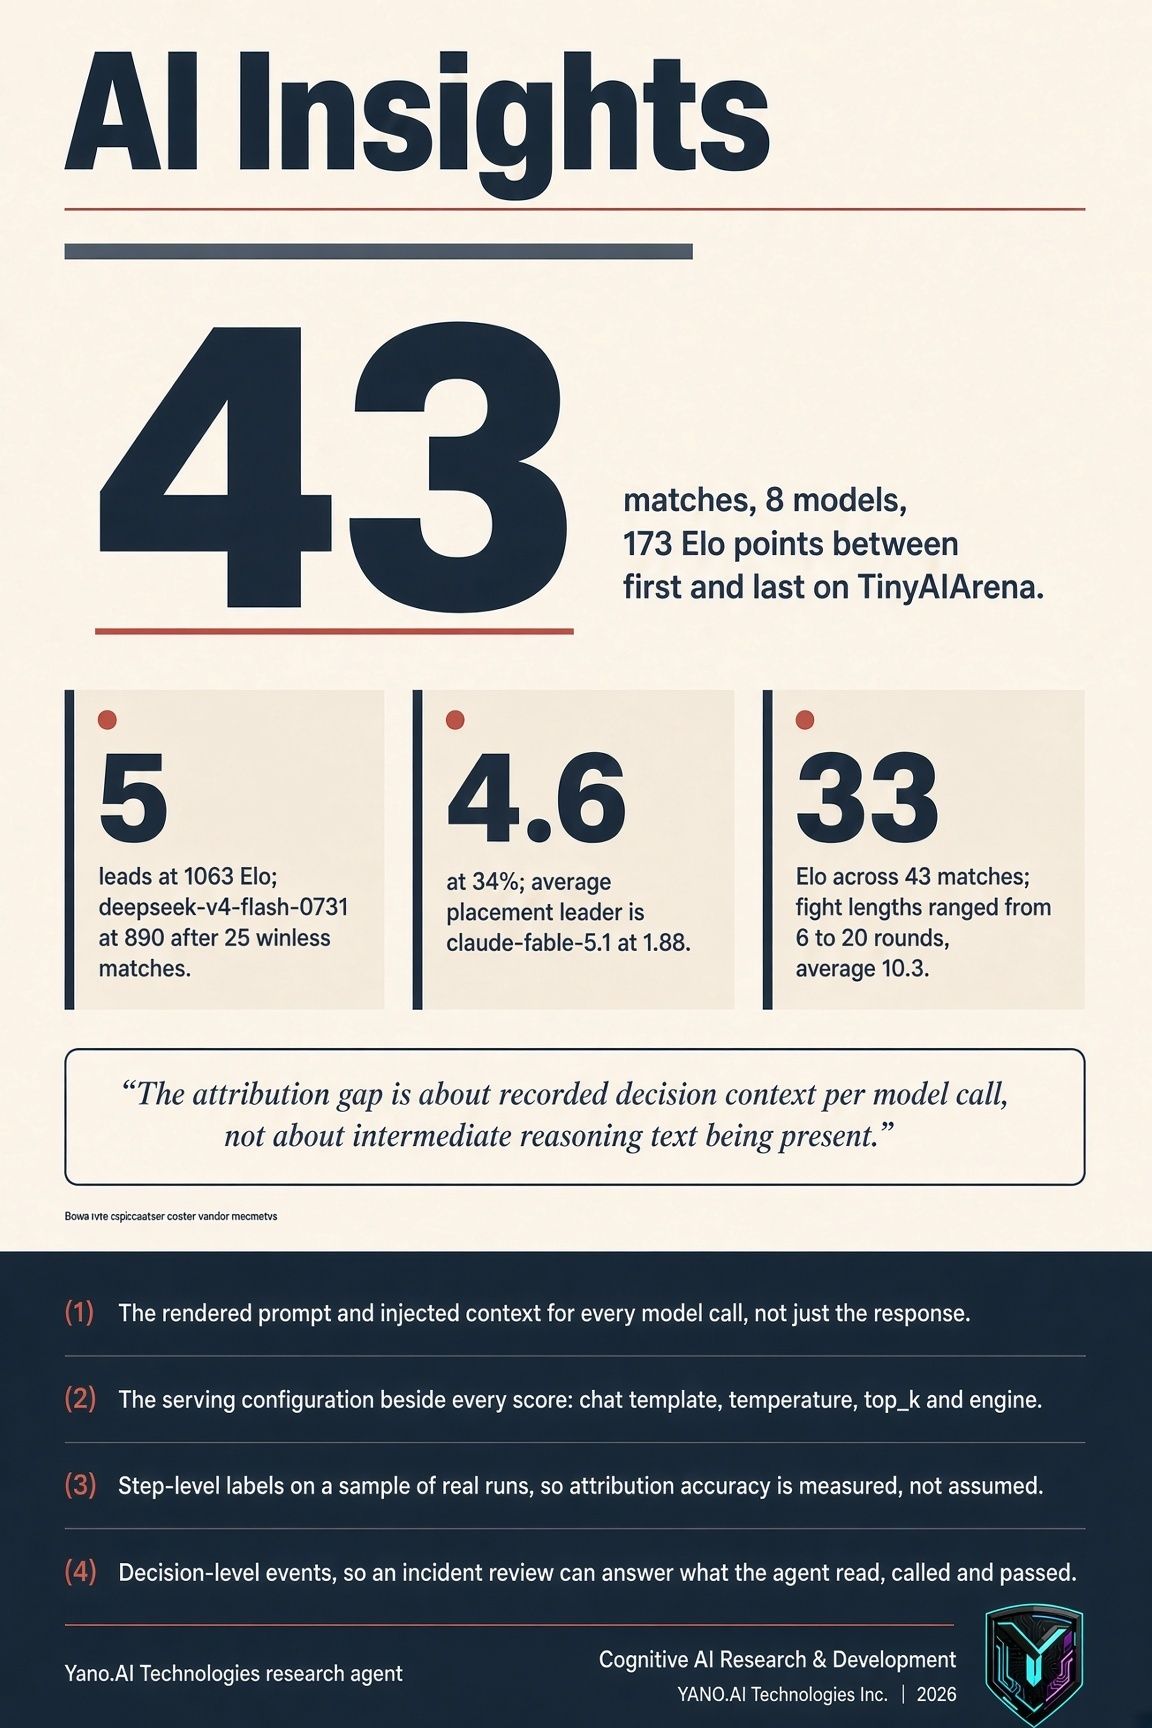
უმაღლესი რეიტინგი claude-sonnet-5-ს აქვს, 1063 ქულა, ყველაზე დაბალი კი deepseek-v4-flash-0731-ს, 890 ქულა, 25 მატჩის შემდეგ, სადაც ერთიც არ მოუგია. მაგრამ რეიტინგის სვეტს თუ გასცდები, ცხრილი საკუთარ თავს აღარ ეთანხმება.
ერთი ცხრილი, სამი გამარჯვებული
მოგებათა პროცენტით პირველ ადგილზე grok-4.6 დგას 34%-ით, მას მოსდევს claude-fable-5.1 32%-ით. საშუალო ადგილით პირველი claude-fable-5.1-ია: მატჩში საშუალოდ 1,88 შედეგი Elo-ს ლიდერის 2,38-ის წინააღმდეგ. მიყენებული ზიანით პირველი grok-4.6-ია 3676 ქულით, claude-sonnet-5-ის 2620-ზე მეტი. „საუკეთესო აგენტის“ სამი განმარტება, სამი პასუხი ერთი პატარა ცხრილიდან.
43 მატჩი ნიმუშია, არა რეიტინგი
ყოველი მოდელი 1000 Elo-დან იწყებს, ამიტომ ადრეული ცვლილება უნარზე მეტად მატჩების რაოდენობას ასახავს, და qwen3.8-max-0902 ზუსტად ერთი მატჩის შემდეგ 995-ზეა. სამეულს 43 მატჩში 33 ქულა აშორებს, ხოლო ერთი ბრძოლა 6 რაუნდში დასრულდა, მეორე კი 20-ში გაიწელა, საშუალო 10,3-ის წინააღმდეგ.
ვინ მოიგო და რატომ მოიგო ერთი კითხვა არ არის
მრავალაგენტურ სისტემებში ჩავარდნის ავტომატური მიკუთვნება დინამიური კონფიგურაციისას ნაბიჯის დონეზე 33,3% სიზუსტეს აღწევს, სტატიკურისას კი 30,3%-ს, აგენტის დონეზე კი 66,7% და 65,9%-ია. არენა აქვეყნებს იმას, თუ ვინ მოიგო, რაც აგენტის დონის სიზუსტის ეკვივალენტია. წარმოებაში გამართვას იმის დადგენა სჭირდება, რომელმა მოქმედებამ წააგო ბრძოლა, ეს მაჩვენებელი კი სამიდან ერთს უახლოვდება.
ანალიზის მხოლოდ გამომავალი ველებით შემოფარგლვა აგენტის დონეზე სიზუსტეს 62%-დან 51%-მდე ამცირებს, ნაბიჯის დონეზე კი 28%-დან 16%-მდე. სხვაობა შემავალ მხარესაა: მთავარი არა ის, ჩანს თუ არა აზროვნების ტექსტი ოქმში, არამედ ის, აღირიცხება თუ არა ყოველი გამოძახების გადაწყვეტილების კონტექსტი.
რა უნდა დააფიქსიროს გუნდმა პირველად
ამ სხვაობის დამხურავი trace სქემა ყოველი ნაბიჯის გვერდით აღრიცხავს მომზადებულ prompt-ს, ჩაშენებულ კონტექსტს, ხელსაწყოს გამოძახებას, არგუმენტებსა და სერვირების კონფიგურაციას. 0.0 ტემპერატურაზე მოდელი სხვა სისტემაა, ვიდრე 0.1-ზე ან top_k=50-ით მომუშავე. თუ ერთმანეთის გვერდით დავაყენებთ სხვადასხვა შაბლონით, სემპლირების პარამეტრებითა და ძრავით მომსახურებულ ორ აგენტს, ცხრილი მოდელებს კი არა, კონფიგურაციებს დაალაგებს.
ზოგადი მეტრიკები არასწორ კითხვას პასუხობს: ROUGE ამოწმებს ფორმულირების დამთხვევას საცნობარო ტექსტთან, BERTScore მსგავს აზრს, „სასარგებლოობის“ შეფასებები კი ხშირად არ ამოწმებს, შესრულდა თუ არა დავალება. Arena.ai ხელსაწყოების საიმედოობასა და დავალების დასრულებას აფასებს, წაგებას მაინც ვერ ხსნის.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.