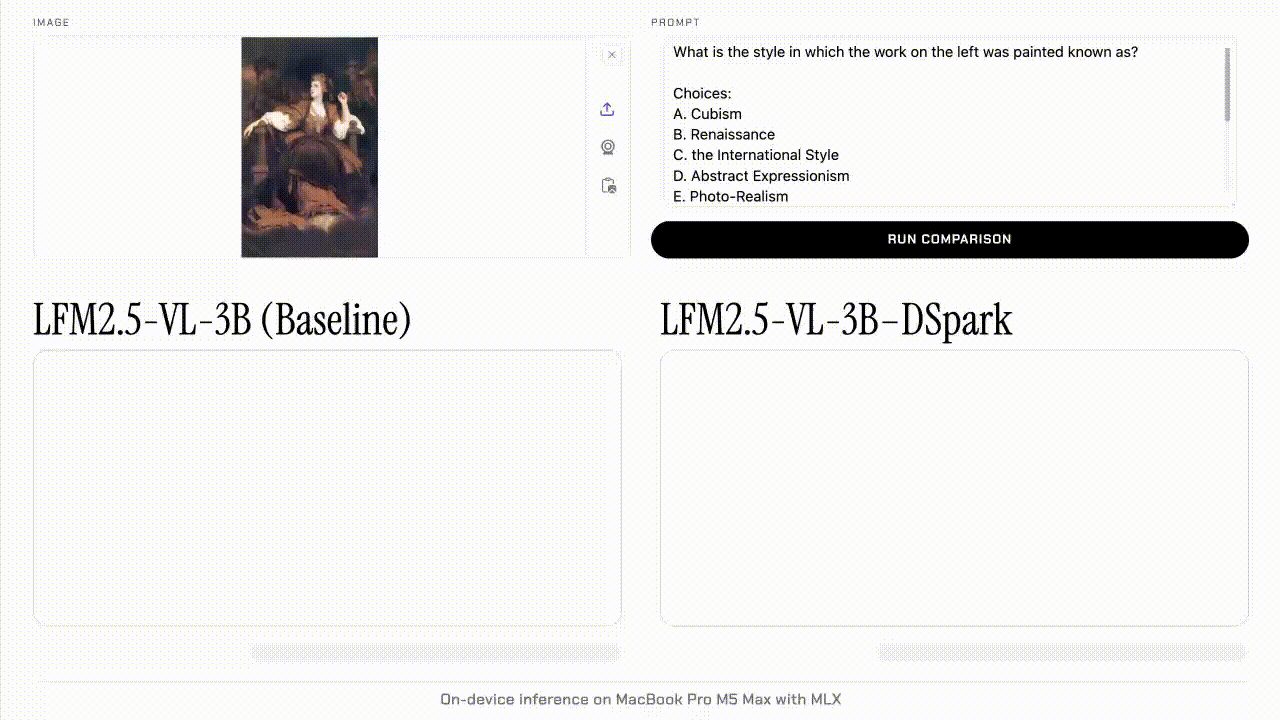
Liquid AI-მ ვიზუალურ-ენობრივი მოდელების დაჩქარებისთვის DSpark დრაფტ-მოდელი გამოუშვა
Liquid AI-მ LFM2.5-VL-3B ვიზუალურ-ენობრივი მოდელისთვის ექსპერიმენტული DSpark დრაფტ-მოდელი წარადგინა: სპეკულაციური დეკოდირება მოწყობილობაზე 3,13-ჯერ, H100-ზე კი 2,66-ჯერ აჩქარებს, გამომავალი ხარისხის ცვლილების გარეშე.
Liquid AI-მ 24 სექტემბერს ვიზუალურ-ენობრივი მოდელისთვის LFM2.5-VL-3B-ისთვის ექსპერიმენტული DSpark დრაფტ-მოდელი წარადგინა. ის სპეკულაციური დეკოდირებით აჩქარებს გენერაციას: მეხსიერების დანამატი მცირეა, გამომავალი ხარისხი კი უცვლელი რჩება.
რას იძლევა დრაფტ-მოდელი
Liquid AI-ის გაზომვებით, დეკოდირება მოწყობილობაზე 3,13-ჯერ, H100-ზე კი 2,66-ჯერ აჩქარებს, პასუხის მთლიანი დრო კი 2,62-ჯერ და 2,27-ჯერ მცირდება. დრაფტ-მოდელი მიზნობრივ მოდელს 280 მილიონ პარამეტრს, ანუ მისი ზომის 8,9%-ს, ამატებს. llama.cpp, MLX-VLM და SGLang მას პირველივე დღიდან უჭერენ მხარს.
როგორ მუშაობს სპეკულაციური დეკოდირება
დრაფტ-მოდელი იმავე არქიტექტურას იყენებს, რასაც Liquid AI-ის ტექსტური დრაფტერები: მიზნობრივი მოდელის ფარულ მდგომარეობებს განსაზღვრულ ფენებზე კითხულობს და მათზე დაყრდნობით k კანდიდატ ტოკენს სთავაზობს. სურათის ნაწილები და ტექსტური ტოკენები საერთო წარმოდგენაში გარდაიქმნება, ამიტომ განზომილება შეყვანის ტიპზე არ არის დამოკიდებული.
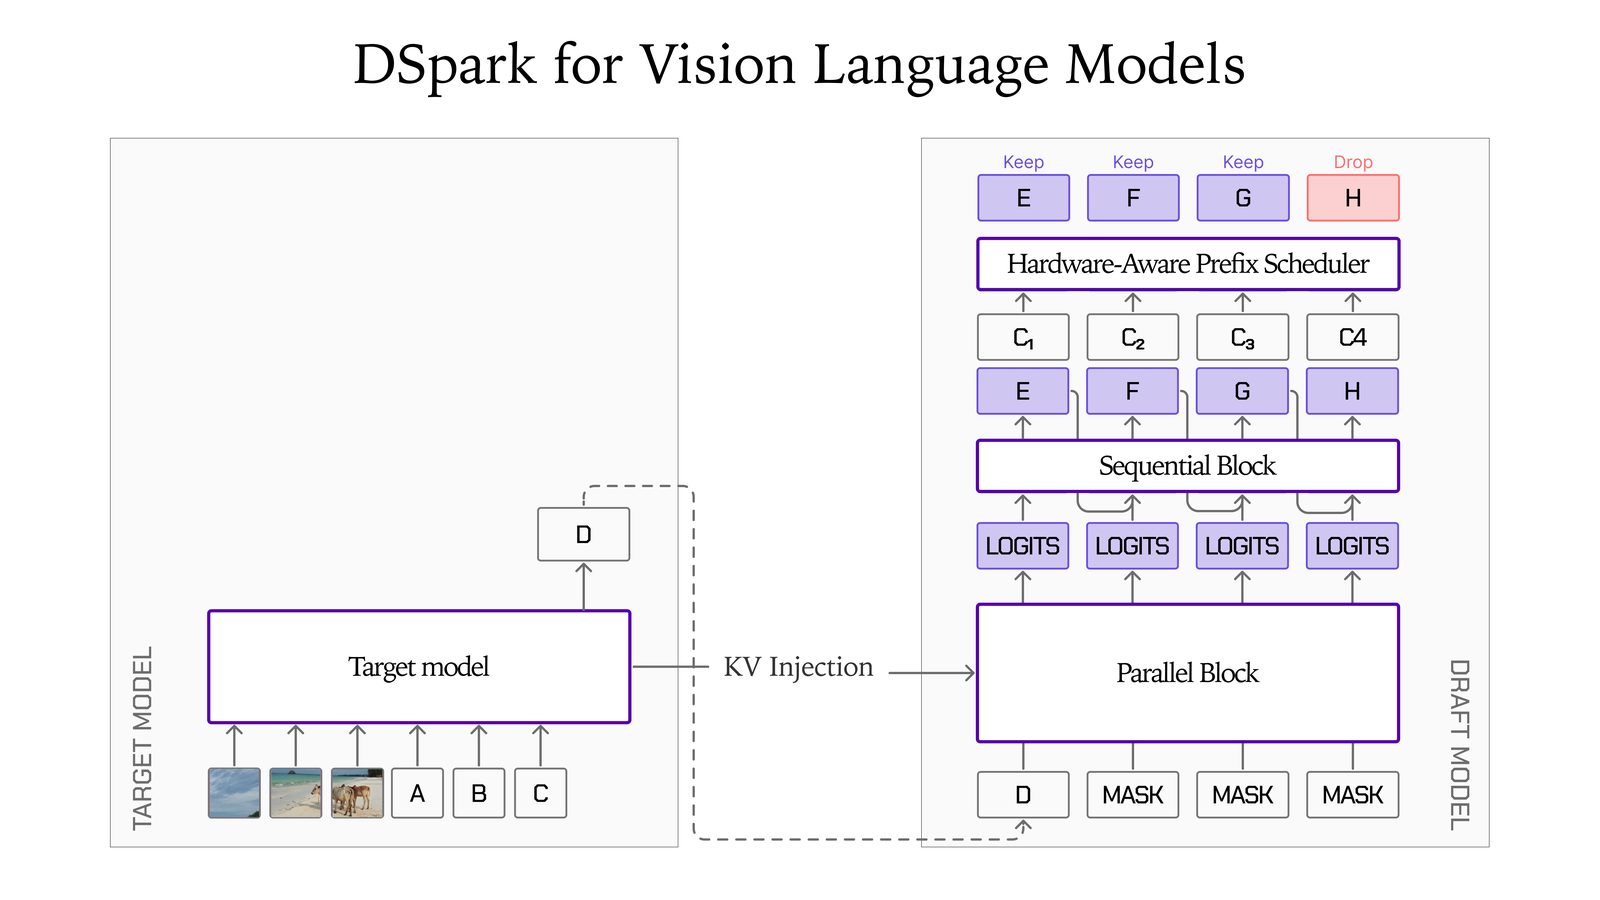
მომზადება DSpark-ის რეცეპტით, ვიზუალურ-ენობრივი SFT მონაცემებით მიმდინარეობდა. სამი, ოთხი და ხუთი ფენის შედარების შემდეგ არჩევანი ოთხფენიან დრაფტერზე, ბლოკის ზომით 9, შეჩერდა. დრაფტ-მოდელი 279,5 მილიონი პარამეტრისგან შედგება.
სიჩქარე მოწყობილობაზე და H100-ზე
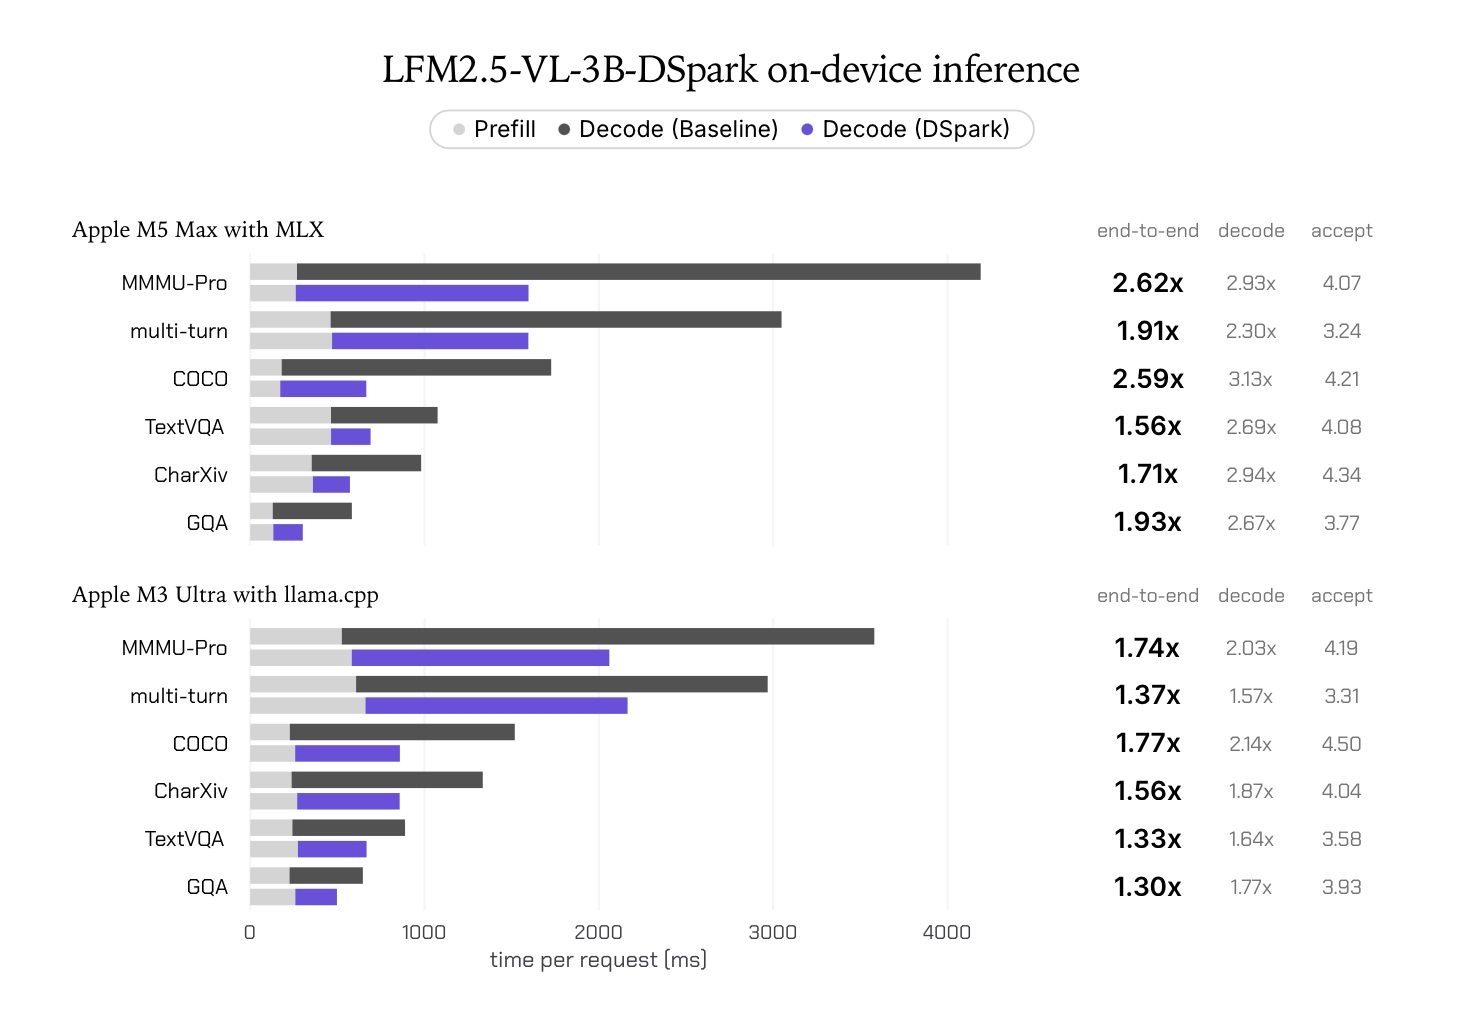
გაზომვები ბლოკის ზომით 8 და ექვს ვიზუალურ ამოცანაზე ჩატარდა: ზოგადი და ტექსტური VQA, სურათის აღწერა, დიაგრამების VQA, რთული მსჯელობა და მრავალტურიანი დიალოგი, MMSpec-ის ბენჩმარკის მიხედვით. MLX-ზე, M5 Max-ზე დეკოდირება 2,30-დან 3,13-ჯერ აჩქარდა, პასუხის დრო 1,56-დან 2,62-ჯერ შემცირდა. llama.cpp-ზე, M3 Ultra-ზე დეკოდირება 1,57-დან 2,14-ჯერ, მთლიანი დრო 1,30-დან 1,77-ჯერ გაუმჯობესდა. H100-ზე დეკოდირება 2,66-ჯერ აჩქარდა, პასუხის დრო 1,64-დან 2,27-ჯერ შემცირდა.
სად ჩერდება სპეკულაციის ეფექტი
სპეკულაციური დეკოდირება მხოლოდ დეკოდირებას აჩქარებს, არა სურათის დამუშავებას ან წინასწარ გამოთვლას. სურათი ჯერ ვიზუალურ ენკოდერს გაივლის, შემდეგ კი ენობრივი ბირთვი ასობით ვიზუალურ ტოკენს და ტექსტურ მოთხოვნას ერთად ამუშავებს, რაც სუსტ მოწყობილობებზე დროის დიდ ნაწილს იკავებს. თუ ეს ეტაპები მთლიანი დროის მნიშვნელოვან ნაწილს მოიხმარენ, დეკოდირების დიდი დაჩქარებაც კი მხოლოდ ზომიერ მოგებას იძლევა. Liquid AI-ის ახსნით, ეს Amdahl-ის კანონია.
დრაფტ-მოდელი Hugging Face-ზე Safetensors და GGUF ფორმატებშია ხელმისაწვდომი; საჭიროა DSpark-ის მხარდაჭერის მქონე llama.cpp, MLX-VLM და SGLang. სპეკულაციური დეკოდირება ზუსტია: მიზნობრივი მოდელი ყველა შემოთავაზებულ ტოკენს ამოწმებს, ამიტომ greedy რეჟიმში შედეგი მის გამომავალს ემთხვევა.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.