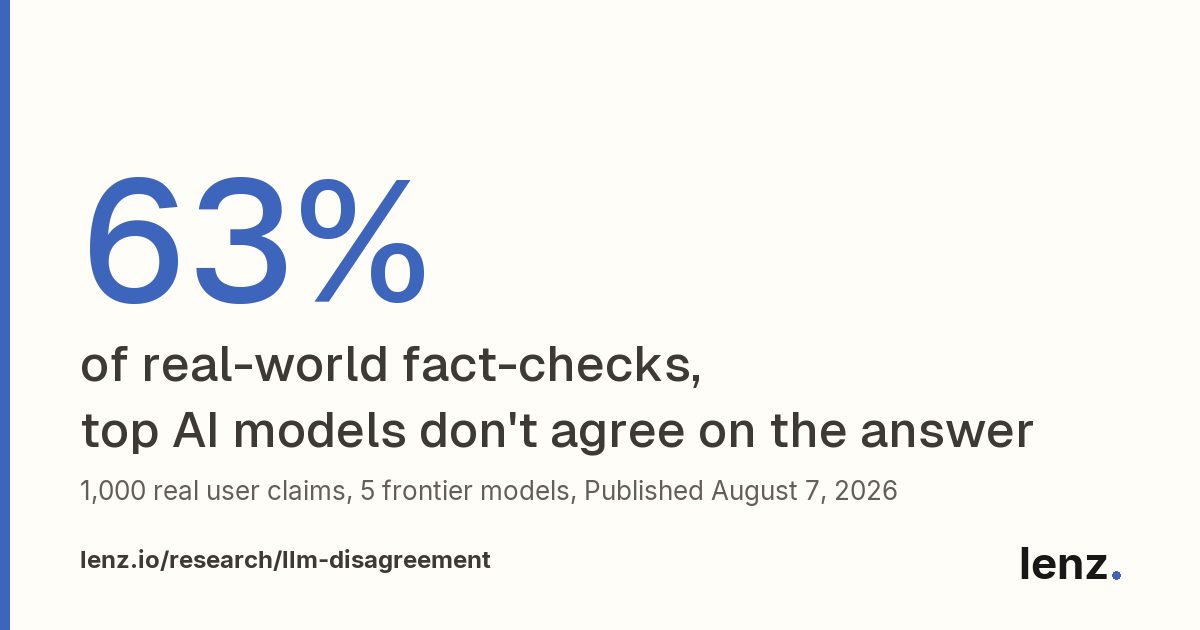
კვლევა: ფრონტიული LLM-ები რეალურ ფაქტებზე შემთხვევათა 67%-ში არ თანხმდებიან
Lenz-ის კვლევაში ხუთ ტოპ მოდელს 1000 რეალური მტკიცება მისცეს: შემთხვევათა 67%-ზე პანელი იყოფა, 34%-ზე კი ორი ან მეტი საფეხურის არსებითი სხვაობაა — ეს ნიშნავს, რომ მინიმუმ ერთი მოდელი აუცილებლად ცდება.
ფაქტების გადამოწმების პლატფორმა Lenz-მა გამოაქვეყნა კვლევა იმის შესახებ, თუ რამდენად ხშირად არ ეთანხმებიან ერთმანეთს წამყვანი ფრონტიული ენობრივი მოდელები რეალურ ფაქტებზე. კომპანიამ ხუთ ტოპ მოდელს — GPT-5.4, Claude Opus 4.7, Gemini 3 Pro, Gemini 3 Pro Search-ით და Perplexity-ის Sonar Pro — მომხმარებლების მიერ წარდგენილი 1000 რეალური მტკიცება მისცა და თითოეულს ოთხი შეფასებიდან ერთის არჩევა სთხოვა: ჭეშმარიტი, ძირითადად ჭეშმარიტი, შეცდომაში შემყვანი ან მცდარი.
მტკიცებათა ორ მესამედზე პანელი იყოფა
მტკიცებათა 67%-ზე (1000-დან 672; 95%-იანი სანდოობის ინტერვალი 64-70) სულ მცირე ერთი მოდელი უმრავლესობისგან განსხვავებულ შეფასებას იძლეოდა, ან საერთოდ ვერ ჩამოყალიბდა უმრავლესობა. კიდევ 34%-ზე (343 მტკიცება) ყველაზე მეტად განსხვავებულ წყვილს შორის ორი ან მეტი საფეხურის სხვაობა დაფიქსირდა — ეს პასუხთან დაკავშირებით არსებითი უთანხმოებაა და არა უბრალოდ დარწმუნებულობის ცვლილება.
მოდელებს შორის შეთანხმება არსებითი, მაგრამ შეზღუდული აღმოჩნდა: Krippendorff-ის ალფა რიგით სკალაზე 0.639-ს შეადგენს. პანელი თანხვდება ცალსახა შეფასებებზე და იშლება სკალის შუაში: იმ 328 მტკიცებიდან, სადაც ხუთივე მოდელი დაეთანხმა, მხოლოდ ოთხზე იყო ერთსულოვნება „შეცდომაში შემყვანზე“ და არც ერთზე — „ძირითადად ჭეშმარიტზე“.
სად ემთხვევიან მოდელები
ყველაზე ახლოს იყვნენ Gemini 3 Pro და მისი ძებნით გაძლიერებული ვერსია, რომლებიც მტკიცებათა 75%-ზე ეთანხმებოდნენ ერთმანეთს — რაც ავტორებისთვის მოულოდნელი არ არის, რადგან მათ საერთო საბაზისო მოდელი აქვთ. ყველაზე დაშორებული წყვილები, 53%-ით, იყო Claude Opus 4.7 ორივე Gemini ვარიანტთან და Gemini 3 Pro Sonar Pro-სთან. დანარჩენ მოდელებთან უმრავლესობის თანხვედრა 69%-დან 81%-მდე მერყეობს.
რადგან თითოეულ მტკიცებაზე მხოლოდ ერთი შეფასება შეიძლება იყოს სწორი, კვლევა შეცდომის ქვედა ზღვარსაც იძლევა. თუ დავუშვებთ, რომ პანელის ყველაზე პოპულარული შეფასება სწორია — ყველაზე კეთილგანწყობილი დაშვებით — სულ მცირე ერთი მოდელი შეცდა მტკიცებათა 67%-ზე, ორი მაინც — 45%-ზე, სამი მაინც კი — 13%-ზე, სადაც ვერც ერთმა შეფასებამ ვერ მიაღწია უმრავლესობას.
რას არ ამბობს კვლევა
Lenz ხაზს უსვამს, რომ მოდელთა უმრავლესობა სიმართლის საზომი არ არის: უმრავლესობა ზოგჯერ შეცდება, განსხვავებული აზრის მქონე მოდელი კი ზოგჯერ მართალია; კომპანია უმრავლესობას მხოლოდ სტრუქტურულ საორიენტაციო წერტილად იყენებს. თავად Lenz-ის შეფასებები ანალიზში არ შედიოდა. კორპუსიდან გამორიცხულია პირადი მტკიცებები, თანამშრომლების წარდგენები, თითქმის იდენტური ჩანაწერები და შემთხვევები, როცა რომელიმე მოდელმა ვერ შეძლო ამოღებადი შეფასების გაცემა.
კვლევა გაყინული სნეპშოტია — ვერსია 1.0, მონაცემები 2026 წლის 21 მაისის მდგომარეობით — და თითოეული მტკიცების CSV საჯაროდ ხელმისაწვდომია. მომდევნო კვლევა ყველა მტკიცებას ადამიანური შეფასებით მონიშნავს და ამ შეფასებებს საცნობარო ჭეშმარიტებად გამოიყენებს, რათა დაადგინოს, სად გადაუხვევს ფრონტიული პანელი და თავად Lenz ადამიანურ კონსენსუსს.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.