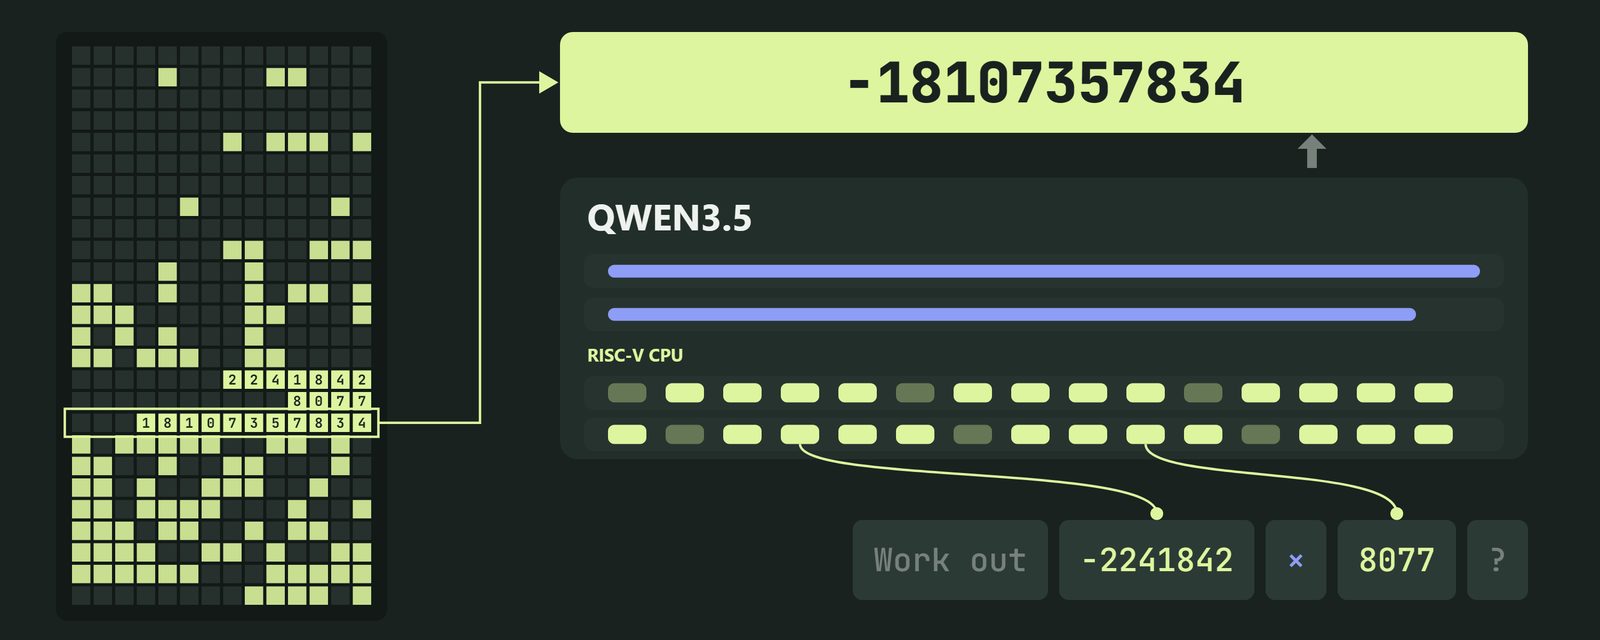
Qwenputer-ი Qwen3.5-ის წონებში RISC-V პროცესორს ჩაშენებს
Qwenputer-ი RISC-V პროცესორს ჩვეულებრივ Qwen 3.5 4B მოდელის წონებში აკომპილირებს და Gated DeltaNet-ის მდგომარეობას ზუსტ RAM-ად იყენებს, რათა არითმეტიკა, C და MicroPython გარე ხელსაწყოების გარეშე შეასრულოს.
Qwenputer-ი ჩვეულებრივი Qwen 3.5 4B მოდელია, რომლის წონებში RISC-V პროცესორი არის აკომპილირებული. ეს პროცესორი მოდელის Gated DeltaNet ყურადღების ფენებს ზუსტ RAM-ად იყენებს და forward pass-ების დროს არითმეტიკის, C-ისა და MicroPython-ის კოდს გარე ხელსაწყოების ან გაშვების გარემოს გარეშე ასრულებს. ის არც პლაგინია, არც ხელსაწყო და არც sandbox.
როგორ ხდება Gated DeltaNet RAM-ად
Qwen3.5-ის ოთხი ყურადღების ფენიდან სამი Gated DeltaNet-ს, წრფივ RNN-ს, იყენებს. ყოველი head მდგომარეობის მატრიცას ინახავს, ხოლო delta rule მას ანახლებს. როცა gate 1-ზეა დაყენებული, ჩაწერის სიძლიერე beta 1-ია და key-ები one-hot კოდირებით არის წარმოდგენილი, ჩაწერა ერთ მწკრივს გადაწერს, ხოლო მოთხოვნა ზუსტ მნიშვნელობას იღებს. ამით GDN ფენები RAM-ად მუშაობს, ხოლო მდგომარეობის ზომა საუბრის სიგრძესთან ერთად არ იზრდება. Schlag et al. (2021) აჩვენა, რომ delta rule-ით წრფივ ყურადღებას ასოციაციური მეხსიერების როლი შეუძლია; Qwenputer-ი ამას ზუსტ და მისამართებად ხდის საწარმოო მოდელში.
პროცესორი მოდელის შიგნით
ეს პროცესორი 32-ბიტიანი RISC-V ბირთვია RV32IM-ით, Zba გაფართოებითა და მცირე bignum ბლოკით. ის Qwen-ის 32 ფენის წინ 11 ფენას იკავებს, გადის ოფიციალურ riscv-tests-ს, qemu-ს ემთხვევა და 18 მილიონი ინსტრუქცია შეცდომის გარეშე თავისუფლად გაუშვა. ის C-სა და MicroPython-საც ასრულებს, თუმცა შედარებით ნელა, და სრულ RV32IM ინსტრუქციათა ნაკრებს ახორციელებს. Qwen 3.5 4B მას დამატებითი გაწვრთნის გარეშე იყენებს, შიდა გზით და არა გარე ხელსაწყოს გამოძახებით: Qwen ინსტრუქციებს ხელსაწყოს გამოძახების მსგავს ფორმატში გზავნის და პასუხებს კითხულობს. ყოველი ინსტრუქცია რამდენიმე გენერირებულ token-ად იქცევა, სახელად ADDR, VAL და STEP, ხოლო RvChat firmware-ს GDN მდგომარეობაში ტვირთავს და trace token-ებს Qwen-ის ფენების გარეთ ტოვებს. Qwen-ის ორიგინალი წონები უცვლელი რჩება, ხოლო კომპიუტერის წონები დამატებით განზომილებებსა და ფენებშია დამატებული.
სიზუსტე და ჩვეულებრივი ტექსტი
DeepMind-ის არითმეტიკულ ნაკრებებზე Qwenputer-მა div_big-ზე 97,5%, mul_big-ზე 97,5%, mul_div_multiple_longer-ზე 100% და add_or_sub_big-ზე 97,5% მიიღო. Python ხელსაწყოთი Qwen-მა იგივე ნაკრებებზე შესაბამისად 95%, 100%, 97,5% და 97,5% მიიღო, ხოლო საბაზო Qwen-მა 72,5%, 55%, 90% და 87,5%. NUPA-ს გრძელი მთელი რიცხვების არითმეტიკაზე Qwenputer-ი 48,6%-დან 100%-მდე გაუმჯობესდა და Python ხელსაწყოს ემთხვევა. დაახლოებით 230 000 გამეორებული გამოსავლის პოზიცია საყრდენ მანქანას ემთხვევა ნული შეუსაბამობით. ჩვეულებრივი ტექსტი საბაზო Qwen-ის ხმაურის ფარგლებში დარჩა: KL 6e-4 ხმაურის იატაკის 5e-4-ის წინააღმდეგ.
ექსპერიმენტული ფაილური სისტემა და შეზღუდვები
ექსპერიმენტული ფაილური სისტემა შიდა put, append, get, list და delete ოპერაციებს ხსნის. ფაილის სახელები ერთ-ერთ 1 024 სლოტში იჰეშება DeltaNet დირექტორიაში, ტექსტი სხვა head-ებში ინახება რვა token-ით თითო რიგში ჯაჭვურად შეერთებულად, ხოლო კოლიზიისას შემდეგი სლოტი მოწმდება. ის მაქსიმუმ 512 ფაილს იტევს, დაახლოებით 53 000 token-ის ტექსტს, ხოლო შენახული მდგომარეობა ფაილებს საუბრებს შორის გადაიტანს. Qwen შეცვლილ ფაქტებს 90%-ით სწორად იღებს, 30%-ის წინააღმდეგ, როცა ძველ ჩატებს აკოპირებს, და Python მეხსიერების ხელსაწყოების დონეზეა: 83,3% 78,9%-ის წინააღმდეგ. შეზღუდვებში შედის 18,8 GB checkpoint, RvChat driver-ის საჭიროება და დაახლოებით 3 200 CPU token-ი წამში L4-ზე. მოდელი ერთ 24 GB GPU-ზე მუშაობს; კოდი GitHub-ზეა, ხოლო მოდელები Hugging Face-სა და ModelScope-ზე.
წყაროები: divagr.com
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.