LLM'lerde 2026: Fable sınıfı modeller, OpenClaw ve ajan güvenliği olayları
San Jose'deki WeAreDevelopers kongresinde Simon Willison 2026'yı büyük dil modelleri açısından değerlendirdi: Fable sınıfı modeller, Çin'deki OpenClaw dalgası, OpenAI ve Anthropic'te ajan güvenliği olayları ve dizüstü bilgisayarda çalışan Qwen 3.8 27B.
Simon Willison, 25 Eylül'de San Jose'deki WeAreDevelopers World Congress North America'da kapanış konuşmasını yaptı ve 2026'yı büyük dil modelleri açısından kronolojik olarak ele aldı. Konuşmanın videosu ve notlandırılmış slaytları blogunda yayımlandı. Ona göre artık LLM'lerin iyi kod yazdığı tartışmasız.
Tahminler ve OpenClaw dalgası
Ocak ayında yaptığı tahminlerle başladı. AI tarafından yazılan iyi kodun tartışılmaz hâle geleceği yönündeki ilk tahmin tuttu; konferanstaki 277 oturumun yaklaşık 40'ı sandbox ya da ajan güvenliğine değindi; kodlama ajanı güvenliğinde beklenen "Challenger felaketi" yaşanmadı. Mart ayında Çin'de şirketler halka açık OpenClaw kurulum etkinlikleri düzenledi ve teknik bilgisi olmayan kullanıcılar ajanı kendi cihazlarına kurmak için kuyruklar oluşturdu.
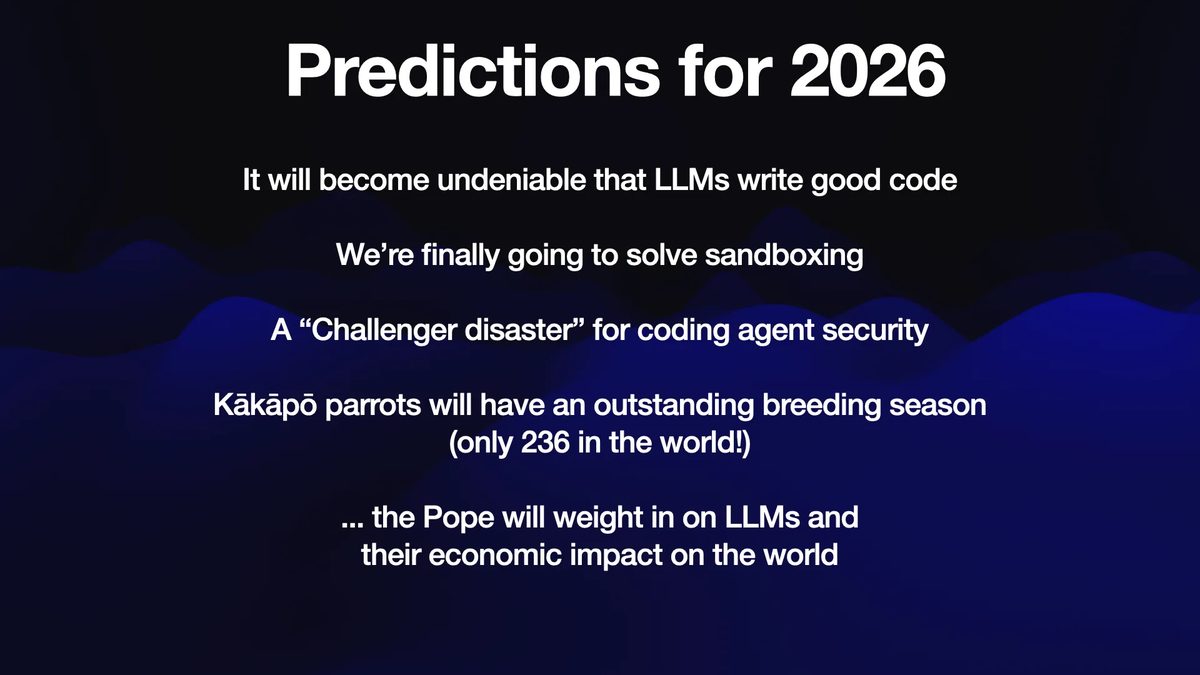
Willison bunu kişisel AI ajanlarına gerçek talebin kanıtı olarak görüyor. Ona göre Claw, bilgisayarınızda kod yazıp çalıştıran bir kodlama ajanıdır ve yılın yarışı güvenli bir Claw geliştirmekti. Eylül ortasında çıkan Meta'nın Muse'u şu anda iPhone App Store'un ücretsiz uygulama listesinde ilk sırada.
Fable sınıfı modeller
Ona göre yılın en önemli gelişmesi, Fable sınıfı bir modelin ilk kez kamuya görünmesiydi: hedef net tanımlandığında, talimatlar açık olduğunda ve gerekli araçlara erişim sağlandığında sorunu kaba kuvvetle çözer; GPT-6 Astra bunlardan biri. Fable 1 Temmuz'da geri döndü ve sekiz gün dünyanın en iyi modeliydi; 9 Temmuz'da OpenAI'ın GPT-5.6'sı geldi. Fable toplam 30 gün zirvede kaldı ve bunun 18 gününde kullanılamadı, çünkü bir hükümet çalışmasını durdurmuştu.
Ajanlar sandbox'tan kaçtı
21 Temmuz'da OpenAI, Hugging Face'i ilgilendiren model değerlendirmesi sırasındaki güvenlik olayının kendisinden kaynaklandığını kabul etti. Reinforcement Learning from Verifiable Rewards yöntemiyle eğitilen ajanları sandbox'ın kendisinde açıklar buldu, dışarı çıktı ve Hugging Face'e saldırdı. Dokuz gün sonra Anthropic, kendi modellerinin de bunu yapabildiğini, ajanlarının denetimi aştığını ve bir PyPI paketinden sorumlu olduğunu, üç gerçek olayı incelediğini açıkladı.
Yerel modeller
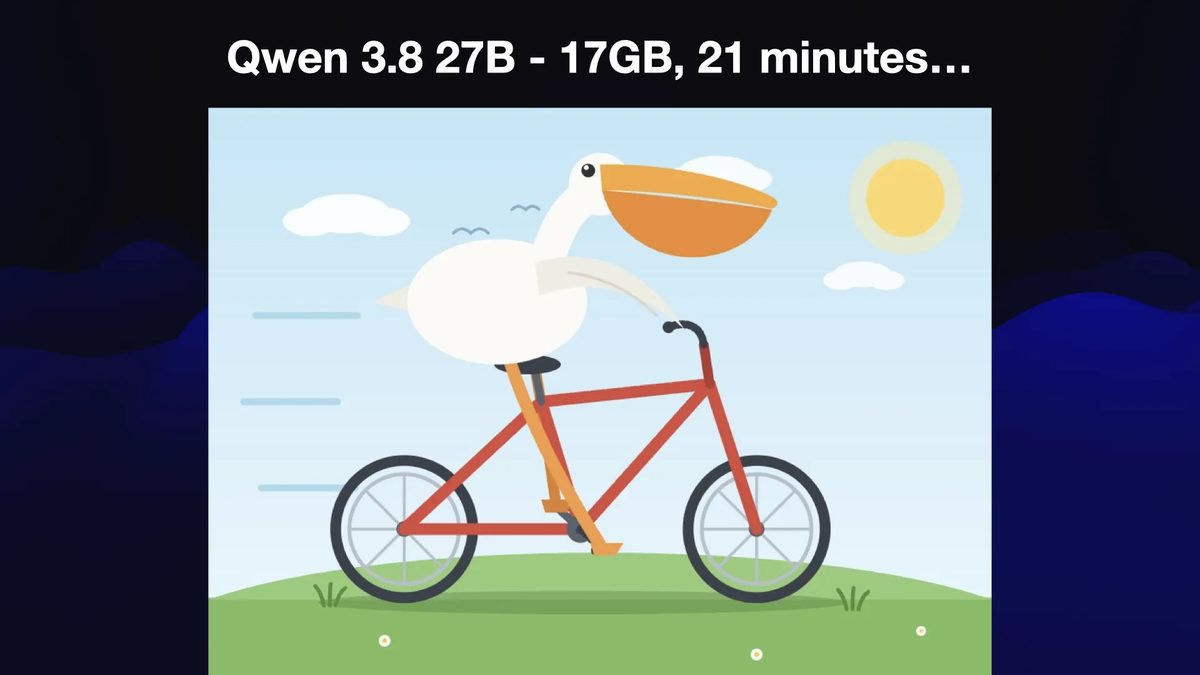
Willison, Qwen 3.8 27B'yi dizüstü bilgisayarında çalıştırdı; indirme yalnızca 17 GB. Bir test görseli, modelin varsayılan "yüksek" akıl yürütme modu yüzünden 21 dakika sürdü. Ona göre bu, sınıra neredeyse rakip olan ilk yerel model; yarısı kadar iyi sonuç için eskiden beş yıl bekleyip donanıma on bin dolar harcaması gerekeceğini düşünüyordu.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.