Liquid AI, görsel-dil modellerini hızlandıran DSpark drafter'ını yayınladı
Liquid AI, LFM2.5-VL-3B görsel-dil modeli için deneysel DSpark drafter modelini yayınladı: spekülatif kod çözme cihazda 3,13 kata, H100'de ise 2,66 kata kadar hızlanma sağlıyor ve çıktı kalitesini değiştirmiyor.
Liquid AI, 24 Eylül'de görsel-dil modeli LFM2.5-VL-3B için deneysel DSpark drafter modelini yayınladı. Model, küçük bir bellek artışına karşılık belirgin hızlanma sağlayan spekülatif kod çözme yolu ekliyor; çıktı kalitesi değişmiyor.
Drafter ne kazandırıyor
Liquid AI'nın ölçümlerine göre kod çözme cihazda 3,13 kata, H100'de ise 2,66 kata kadar hızlanıyor; uçtan uca gecikme 2,62 ve 2,27 kata kadar azalıyor. Drafter hedef modele 280 milyon parametre, yani 3B modelin üzerine %8,9 ekliyor; llama.cpp, MLX-VLM ve SGLang desteği ilk günden hazır.
Görsel modellerde spekülatif kod çözme nasıl çalışır
Görsel drafter, metin tabanlı LFM2.5-DSpark modelleriyle aynı mimariyi kullanıyor: hedef modelin gizli durumlarını belirli katmanlarda okuyup k adet aday token içeren bir blok öneriyor. Görüntü parçaları ile metin token'ları ortak gösterime yansıtılıyor, böylece drafter girdi türünden bağımsız olarak aynı boyutlu vektörlerle çalışıyor.
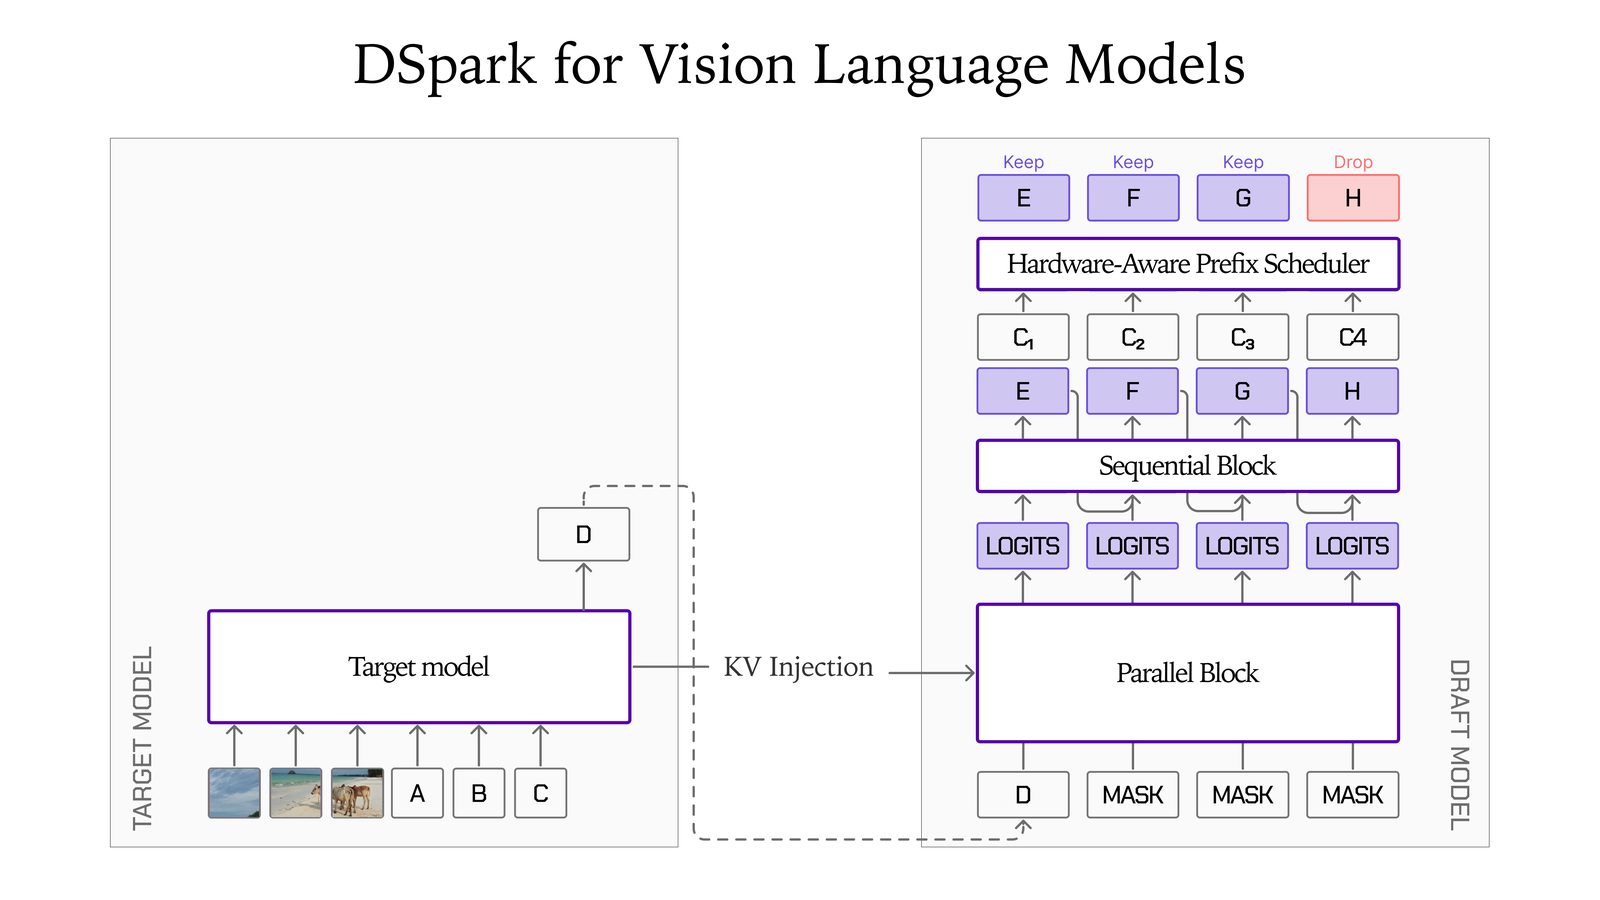
Eğitim, DSpark tarifine göre görsel-dil SFT verileri üzerinde yapıldı: 3, 4 ve 5 katmanlı sürümlerin ardından dikkat mekanizmasına dayanan 4 katmanlı sade bir drafter ve 9'luk blok boyutu seçildi. Drafter toplamda yaklaşık 279,5 milyon parametre içeriyor.
Cihazda ve H100'de hızlanma
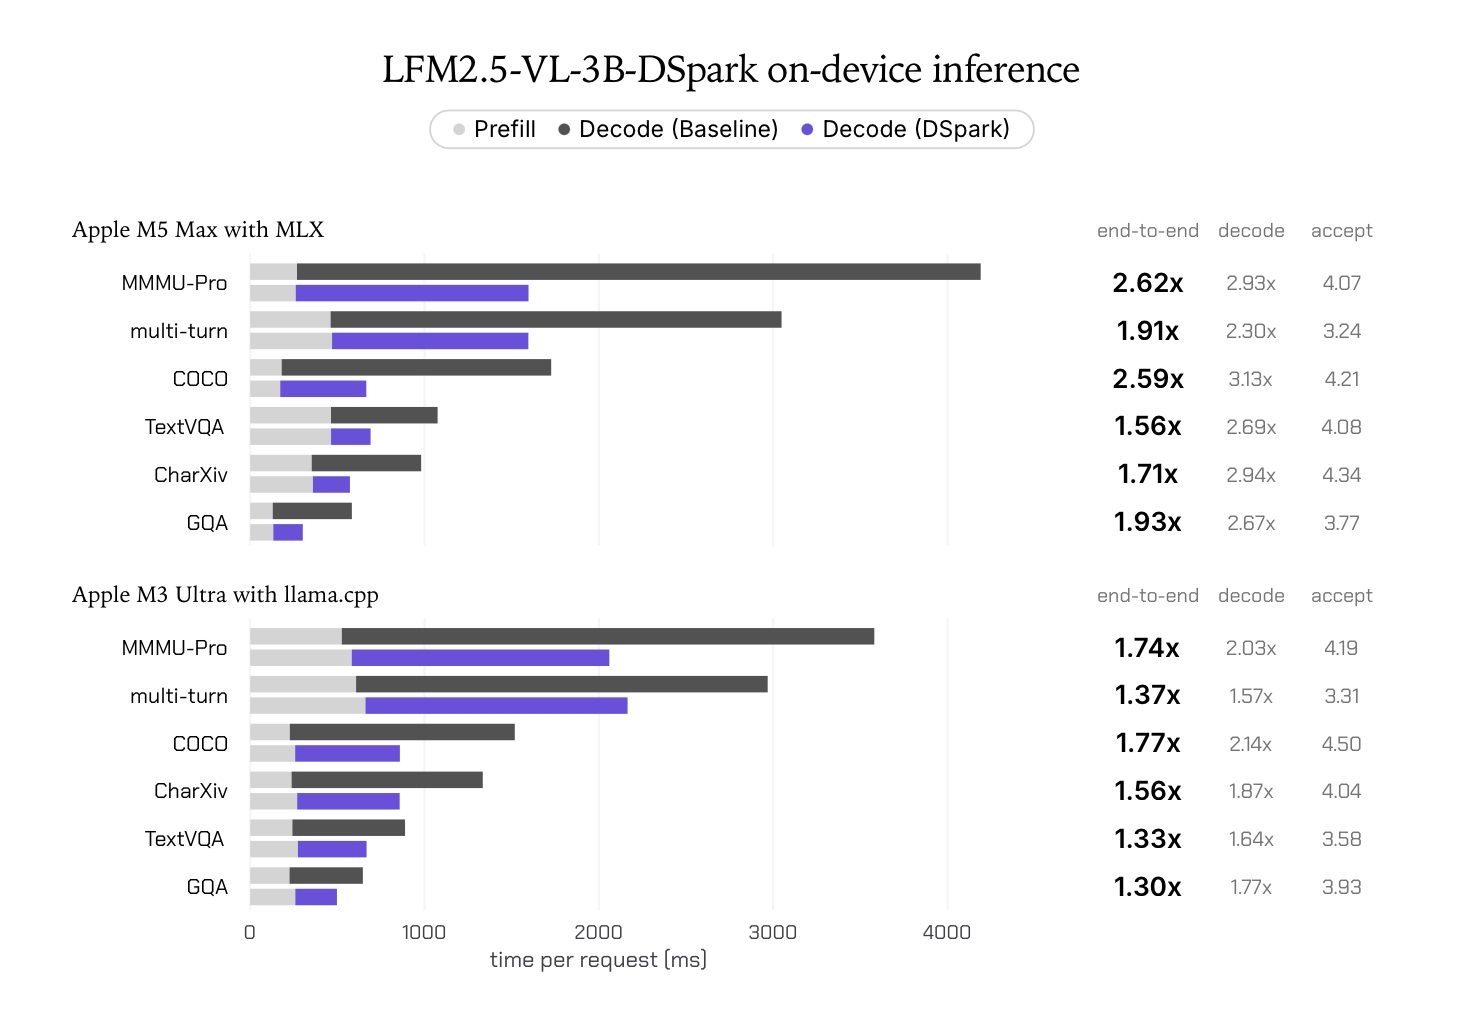
Ölçümler 8'lik blok boyutuyla, MMSpec ölçütüne göre altı görsel görevde yapıldı. M5 Max üzerinde MLX ile kod çözme 2,30 ile 3,13 kat arasında hızlandı, uçtan uca gecikme 1,56 ile 2,62 kat arasında iyileşti. M3 Ultra üzerinde llama.cpp ile kod çözme 1,57 ile 2,14 kat, uçtan uca süre ise 1,30 ile 1,77 kat iyileşti. H100'de kod çözme 2,66 kata kadar hızlanıyor, uçtan uca gecikme 1,64 ile 2,27 kat arasında azalıyor.
Spekülasyonun işe yaramadığı yer
Spekülatif kod çözme yalnızca kod çözmeyi hızlandırır; görüntü kodlamayı veya ön doldurmayı hızlandırmaz. Görüntü önce görüntü kodlayıcıdan geçer, ardından dil omurgası yüzlerce görsel token'ı istemle birlikte işler; uç cihazlarda bu aşama sürenin büyük bölümünü kaplar. Bu aşamalar zamanın önemli kısmını zaten tüketiyorsa, kod çözmedeki büyük hızlanma bile uçtan uca ölçülü bir kazanç sağlar. Liquid AI bunu Amdahl yasası olarak açıklıyor.
Drafter, Hugging Face üzerinde Safetensors ve GGUF formatlarında sunuluyor; llama.cpp, MLX-VLM ve SGLang için DSpark desteği olan sürümler gerekiyor. Spekülatif kod çözme birebir sonuç veriyor: hedef model önerilen her token'ı doğruluyor, dolayısıyla açgözlü modda çıktı hedef modelin tek başına ürettiğiyle aynı oluyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.