Stanford ve NVIDIA'dan CLM-8B: kararlar için hızlı bir System One modeli
Stanford University ve NVIDIA Research ekibi, durumlarla eylemleri aynı uzayda eşleştiren Contrastive Language Models'ı tanıttı. CLM-8B, bilgisayar kullanımı, oyun ve araç çağırma görevlerinde Jev ile aynı seviyede çalışırken 9 kata kadar daha hızlı.
Contrastive Language Model nedir
Stanford University ve NVIDIA Research’ten bir ekip, Jacky Kwok’un liderliğinde 23 Eylül’de Contrastive Language Models’ı (CLM) tanıttı. Yazarlara göre CLM yeni bir System One model sınıfı: adım adım akıl yürütmek yerine hızlı ve refleksif kararlar alıyor; durum kodlayıcı ile eylem kodlayıcıyı ortak bir gömme uzayında birleştiriyor ve eğitim çift yönlü InfoNCE kontrastif kaybıyla yapılıyor.
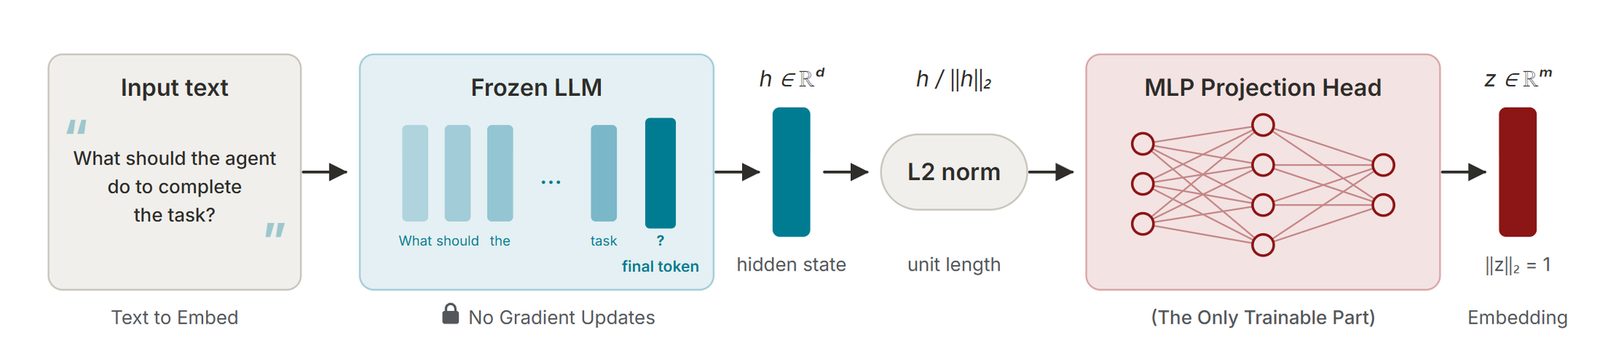
Kullanım sırasında iki kodlayıcı birlikte sıfır atışlı (zero-shot) eylem sınıflandırıcısı olarak çalışıyor: mevcut durum ve aday eylemler verildiğinde CLM her adayı durum gömmesiyle kosinüs benzerliğine göre puanlıyor ve en yükseği seçiyor. Her kodlayıcı dondurulmuş bir LLM omurgasıyla 20 milyon parametreli eğitilebilir bir projeksiyon başını birleştiriyor; gradyanları yalnızca baş alıyor. Nemotron DQA üzerinde tam ön eğitim tek bir RTX 4090’da yaklaşık bir saat sürüyor.
Üç aşamalı veri tarifi
Ön eğitim, Nemotron DQA’dan yaklaşık 60 milyon soru-cevap çiftini kapsıyor; soru durum, cevap ise eylem olarak ele alınıyor. Ara eğitimde Gemini 2.5 Flash-Lite ile üretilen yaklaşık 30 milyon sentetik zor negatif ekleniyor, son eğitimde ise Agent Data Protocol’ten yaklaşık 1 milyon ajan yörüngesi kullanılıyor.
Sonuçlar ve gecikme
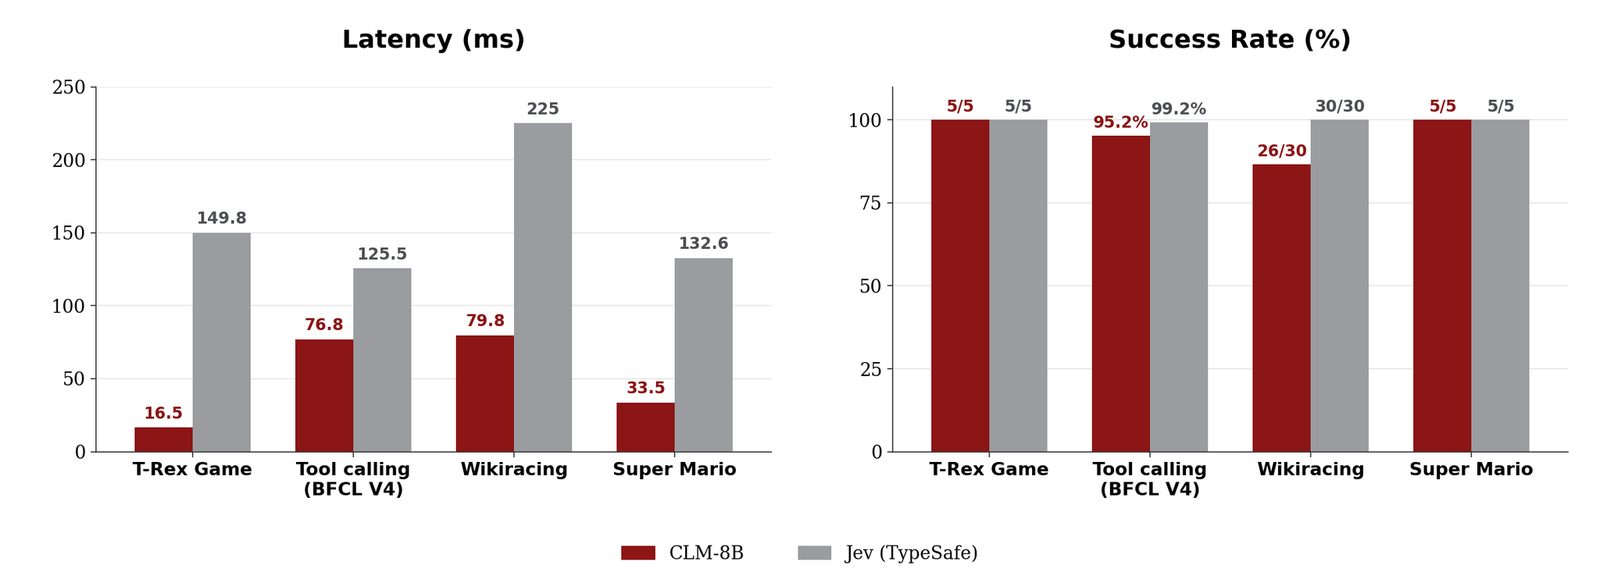
Bilgisayar kullanımı, oyun ve araç çağırma görevlerinde CLM-8B, Jev ile aynı seviyede performans gösterirken 9 kata kadar daha hızlı çalışıyor; yaklaşık 1.000 aday eylemde fark 13 kata çıkıyor. Yörünge doğrulayıcısı olarak ince ayarlanan model DeepSWE (81,6%) ve Terminal-Bench 2.1 (87,6%) testlerinde yeni bir rekor kırıyor; H100 GPU’da çıkarım Jev’den 4-6 kat hızlı ve doğrulama 38 ile 30 ayrılmış görevde yapıldı.
Altyapı ve sonraki adımlar
Sunum altyapısı durumları ve eylemleri ayırarak gömmelerinin bağımsız önbelleklenmesini sağlıyor: yalnızca durumun değiştiği Super Mario gibi ortamlarda her adım beş yerine tek ileri geçiş gerektiriyor. Ekip ayrıca ölçekleme yasalarını ortaya koydu: test kontrastif kaybı hesaplama, veri ve model boyutuyla üs yasasına göre düşüyor. Çok modlu CLM-35B şimdiden eğitiliyor ve gelecek ayın başında yayımlanması planlanıyor.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.