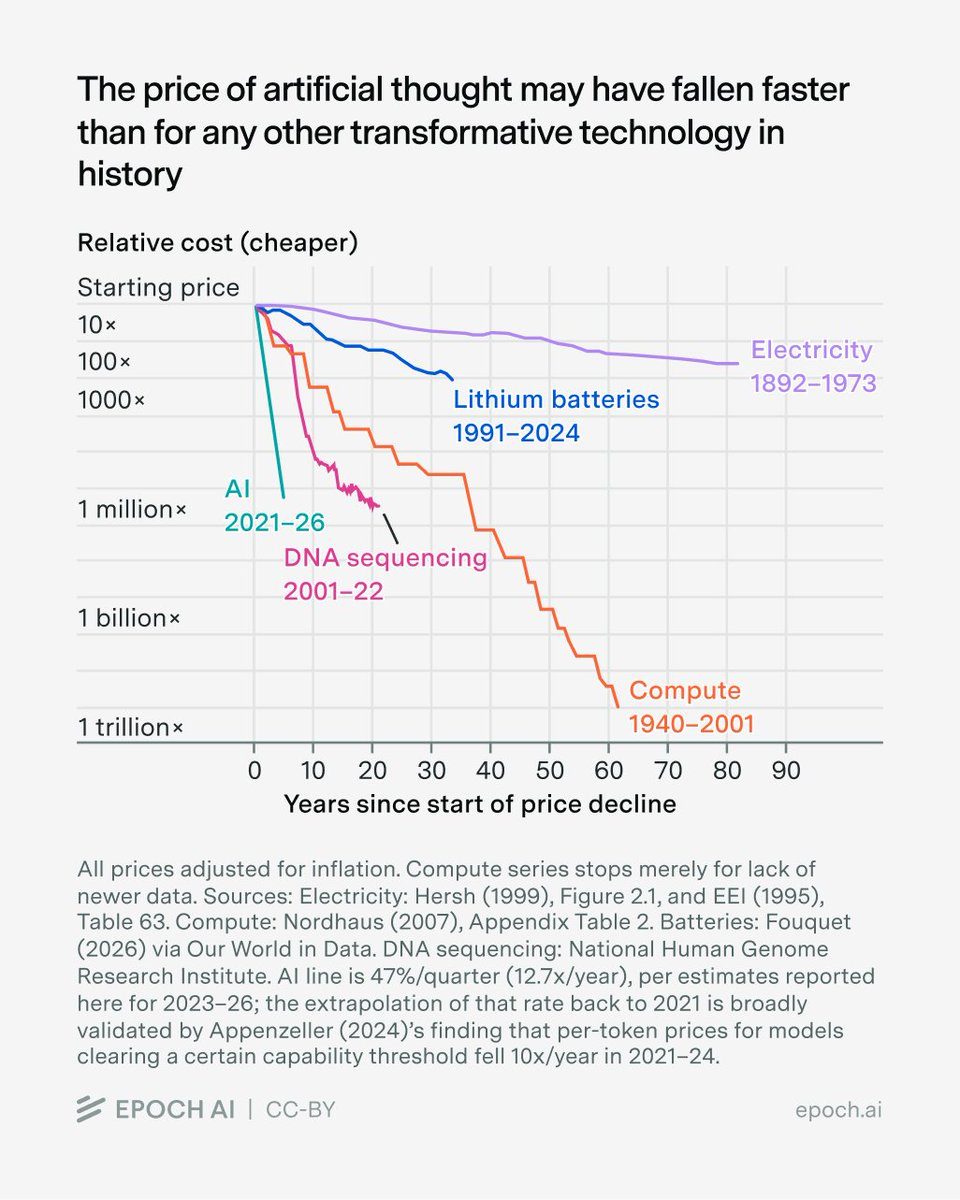
Epoch AI: Belirli bir AI performans düzeyinin maliyeti çeyrekte %47 düşüyor
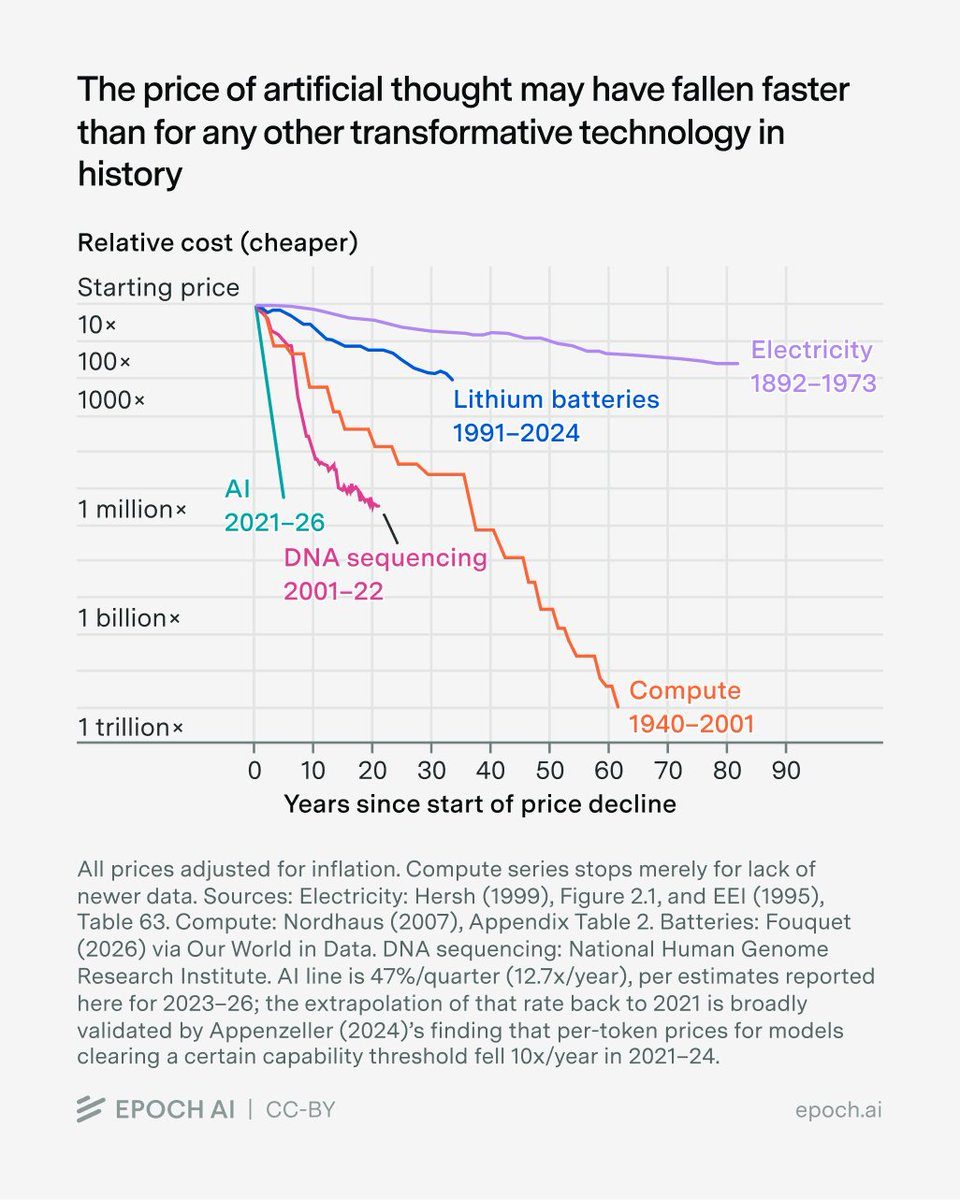
Epoch AI'nın yeni analizine göre belirli bir yapay zekâ performans düzeyine ulaşmanın maliyeti üç yılda çeyrek başına ortalama %47 azaldı; bu, yılda 13 katlık bir düşüş ve tarihteki diğer tüm dönüştürücü teknolojilerden daha hızlı.
Belirli bir yapay zekâ performans düzeyine ulaşmanın maliyeti son üç yılda çeyrek başına ortalama yaklaşık %47 azaldı. Bu, Emberson ve Roodman imzalı yeni bir Epoch AI raporunun sonucu. Söz konusu düşüş yılda 13 kata denk geliyor ve tarihteki diğer tüm dönüştürücü teknolojilerden daha hızlı. Ekonomi blogu Marginal Revolution da bulgulara dikkat çekti.
Rapor neyi ölçüyor
Araştırmacılar matematik, temel bilimler ve zekâ oyunlarını kapsayan beş kıyaslama testini inceledi ve "maliyet sınırını" izledi: herhangi bir anda belirli bir sonucu üretebilen en ucuz model. Bu maliyet ortalama olarak çeyrekte %47, yani yılda 13 kat azalıyor. Düşüş hızı göreve göre değişiyor: oyun tabanlı bulmacalar daha yavaş ucuzluyor — çeyrekte %39–43 — matematik ise daha hızlı: çeyrekte %50–52.
Hız sabit değil. Yeni bir yetenek ilk kez ortaya çıktığında kısa süre en ileri teknolojiyi temsil ediyor ve fiyatlar tam o dönemde en hızlı düşüyor: beş testin ortalamasında maliyet o aşamada çeyrekte %66 (yılda 75 kat) azalıyor, iki yıl sonra ise yarı hızda: çeyrekte %32, yani yılda 4,7 kat.
o3'ten GPT-5.6 Luna'ya: 725 kat daha ucuz
Raporun en çarpıcı örneği GPQA Diamond testi: fizik, kimya ve biyolojide doktora düzeyinde sorular. Epoch AI'nın tahminine göre Ocak 2025'te OpenAI'nin o3 modeli bu testte %75 puana soru başına ortalama yaklaşık 30 sentlik maliyetle ulaşıyordu. 18 aydan kısa süre sonra OpenAI, GPT-5.6 Luna'yı yayımladı; model aynı puanı soru başına 0,0004 dolara üretiyor — yaklaşık 725 katlık bir düşüş.
Neden önemli
Yazarlara göre mesele yalnızca modellerin akıllanması değil: aynı zekâ düzeyini çalıştırmak giderek çok daha az çıkarım (inference) harcaması gerektiriyor. Marginal Revolution bundan rekabetçi bir sonuç çıkarıyor: açık ağırlıklı modellerden gelen tehdit göründüğü kadar büyük değil, çünkü öncü modeller yalnızca eskilerini geçmiyor, aynı performans düzeyinde hızla daha ucuza çalışıyor.
Yazarlar bulguların bazı kayıtlar gerektirdiğini vurguluyor. Kıyaslama testleri gerçek işin kusursuz ölçüsü değil ve şirketler modellerini bilinen testlere göre bilinçli olarak eğitebiliyor. Hesaplar ayrıca her görev için en ucuz modeli seçen bir kullanıcıyı varsayıyor; gerçek kullanıcılar bunu nadiren yapıyor. Üstelik ucuzlayan fiyat, düşen harcama anlamına gelmiyor: bir iş bir milyon test çalıştırması kadar düşünme gerektiriyorsa, fatura bir kuruşluk fiyattan bile birikir.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.