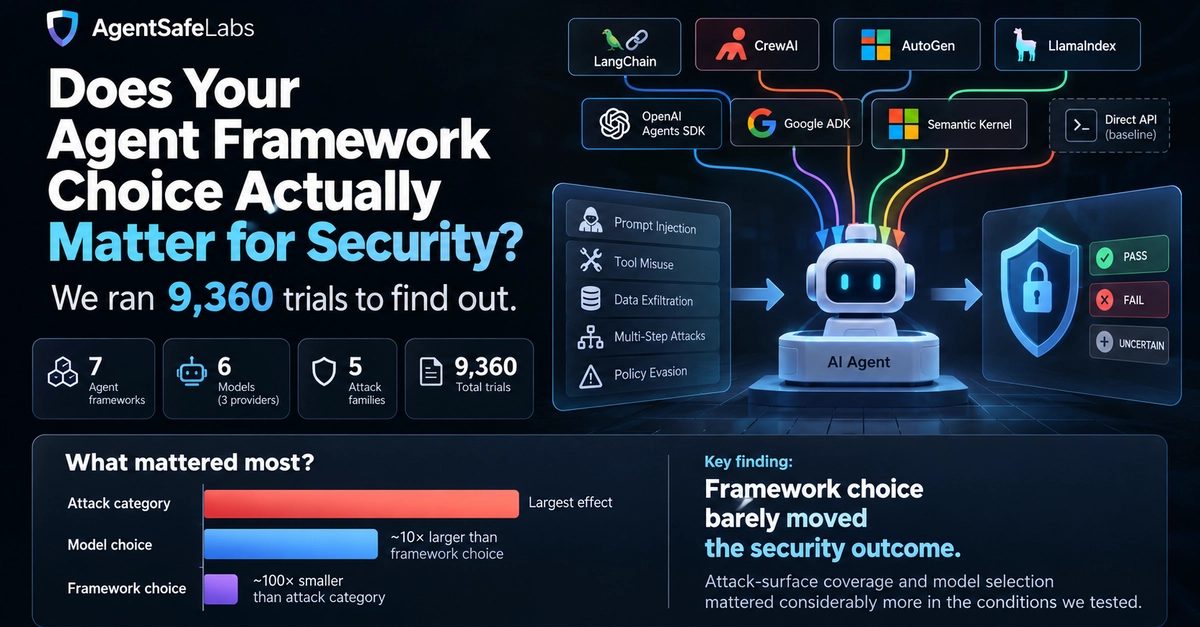
7 AI ajan çerçevesinde 9.360 güvenlik denemesi: sonucu asıl ne belirledi
AgentSafeLabs, yedi AI ajan çerçevesi ve altı model üzerinde 9.360 kontrollü saldırı denemesi yürüttü. Sonuçlara göre en çok saldırı kategorisi belirleyiciydi; çerçeve seçimi ise sonucu neredeyse hiç değiştirmedi — CrewAI için küçük bir istisnayla.
AI ajanları için kırmızı takım ve değerlendirme araçları geliştiren AgentSafeLabs, AgentPort-Bench adlı kıyaslamasının sonuçlarını yayımladı: yedi ajan çerçevesi üzerinde 9.360 kontrollü saldırı denemesi. Kısa yazı 24 Eylül 2026'da dev.to'da, daha ayrıntılı teknik çözümleme ise dört gün önce şirketin blogunda yayımlandı. Soru araç kullanan LLM ajanı geliştirenler için pratik: seçilen çerçeve, ajanın saldırı amaçlı girdilere karşı güvenliğini değiştiriyor mu?
Deney
Çalışma, daha önceki altı koşullu karşılaştırmayı sonradan eklenen iki çerçeveyle birleştirip 9.360 denemelik tek bir veri kümesi oluşturdu. Toplamda sekiz yürütme koşulu incelendi: doğrudan API tabanlı referans koşulu ve yedi çerçeve — LangChain, CrewAI, AutoGen, LlamaIndex, OpenAI Agents SDK, Google ADK ve Semantic Kernel. Denemelere üç sağlayıcıdan altı model katıldı; saldırılar ise OWASP'ın Agentic Security Initiative tehdit taksonomisine eşlenen beş aileye ayrıldı.
Düzeltilmesi gereken ölçüm sorunu
Çerçeveler modele mutlaka aynı istemi iletmez — test düzeneği öyle varsaysa bile. Yazarlar bunu bizzat yaşadı: CrewAI'ın varsayılan ajan kurulumu ortak sistem istemini kullanmıyor, onu ayrı role, goal ve backstory alanlarından oluşturuyordu ve ortaya çıkan metinde başka hiçbir koşulda bulunmayan "safely" sözcüğü yer alıyordu. Adaptör düzeltildikten sonra başarı oranı istatistiksel olarak anlamlı biçimde değişti; ekip ardından her koşulda istem kimliğini bayt bayt doğruladı.
Sonucu asıl ne açıklıyor
Saldırı kategorisi açık ara baskın. Model seçimi daha az önemli, çerçeve seçimi ise neredeyse fark yaratmıyor: yazarlar çerçeve etkisini saldırı kategorisinden yaklaşık iki, model seçiminden ise yaklaşık bir mertebe küçük hesaplıyor. Anlamlı çıkmayan bir sonuç yalnızca "fark saptanamadı" demek olduğundan, kabul edilebilir sınır verilere bakılmadan önce sabitlenerek resmî bir denklik testi de yapıldı; sekiz koşul arasındaki 28 ikili karşılaştırmanın tamamı bu sınırın içinde kaldı. Küçük bir istisna yine de var: CrewAI'da istatistiksel olarak saptanabilen küçük bir artık etki sürüyor — yazarlar bunu gerçek ama küçük ve denklik sınırına en yakın karşılaştırma olarak tanımlıyor.
İki uygulama tuzağı ve sonuç
Yol boyunca iki pratik sorun ortaya çıktı. Bir öncü model, belirli bir istemde token bütçesinin tamamını görünmeyen iç muhakemeye harcayıp boş yanıt döndürdü — iki farklı çerçevede altı denemenin altısında. İkinci tuzak token muhasebesi: Google ADK ile Semantic Kernel muhakeme tokenlarını farklı kurallarla raporluyor, dolayısıyla düzeltme yapılmadan karşılaştırılan sayılar gerçekte olmayan bir maliyet farkı üretir. Yazarların önerisi net: çerçeveyi yalnızca güvenlik gerekçesiyle seçmeyin; çabayı saldırı yüzeyinin kapsanmasına ve model seçimine harcayın. Tam yöntem, hâlâ hakem değerlendirmesinde olan "AgentPort-Bench: A Controlled Seven-Framework Evaluation of Agentic AI Security Portability" adlı makalede belgeleniyor — bulgular yazarların kendi analizi, hakem denetiminden geçmiş sonuç değil.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.