RLCD nedir? Jev'in arkasındaki kalibre karar modeli
RLCD, çok yönlü tercih modellemesine olasılık kalibrasyonunu ekleyen, şemaya koşullu bir Plackett-Luce hedefidir. Teknik bir yazıya göre Jev'in arkasındaki ödül modeli artık bir üreticinin arkasına saklanmıyor, ürünün kendisi hâline geliyor.
di-zhang-llm blogundaki teknik bir yazı, RLCD'yi TypeSafe'in karar modeli Jev'in arkasındaki sır olarak tanımlıyor: çok yönlü tercih modellemesi artı olasılık kalibrasyonu, daha kesin bir ifadeyle şemaya koşullu bir Plackett-Luce hedefi. Jev bu hedefi tipli çıktılar ve paralel inference ile bir ürüne dönüştürüyor ve ödül modeli artık üreticinin arkasına saklanmıyor: modelin kendisi oluyor.
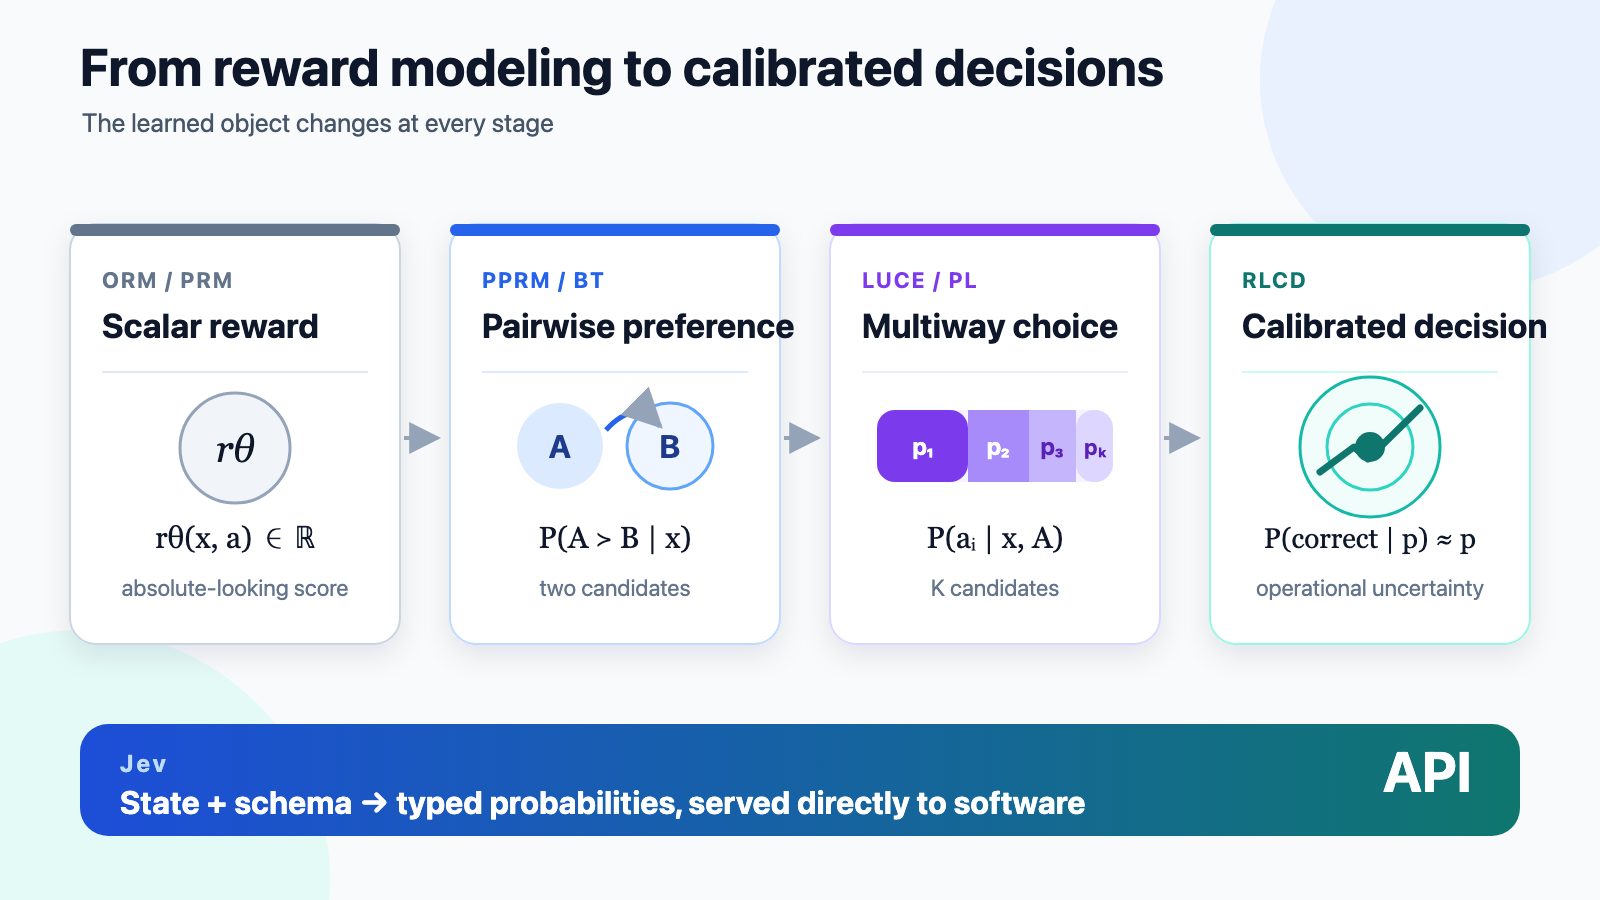
Skaler ödülden tercih olasılığına
Klasik ödül modeli bir bağlam ve aday yanıt için tek sayı döndürür, ama yazıya göre bu sayı mutlak değil: 0,8 farklı problemler veya aday havuzları arasında istikrarlı anlam taşımıyor. LLaMA-Berry'nin Pairwise Preference Reward Model'i (PPRM) gerçek sinyali Bradley-Terry olasılığıyla açık hâle getirdi ve neredeyse 7,8 milyon matematik çözümü çiftiyle DPO kullanılarak eğitildi.
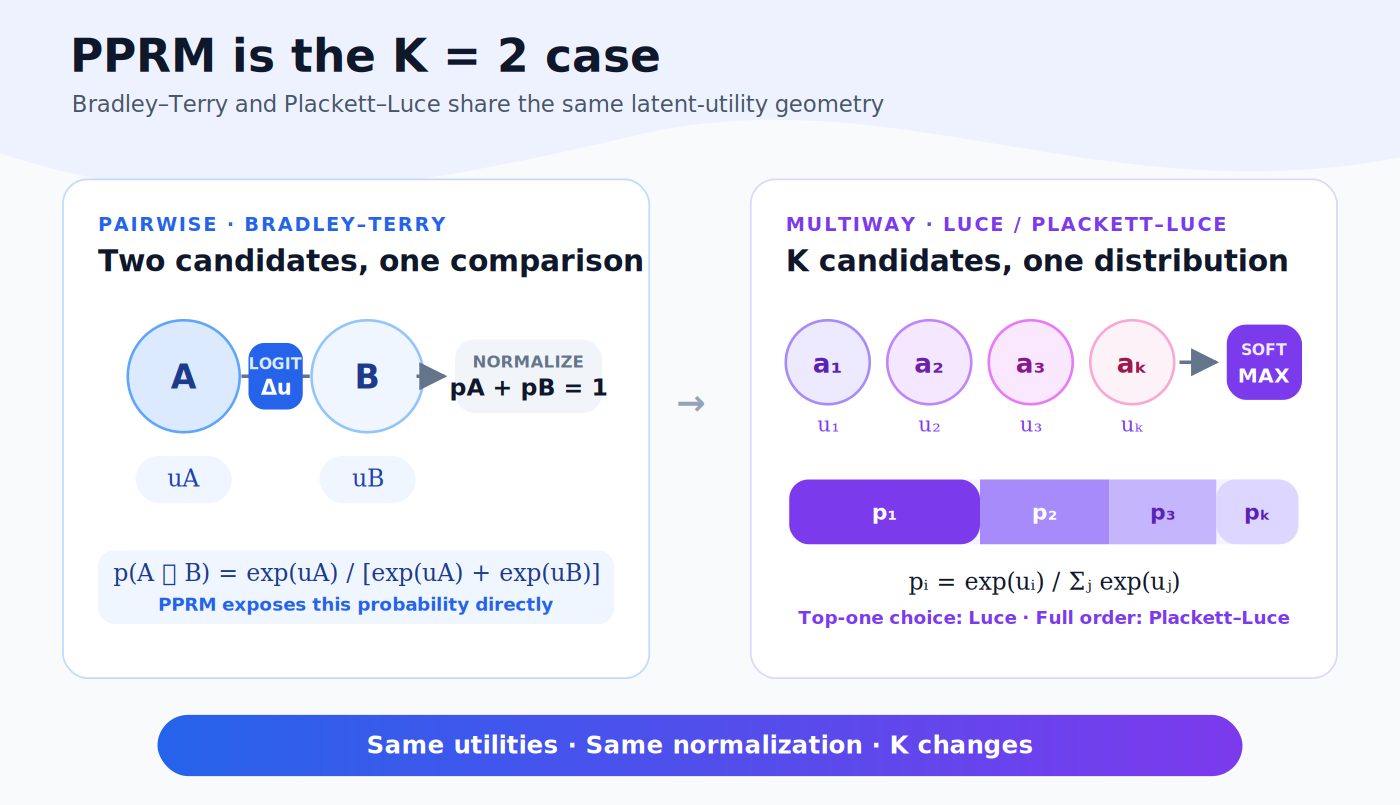
Plackett-Luce, çok yönlü PPRM'dir
Karar arayüzleri genellikle ikiden fazla aday görür. Luce seçim modeli, diğer adıyla multinomial logit, her aday için bir fayda normalize eder; iki aday olduğunda tam olarak Bradley-Terry'ye indirgenir. Tam sıralama verildiğinde Plackett-Luce olabilirliği kalan en iyi adayı seçer; yazı bunu RLCD'nin matematiksel merkezi olarak adlandırıyor.
Kalibrasyon dağılımı karara dönüştürür
Normalizasyon kalibrasyon değildir: softmax her zaman bire toplanır, ama bu 0,8 olarak bildirilen bir tahminin yüzde 80 doğru olduğu anlamına gelmez. Sözleşme şu: 0,8 olasılığı atanan tahminlerin yaklaşık yüzde 80'i doğru olmalı ve yazıya göre TypeSafe Jev için aynı şeyi vaat ediyor.
Brier skoru hedefe fiyat biçer: p=0,8 bildirilen karar, olay olduğunda 0,04, olmadığında 0,64 puan alır; kendinden emin biçimde yanlış tahmin, doğru olandan on altı kat pahalıdır. Kalibre edilmiş güven, yazılımın kararı uygulamasını ya da devretmesini belirler.
Jev değerlendiriciyi arayüz yapar
Olağan RLHF yığınında ödül modeli arka planda, üreticinin arkasında kalır. Jev bunu tersine çevirir: içeri durum ve aday şeması girer, dışarı kalibre edilmiş bir karar dağılımı çıkar. Noul, Choice ve Score, tek nesne üzerindeki üç şemadır: bir durum, soru ve aday kümesi verildiğinde tipli bir sonucun olasılığı.
Yazı paralel inference iddiasını da ayrıştırıyor: markayı bir kenara bırakınca örnekleyici, sequence packing, attention mask ve tipli karar başlıklarından oluşuyor; böylece tek forward pass tüm adayları token token üretim döngüsü olmadan puanlıyor. Yazara göre TypeSafe yeni bir mimari duyuruyor ama ne yeni bir attention operatörü ne de ablasyon yayımlıyor.
Sonuçta RLCD'yi tanımlayan şey çıktı sözleşmesi: tipli bir olasılık dağılımı. Jev, ödül modelinin ürünü notlamayı bırakıp ürünün kendisi olduğu durumdur.
SiTech — AI destekli web geliştirme
Hızlı ve modern web siteleri kuruyor, AI'yı gerçek iş akışlarına taşıyoruz. Projeniz veya sorunuz mu var? Yardımcı olmaktan mutluluk duyarız.