Cerebras пояснює розгортання трильйонно-параметричних AI-моделей на вафельних чіпах
Cerebras описує, як він розподіляє великі передові моделі між вафелями WSE-3T, використовуючи Kimi K3 як приклад для пояснення пам'яті на чіпі, конвеєрної обробки та роботи з одночасними запитами.
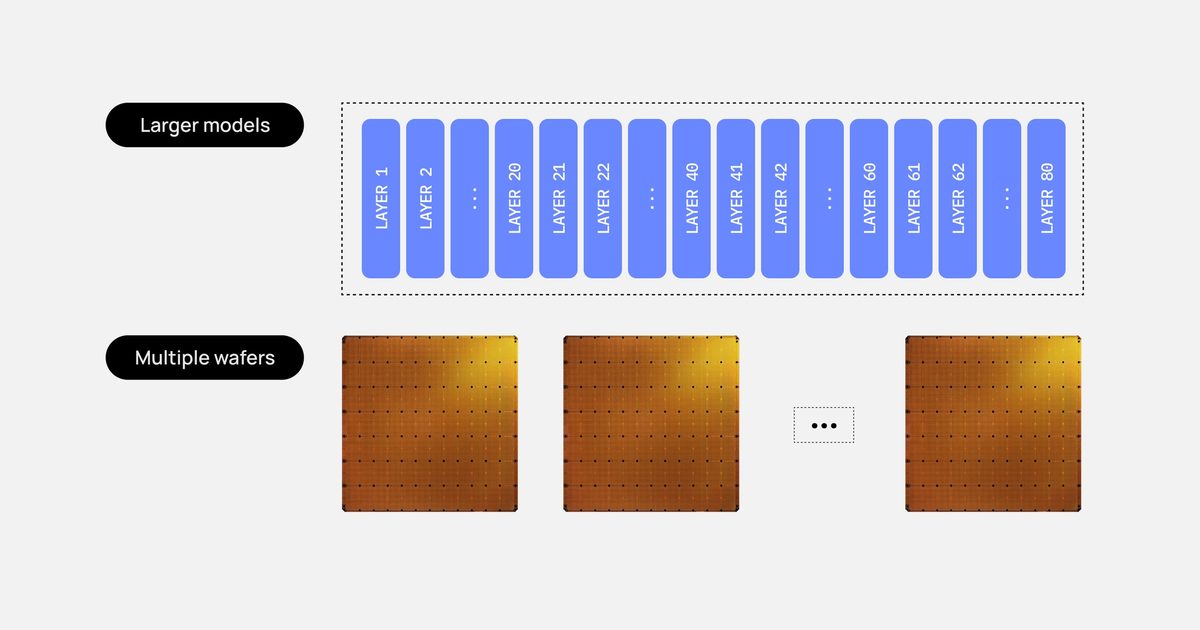
Cerebras опублікував пояснення того, як він розгортає трильйонно-параметричні передові моделі на своїх вафельних чіпах. Один вафель Cerebras WSE-3T має 44 ГБ пам'яті на чіпі, тоді як трильйонно-параметричні моделі потребують терабайтів лише для своїх ваг. Компанія заявляє, що розділяє велику модель на кілька вафелів WSE-3T, щоб запускати багатотрильйонно-параметричні моделі зі швидкістю 1000-2000+ токенів у секунду.
Kimi K3 як приклад
Cerebras використовує модель Kimi K3 з відкритим кодом як ілюстративний приклад. Kimi K3 має приблизно 3 трильйони параметрів, з 69 шарами лінійної уваги та 24 щільними шарами. Cerebras заявляє, що Kimi K3 набирає 88.3% на Terminal-Bench 2.1 проти 88.8% для GPT-5.6 Sol, та 91.2% на BrowseComp проти 90.4% для GPT-5.6 Sol. Cerebras каже, що ці результати демонструють передові можливості кодування та агентні здібності, при цьому модель перевершує провідні пропрієтарні моделі на деяких бенчмарках.
Для прикладу Cerebras припускає середній розмір запиту 256k, 4-бітну квантизацію ваг та 8-бітний KV-кеш. Він розраховує розмір кожного шару моделі, а потім розділяє модель на 93 шари. Результат становить приблизно 16 ГБ на шар.
Відображення шарів на вафелях
Ємність 44 ГБ кожного вафеля WSE-3T визначає, скільки шарів поміститься на вафелі, і відповідь залежить від типу шару. Щільні шари потребують додаткового місця для KV-кешу, оскільки кожен щільний шар повної уваги зберігає ключі та значення для кожного токену в кожному активному запиті. Тому Cerebras розміщує один щільний шар на вафелі та залишає решту SRAM для його KV-кешу.
Шари лінійної уваги не потребують додаткового місця для KV-кешу. Замість зберігання ключів і значень для кожного токена шар лінійної уваги тримає невеликий стан фіксованого розміру на запит, незалежно від довжини контексту. Це звільняє місце для двох лінійних шарів на вафелі, у сумі 2 x 16 ГБ = 32 ГБ. З 69 шарами лінійної уваги та 24 щільними шарами розподіл дає 35 вафелів для лінійних шарів плюс 24 вафелі для щільних шарів, всього 59 вафелів.
Конвеєрне виконання та одночасність
Cerebras виконує моделі в конвеєрі. Компілятор відображає шари моделі по регіонах вафелів, а середовище виконання прокладає шлях для потоку токенів між вафелями. Між вафелями мають проходити лише активації, і це можна зробити через RDMA над Ethernet приблизно за 2 мікросекунди на перехід. Оскільки кожен вафель має 44 ГБ SRAM на чіпі, а кожен шар становить приблизно 16 ГБ, цілі шари зазвичай можуть поміститися безпосередньо на чіпі. У більшості випадків ваги моделі ніколи не треба переміщувати, і шари не потребують розділення між вафелями.
Кожен вафель діє як один етап складальної лінії. Наприклад, вафель 1 виконує шари 1-2 та надсилає активації на вафель 2, який виконує шари 3-4 і передає результати далі, доки останній вафель не видасть наступний токен. Для обслуговування багатьох запитів Cerebras тримає конвеєр повним різними запитами. Кожен етап може працювати з різним запитом одночасно, і кожен етап може обробляти мікропакет замість окремого запиту. Менші мікропакети роблять кожен запит швидшим, тоді як більші мікропакети збільшують загальну пропускну здатність.
Кількість пам'яті на чіпі, виділеної під KV-кеш, визначає максимальну кількість одночасних запитів. Кожен активний запит потребує власного KV-кешу на кожному вафелі з щільними шарами. Cerebras зазначає, що ані одночасність, ані розмір пакета самі по собі не показують ефективність інференсу; більш значуща метрика - загальна пропускна здатність токенів на одиницю потужності, вимірювана при однаковій швидкості генерації виводу.
Джерела: cerebras.ai
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.