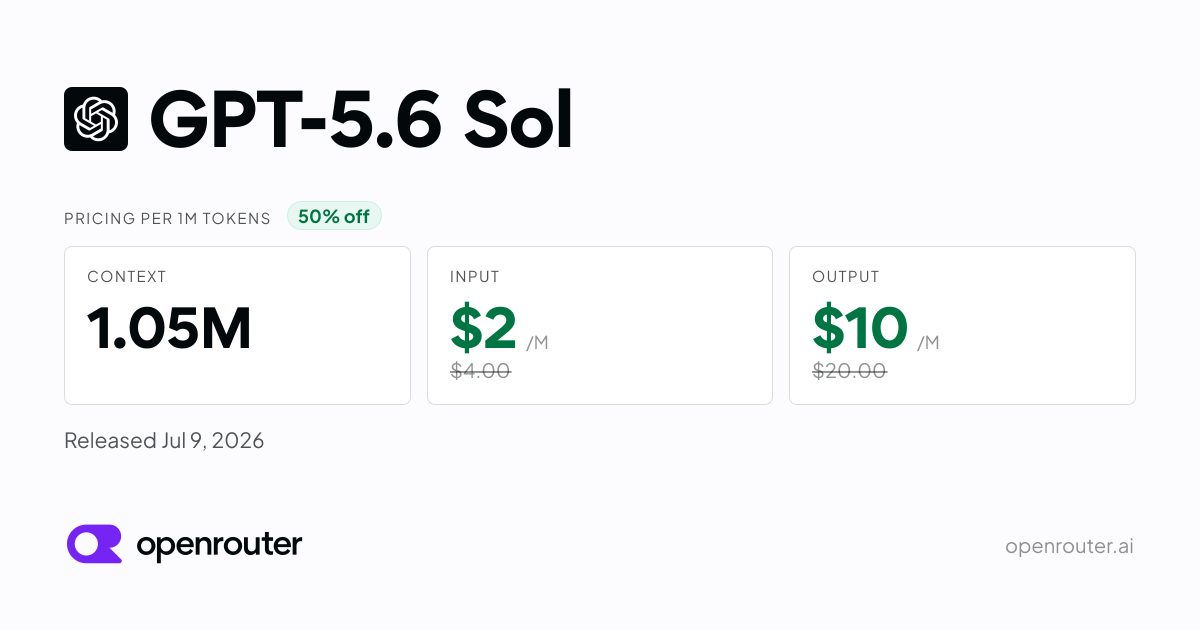
Ціну GPT-5.6 Sol на OpenRouter знижено на 50%
На сторінці GPT-5.6 Sol в OpenRouter тепер діє знижка 50%: $2 за мільйон вхідних токенів і $10 за мільйон вихідних. Знижку отримали стандартний, Fast і Flex ендпоінти OpenAI, а Azure та Bedrock свої ціни зберегли.
На сторінці моделі openai/gpt-5.6-sol в OpenRouter тепер позначено знижку 50% для ендпоінтів самої OpenAI. У заголовку цін вказано $2 за мільйон вхідних токенів і $10 за мільйон вихідних — це ставка стандартного ендпоінта OpenAI з урахуванням знижки.
Які ендпоінти подешевшали
За таблицею провайдерів, стандартний ендпоінт OpenAI до зниження коштував $4 за вхідні та $20 за вихідні токени на мільйон, а тепер — $2 і $10. OpenAI Fast, найшвидший варіант, подешевшав з $8/$40 до $4/$20, а OpenAI Flex — з $2/$10 до $1/$5. У рядках Azure і Amazon Bedrock знижки не видно: Azure просить $5/$30, Azure у США та ЄС — $5.50/$33, Amazon Bedrock (США) — $4.40/$22 за мільйон токенів.
Скільки насправді платять користувачі
OpenRouter окремо показує середньозважену ціну, тобто те, що клієнти платять насправді. Нині це $0.6271 за мільйон вхідних токенів і $14.96 за мільйон вихідних. Різницю здебільшого пояснює кешування: на ендпоінт OpenAI припадає 83% трафіку на сторінці, а частка влучань у кеш становить 91.5%, що знижує ефективну ціну входу до $0.4625 за мільйон токенів. Після знижки читання з кешу коштує $0.20 за мільйон токенів на стандартному ендпоінті, $0.40 у Fast і $0.10 у Flex.
Що це за модель
GPT-5.6 Sol — флагман лінійки GPT-5.6 від OpenAI. OpenRouter описує його як модель для складних міркувань, програмування та агентних робочих процесів, особливо сильну в задачах командного рядка, багатокрокового коду та довготривалого розв'язування проблем. Контекстне вікно становить 1.1 мільйона токенів, а вийшла модель 9 липня 2026 року. Запити можна спрямовувати в трьох режимах: Balanced (ціна й швидкість), Nitro (найшвидший провайдер) і Exacto (найвища точність виклику інструментів).
Чому це важливо
Зниження на 50% з'являється саме тоді, коли тривалі агентні задачі роблять витрати на токени головною статтею бюджету команд, що працюють на хостингових моделях. Різниця між швидким і стандартним ендпоінтами тепер двократна, хоча Fast дає найнижчу затримку на сторінці — 2.62 секунди — і найвищу пропускну здатність — 70 токенів за секунду. Flex найдешевший, але має затримку 13.14 секунди та доступність 88.21%, тоді як стандартний ендпоінт OpenAI показує 99.43%.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.