NVIDIA DSX MaxLPS: пропускна здатність AI-фабрики зросла на 49% за того самого бюджету
Спільний тест NVIDIA і Nscale на системах GB300 NVL72 в Ісландії задіяв 192 GPU замість 140 у межах того самого бюджету 264,4 кВт: сукупна пропускна здатність зросла на 49,2%, а швидкість окремих інстансів майже не змінилася.
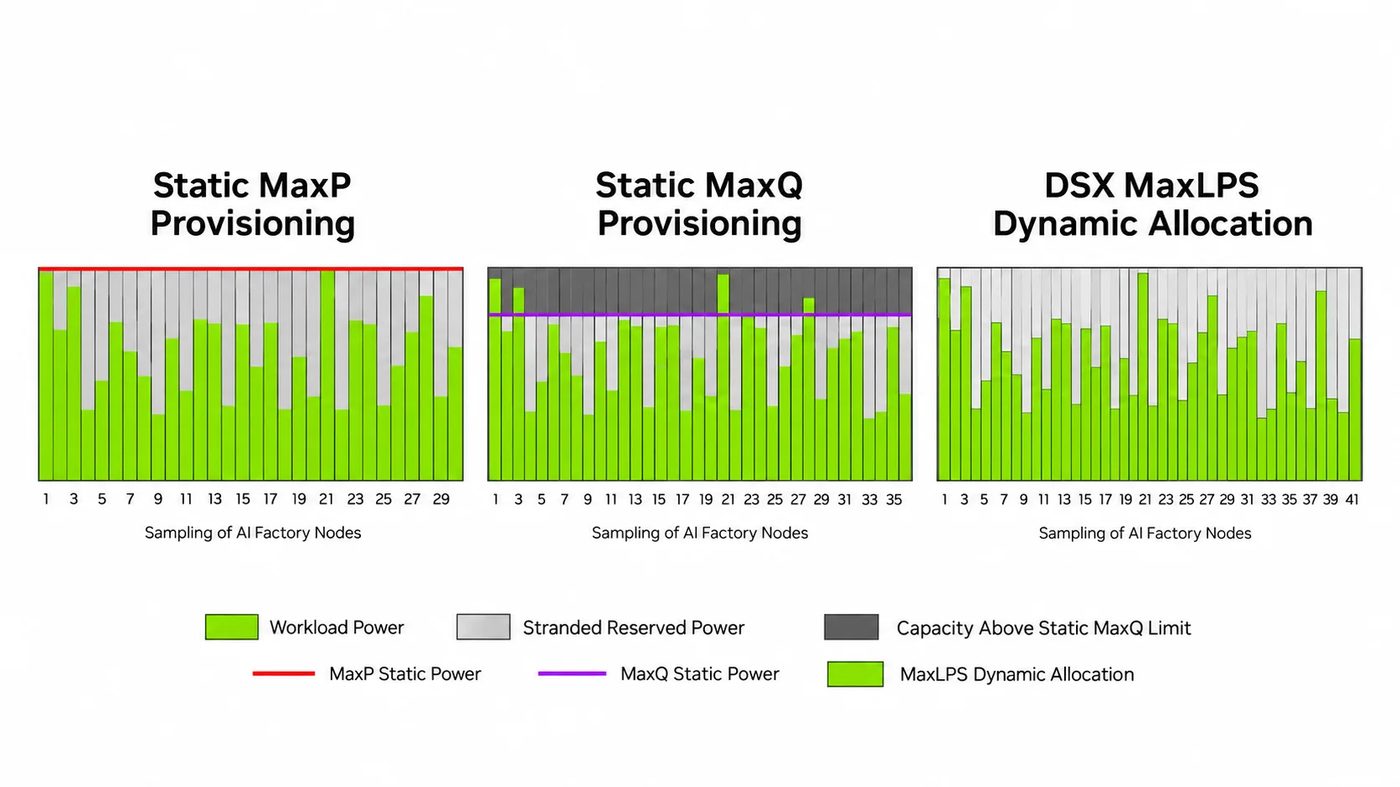
NVIDIA опублікувала на блозі для розробників технічний огляд DSX MaxLPS — рівня керування живленням, який динамічно розподіляє потужність між GPU в центрі даних для AI, замість фіксованого піку для кожного вузла. У статті від 27 вересня 2026 року автори Sarah McKenney і Harry Petty зазначають, що підхід дає змогу розмістити до 40% більше GPU в межах того самого затвердженого бюджету.
Чому статичне резервування залишає потужність невикористаною
AI-фабрика працює в ієрархії електричних обмежень: від підключення до мережі та підстанцій до стійок, вузлів і GPU. Оператори зазвичай резервують стільки, щоб усі прискорювачі одночасно досягли піку, хоча реальні навантаження поводяться інакше: під час навчання обчислення чергуються з комунікацією та контрольними точками, а інференс переходить між prefill, decode, роботою, обмеженою пам'яттю, та простоєм. За статичних резервів вільна потужність одного вузла не може бути передана іншому, і DSX MaxLPS відповідає на це моніторингом фактичного споживання та перерозподілом потужності в межах правил оператора.
Як проводили оцінювання
Nscale розгорнула програмне забезпечення у своєму центрі даних на кампусі Verne у Кефлавіку в Ісландії, а навантаження запускала NVIDIA на системах GB300 NVL72 з GPU Blackwell Ultra та Kimi K2.5 у FP4. Базовий варіант використовував 140 GPU, а конфігурація MaxLPS — 192 GPU, додавши третій високопродуктивний інстанс на 52 GPU за того самого бюджету 264,4 кВт.
Що показали вимірювання
Нормалізована сукупна пропускна здатність зросла на 49,2%: з 1 084 503 до 1 618 443 токенів за секунду, а показник на виділений ват — з 4,10 до 6,12 токена/с/Вт. Результат окремих інстансів майже не змінився: 59 220 токенів за секунду для високопродуктивних проти 59 153 у базовому варіанті.
Середня потужність GPU зросла з 97,0 кВт до 131,8 кВт, а використання бюджету — з 62,9% до 75,2%. Медіанна та P75 латентність залишилися в межах 5% від базової, але P99 часу до першого токена погіршився на 17%.
Що мають перевірити оператори
NVIDIA рекомендує п'ять етапів: визначити межу керування та її застосовний ліміт, зафіксувати репрезентативний базовий рівень за статичного резервування, обережно ввести правила близько до нього, поетапно додавати потужність із перевіркою на кожному кроці та лише потім затвердити виробничі ліміти.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.