Дифузійна модель Mercury 2.5 від Inception видає 770 токенів за секунду
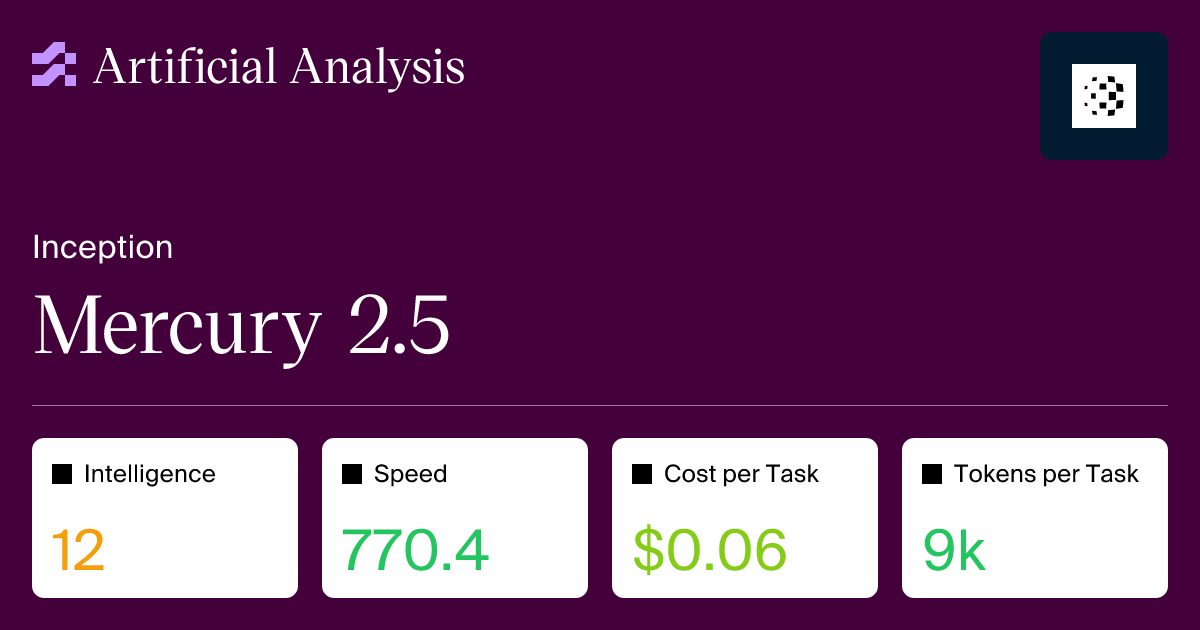
За вимірюваннями Artificial Analysis, дифузійна модель Mercury 2.5 від Inception видає 770,4 токенів за секунду; контекст — 260 тис. токенів, ціна — 0,25 долара за мільйон вхідних токенів.
Компанія Inception випустила Mercury 2.5 8 вересня 2026 року — закриту дифузійну велику мовну модель (dLLM), яку компанія називає найшвидшою reasoning-моделлю у продакшені. На відміну від авторегресійних моделей, що пишуть текст токен за токеном, Mercury 2.5 будує відповідь паралельно й уточнює її поетапно.
770 токенів за секунду
За вимірюваннями Artificial Analysis, через API Inception модель видає 770,4 вихідних токенів за секунду — значно більше за медіану 110,3 токена для reasoning-моделей у її ціновій категорії. Сама Inception заявляє понад 1100 токенів за секунду у продакшені. Час до першого токена відповіді — 2,91 секунди, трохи вище за медіану категорії (2,22 секунди).
Модель приймає та видає лише текст: зображення вона не обробляє. Модель закрита, її ваги публічно не доступні. Контекстне вікно — 260 тис. токенів (приблизно 390 сторінок A4), проти 128 тис. у Mercury 2.
Оцінки та ціна
В Intelligence Index (v4.3.2) від Artificial Analysis Mercury 2.5 набирає 12 балів — на рівні медіани категорії. На індексі модель витратила 35 млн вихідних токенів — менш ніж половину медіани у 84 млн; аналітики називають це досить лаконічним. Оцінювання одного завдання коштує в середньому 0,06 долара.
Ціни за API Inception: 0,25 долара за мільйон вхідних токенів і 0,75 долара за мільйон вихідних; знижка на кеш — 90%, змішана ставка — 0,14 долара за мільйон токенів. На старті діє знижка 80% в OpenRouter — 0,04 і 0,15 долара за мільйон токенів.
Чому це важливо
Дифузійна генерація орієнтована на сценарії з низькою затримкою — пошук, голосові асистенти, кодинг-агенти, де швидкість і ціна не менш важливі за можливості. За словами Inception, Mercury 2.5 на 10 пунктів інтелектуальніша за Mercury 2 і порівнянна з економними фронтир-моделями — GPT-5.6 Luna, Gemini 3.5 Flash-Lite та Claude Haiku 4.5. Модель отримала регульоване міркування, вбудовану підтримку інструментів, режим JSON і паралельні виклики інструментів; вона доступна через API Inception, OpenRouter і Baseten. Inception каже, що вже тренує свою найбільшу модель і планує випустити її найближчими місяцями.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.