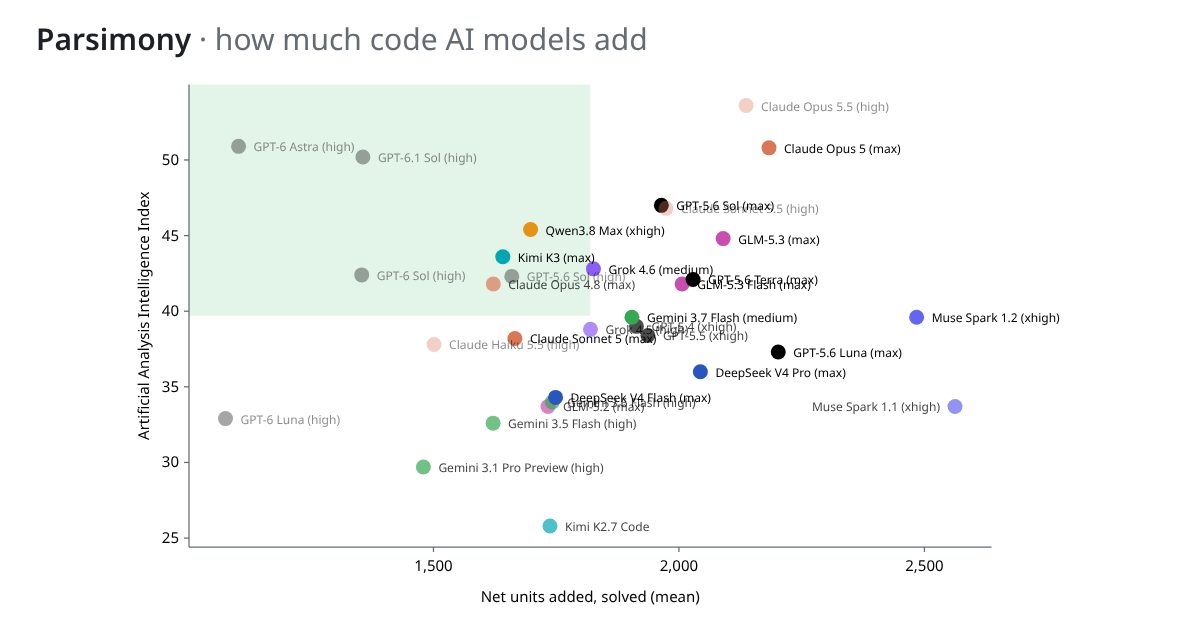
Новий бенчмарк Parsimony оцінює AI агентів кодування за доданим кодом
Parsimony — це бенчмарк, який вимірює, скільки коду додають AI агенти кодування під час вирішення задач. Він рахує синтаксичні одиниці, а не рядки, віднімає видалений код і ранжує моделі за середніми чистими одиницями, доданими на SWE-bench Verified.
Існуючі AI бенчмарки кодування вимірюють відсоток вирішених задач і витрати, але не штрафують за зайвий код, що з часом може ускладнити роботу з кодовою базою. Parsimony, новий бенчмарк, використовує інший підхід: він вимірює, скільки коду додають AI моделі під час вирішення задачі.
Як працює Parsimony
Parsimony бере ті патчі, які бенчмарки вже публікують, і рахує одиниці кодування, тобто синтаксичні елементи, такі як інструкції, виклики, порівняння, імена та літерали. Рядки не враховуються, тому стиснення коду в меншу кількість рядків не заохочується. Видалений код віднімається, що дає просту формулу: чисті одиниці дорівнюють доданим мінус видалені. Кожен патч застосовується до коду задачі, і обидві версії кожного зміненого файлу парсяться; нічого не виконується. Тести, документація та згенеровані файли виключені, і вимірюється лише Python. Успішні та неуспішні результати беруться з опублікованих результатів SWE-bench, і тести повторно не запускаються.
Як читати лідерборд
Моделі ранжуються за середніми чистими одиницями, доданими на вирішених задачах, починаючи з найнижчої. Фігура „Net units added (mean)" також включає невдалі спроби. Стовпець „Solved" походить з SWE-bench Verified, тоді як „Measured" показує, скільки вирішених спроб можна було виміряти. Artificial Analysis Intelligence Index відображається як зовнішній бал, порівняно з інтелектом моделі та силою міркувань, але не впливає на ранжування. Прикріплені записи автор запустив на дошці на перших 3-10 задачах DeepSWE Python, з використанням pi для моделей OpenAI та Claude Code для моделей Anthropic, і оцінив власними тестами кожної задачі; вони не верифіковані та не ранжовані. GPT-5.6 Sol пройшов обома шляхами, і запуск автора додав 0,88 коду опублікованого запуску.
Обмеження та застереження
Проєкт зазначає, що менше не завжди краще: одиниці вимірюють розмір, а не читабельність чи дизайн. Моделі, які пишуть більше коду, зазвичай вирішують і більше задач, з кореляціями Спірмена від 0,33 до 0,60 на дошках, де 26 або більше моделей. Кожна модель використовує одного й того самого агента, mini-SWE-agent, але агент все одно впливає на те, скільки коду пишеться.
Додавання власного бенчмарку
Читач, у якого є цифри розміру коду з іншого бенчмарку, може завантажити приклад JSON файлу, заповнити власні результати та відкрити його, щоб отримати ту саму діаграму й таблицю. Файл залишається в браузері.
Джерела: parsimony.lasu.dev
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.