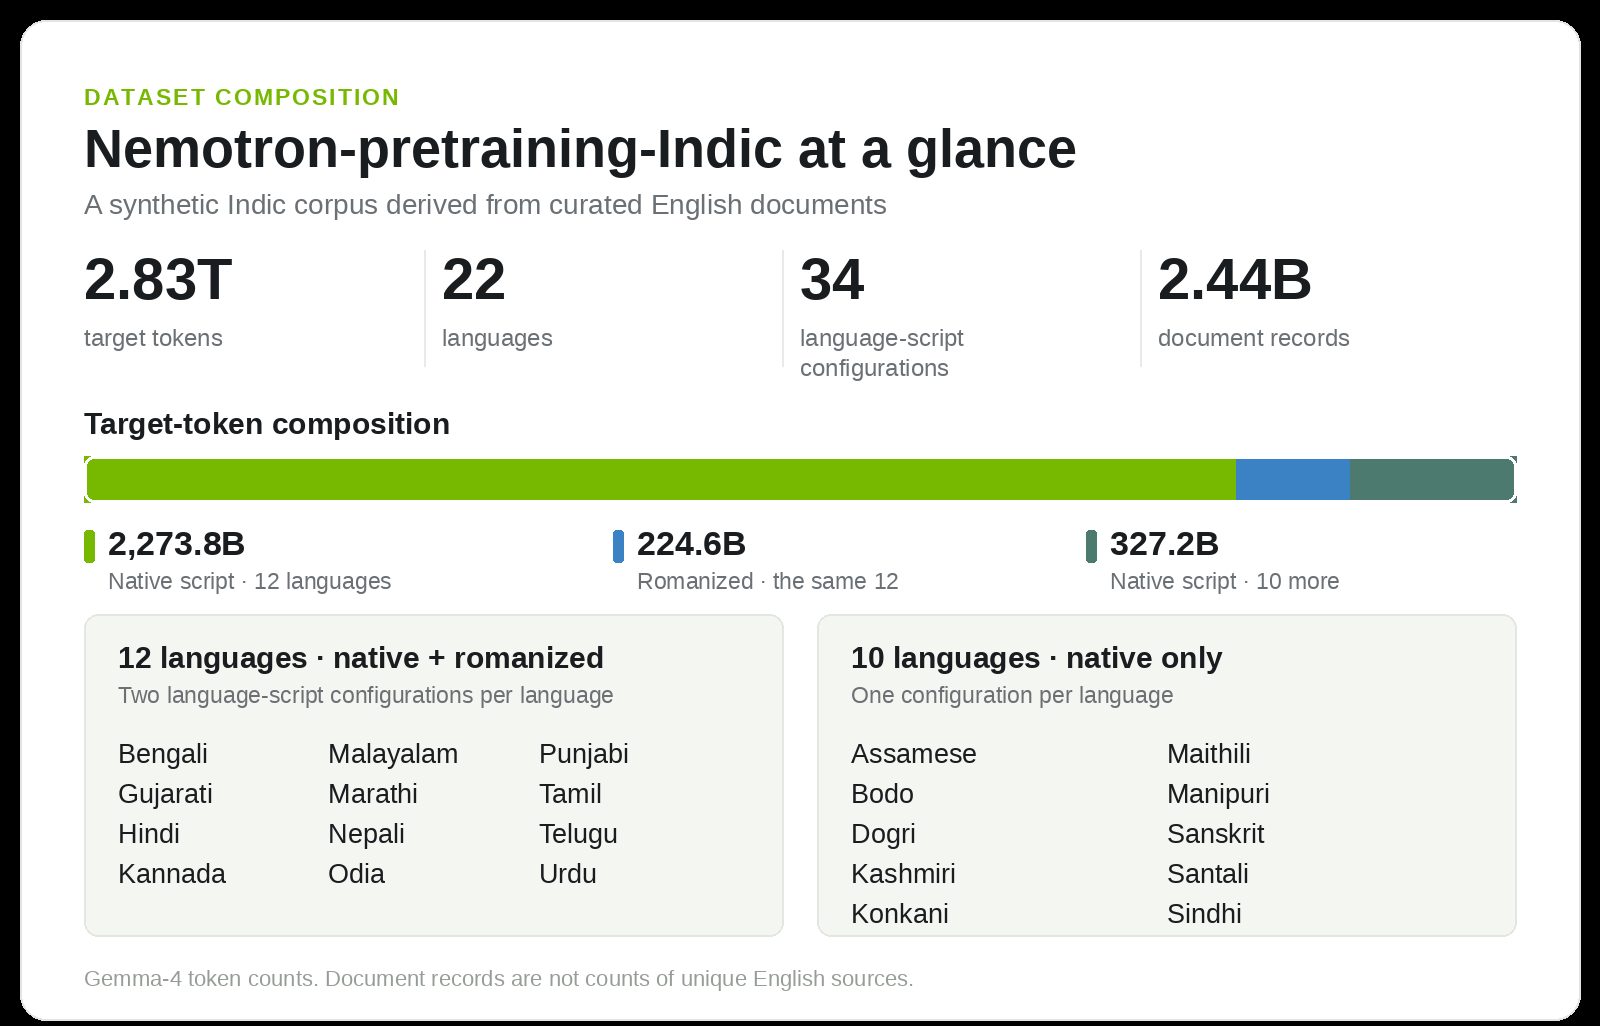
NVIDIA та IIT Madras випустили 2,8 трильйони токенів Indic корпусу для попереднього навчання
NVIDIA, IIT Madras та AI4Bharat оприлюднюють Nemotron-pretraining-Indic-v1, корпус із близько 2,8 трильйонів токенів для 22 індійських мов, а також відкритий GPU-прискорений пайплайн, який використовувався для його створення.
Корпус для 22 індійських мов
NVIDIA разом з IIT Madras та його лабораторією AI4Bharat представила Nemotron-pretraining-Indic-v1, корпус для попереднього навчання, який охоплює близько 2,8 трильйонів токенів для 22 мов, перерахованих у Конституції Індії. Випуск також включає відкритий GPU-прискорений пайплайн генерації даних, який використовувався для його створення і який включає переклад, оцінку якості та виправлення.
Корпус містить 2 601,0 мільярди токенів у рідних писемностях та 224,6 мільярди романізованих токенів, підрахованих токенайзером Gemma-4. Він охоплює 34 конфігурації мова-писемність: дані рідними письменностями для всіх 22 мов та романізований текст для дванадцяти з них. Кожен запис пов'язаний з документом курованого джерела, і кожен результат перевіряється з його вхідними даними, щоб синтетичний текст спирався на реальну інформацію.
Від англійських джерел до індійських навчальних даних
Пайплайн починається з документів 15 підгруп Nemotron-CC-v2, які включають веб-текст, матеріали для питань-відповідей, математику, код та інший спеціалізований контент. Фреймворк NeMo Data Designer з відкритим кодом від NVIDIA виконує переклад, перевірки якості та цільові виправлення, зберігаючи ідентифікатори джерел, щоб результати можна було простежити до їхніх оригінальних документів.
Для дванадцяти мов документи повністю перекладаються за допомогою Gemma-4-31B-it, яка була обрана після порівняння моделей на повних документах. Рубрика, натхненна Multidimensional Quality Metrics, охоплює значущість, коректність, термінологію, стиль та форматування, і зберігаються лише ті результати, які набирають мінімум 75 балів зі 100. Результати з низькими балами виправляються за допомогою зворотного зв'язку з оцінки та повторно оцінюються, що повернуло 438,4 мільярди токенів. Отримані переклади рідними письменностями також перетворюються на латинку для романізованої частини.
Решта десяти мов використовує окремий робочий процес, побудований на Indic Translate, моделі перекладу документів рівня Bodhan AI. Для довших документів Santali перекладаються та реконструюються перекриті вікна; для Manipuri текст перекладається бенгальською писемністю, а потім перетворюється на Meitei Mayek.
Вплив на моделі Nemotron
Продовжене попереднє навчання Nemotron 3.5 Super VL додало 10 мільярдів індійських токенів, отриманих з дванадцятипідгрупової версії корпусу та природних індійських текстів. Оцінки зросли на всіх п'яти згаданих індійських бенчмарках знань і міркувань, збільшившись на 4,98–9,82 процентних пункти. Випущена модель також набирає вищі бали, ніж Nemotron 3 Super, на п'яти з шести індійських бенчмарків завдань і перевершує IndiVibe за всіма чотирма вимірами, хоча на IFEval 1.5 дотримання інструкцій впало на 2,04 пункти.
Команда планує використовувати цей корпус у майбутніх моделях Nemotron і рекомендує поєднувати його з природно написаними індійськими текстами для локальних знань і культурного контексту.
Джерела: Hugging Face Blog
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.