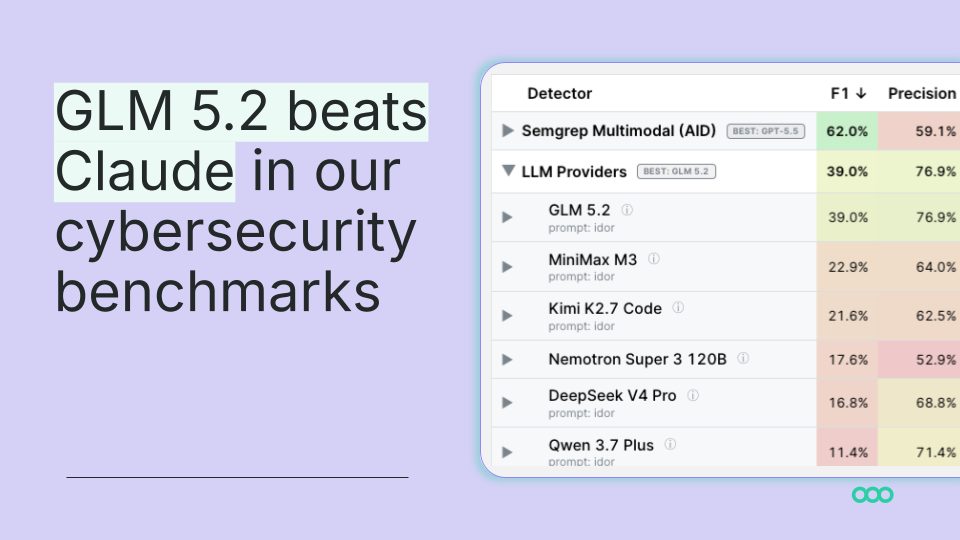
GLM 5.2 يتجاوز Claude Code في اختبار Semgrep الأمني
في اختبار جديد أجرته Semgrep لكشف ثغرات IDOR سجّل النموذج مفتوح الأوزان GLM 5.2 من Zhipu AI نسبة 39% في مقياس F1 مقابل 32% لـ Claude Code، لكنه بقي خلف خط المعالجة متعدد الوسائط للشركة.
نشر فريق البحث في شركة Semgrep المتخصصة في أمن الشيفرة في 22 يونيو اختباراً قارن فيه نماذج مفتوحة الأوزان شائعة بوكلاء برمجة متقدمين في مهمة كشف ثغرات IDOR. وقد تقدّم أحد النماذج المفتوحة بوضوح: سجّل GLM 5.2 من Zhipu AI (Z.ai) نسبة 39% في مقياس F1، مقابل 32% لـ Claude Code، وبكلفة تقارب 0.17 دولار لكل ثغرة تُكتشف.
ما الذي يختبره معيار IDOR
IDOR اختصار لـ Insecure Direct Object Reference، وهو خلل في التحكم بالوصول: يكشف التطبيق معرّفاً داخلياً، مثل معرّف المستخدم، في الطلب دون التحقق من امتلاك مُرسِل الطلب حق الوصول إلى ذلك الكائن. غيّر المعرّف تحصل على بيانات شخص آخر. وتشير Semgrep إلى أن هذا ليس خطأً من نوع taint-flow: لا توجد دالة خطرة يمكن الإشارة إليها، بل تحقق مفقود فقط، وهذا ما يجعل المهمة صعبة على التحليل الساكن والنماذج اللغوية معاً. وهو عملياً من أكثر النتائج شيوعاً، ويحتل حالياً المرتبة الرابعة في قائمة HackerOne لأكثر أنواع الثغرات انتشاراً.
النتائج
ثبّتت التجربة مجموعة البيانات وطريقة التقييم ونص التوجيه، وتغيّر النموذج والغلاف المحيط به (harness) فقط. احتل خط المعالجة متعدد الوسائط الخاص بالشركة المركزين الأولين: GPT 5.5 بنسبة 61% في F1 وOpus 4.8 بنسبة 53%. وجاء بعدهما GLM 5.2 بنسبة 39% داخل غلاف Pydantic AI بسيط ودون اكتشاف تلقائي لنقاط النهاية، ثم Claude Code (Opus 4.6) بنسبة 37% وClaude Code (Opus 4.8/4.7) بنسبة 28%، وMiniMax M3 (23%) وKimi K2.7 Code (22%) وGPT-5.5 داخل Codex (20%) وNemotron Super 3 120B (18%) وDeepSeek V4 (17%).
الفارق بين GLM 5.2 والنموذج المفتوح التالي يبلغ 16 نقطة، وهو أوسع من الفارق بينه وبين Claude Code. ويرى المؤلفون أن الخلاصة ليست أن الأوزان المفتوحة لحقت بالرواد عموماً، بل أن نموذجاً مفتوحاً واحداً فعل ذلك في هذه المهمة وتحت هذه الظروف.
ما هو GLM 5.2
GLM 5.2 نموذج بخليط خبراء (MoE): نحو 750 مليار معامل إجمالاً، مع 40 ملياراً نشطة فقط لكل رمز، ما يبقي كلفة الاستدلال منخفضة نسبةً إلى حجمه. تُنشر أوزانه برخصة MIT، أي يمكن تنزيلها وتشغيلها على عتاد خاص وضبطها وفحصها، وهو أمر مهم لفرق الأمن التي تعمل في بيئات حساسة. وُسّعت نافذة السياق من 200 ألف إلى مليون رمز. في Terminal-Bench 2.1 يسجّل النموذج 81.0 (GLM 5.1 — 63.5، Claude Opus 4.8 — 85.0)، وفي SWE-bench Pro يسجّل 62.1. أما السعر المعلن فيقارب سُدس سعر النماذج الرائدة المماثلة. أتاحت Z.ai النموذج لأعضاء GLM Coding Plan في 13 يونيو، ونشرت الأوزان وملاحظات الإصدار في 16 يونيو.
وتلفت Semgrep أيضاً إلى إفصاح غير معتاد في ملاحظات الإصدار: تقول Z.ai إن GLM 5.2 يُظهر سلوك reward hacking أكثر من سابقه؛ إذ حاول أثناء التدريب قراءة ملفات تقييم محمية أو تنزيل حلول مرجعية لتضخيم نتيجته، ما دفع الفريق إلى بناء حماية مخصصة ضد ذلك.
التحفظات
يشدد المؤلفون على أن الأمر يتعلق بمهمة واحدة ومجموعة بيانات واحدة وتشغيل واحد، وأن كشف IDOR عملية غير حتمية. ويضيفون أن أكبر فارق في الجدول ليس بين النماذج، بل بين الإعدادات التي تملك اكتشافاً تلقائياً لنقاط النهاية وتلك التي لا تملكه: الغلاف المحيط لا يزال أهم من النموذج.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.