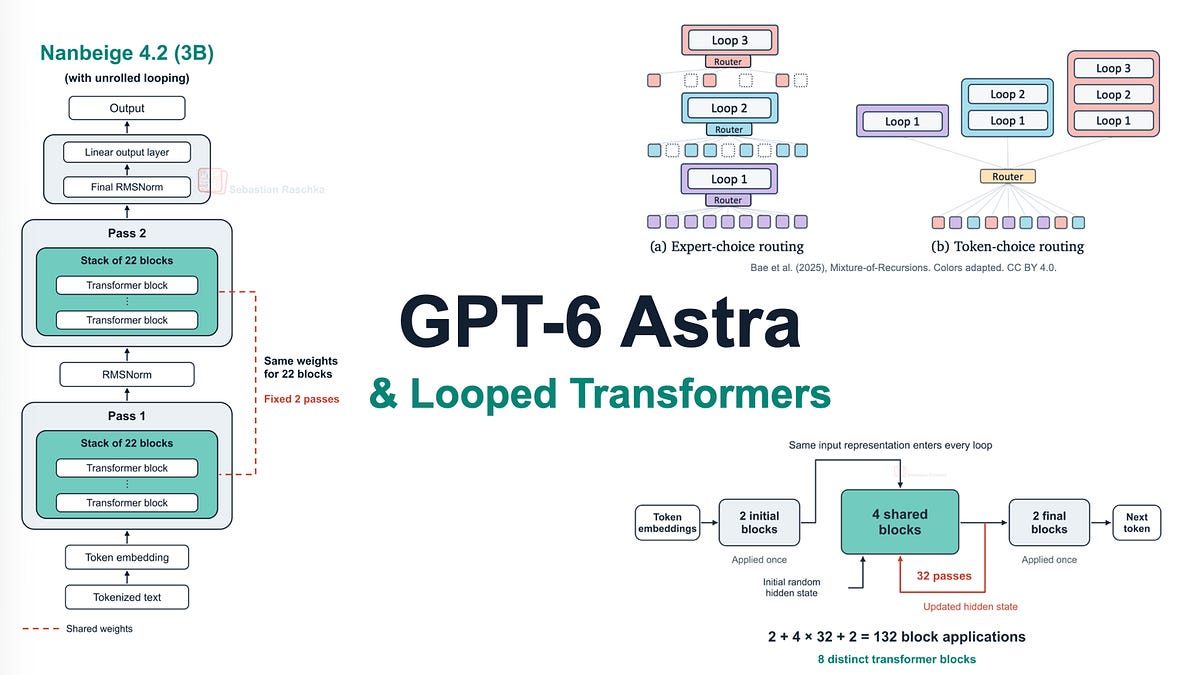
GPT-6 Astra والمحوّلات المتكررة والجدل حول الاستدلال المخفي
يتصدّر GPT-6 Astra الجديد من OpenAI الاختبارات وعروض استخدام الحاسوب، بينما أثارت تقارير عن «محوّلات متكررة» جدلاً حول إخفاء النموذج لسلسلة استدلاله. ويقول الباحث سباستيان راشكا إنه أقوى نموذج استخدمه حتى الآن.
أطلقت OpenAI في مطلع سبتمبر نموذج GPT-6 Astra، ووصفه باحث تعلّم الآلة سيباستيان راشكا، الذي جرّبه في غضون أيام، بأنه أقوى نموذج استخدمه حتى الآن.
وبحسب مراجعته، يتقدّم Astra على سلفه GPT-5.6 في كل المجالات تقريباً: الكتابة والرياضيات والبرمجة، إلا أن الفارق الأكبر يظهر في العروض الرسومية وعمليات التصيير ثلاثي الأبعاد. وفي اختبار ARC-AGI-3، الذي يمزج الألغاز المنطقية بالتعميم، يبلغ النموذج 99.9 في المئة مقابل 7.8 في المئة لـ GPT-5.6 Sol.
ريادة على الحدود مع تحفظات
على مؤشرات Artificial Analysis المستقلة تبدو الصورة أكثر تحفظاً: يقع Astra في طليعة Coding Agent Index v1.4 و Intelligence Index v4.2 من دون أن يتقدّم بفارق هائل. ولأن هذه التقييمات تخلط بين بيئات تشغيل مختلفة — Stirrup لـ GDPval-AA و AA-Briefcase، و Terminus 2 لـ Terminal-Bench v2.1 — فقد يُقلَّل تقدير نموذج مُهيَّأ حول بيئة رئيسية واحدة.
استخدام الحاسوب كجبهة جديدة
أبرز تقدّم يظهر في استخدام الحاسوب: يدير النموذج برامج على الجهاز المحلي عبر تطبيقي ChatGPT وCodex. ومن العروض المنتشرة تصيير مدينة نيويورك في Blender والرسم بالفأرة داخل نسخة المتصفح من MS Paint. وتُفيد التقارير بأن OpenAI اشترت عشرات الآلاف من أجهزة Mac Mini وMac Studio لتعريض النموذج لبيئة macOS أثناء التعلم المعزّز: تدخل لقطات الشاشة، وتخرج حركات الفأرة ولوحة المفاتيح، وتنفّذها بيئة التشغيل ثم تعيد لقطات جديدة. أما التدريب نفسه فيجري في مكان آخر — قال مدير Nvidia إن Astra دُرّب على نحو 100 ألف معالج Grace Blackwell. ويبقى Astra نموذج استدلال يتعلم بمكافآت قابلة للتحقق.
المحوّلات المتكررة والاستدلال المخفي
قبل الإطلاق بيومين كتب موقع The Information إن Astra يستخدم «العمق التكراري»، أي المحوّل المتكرر. في هذه التصاميم تُطبَّق الكتل نفسها عدة مرات بأوزان مشتركة: يشغّل Nanbeige4.2-3B اثنتين وعشرين كتلة مرتين، ويكرر Ouro من ByteDance ثمانياً وأربعين كتلة أربع مرات، ويوجّه Mixture-of-Recursions كل رمز إلى مرور واحد إلى ثلاثة. ترفع هذه الحيلة العمق الفعّال مع تخزين أوزان أقل، لكن كلفة الحساب وذاكرة KV تبقى قريبة من نموذج تقليدي بالعمق نفسه؛ ويقدّر SMELT توفيراً بين 6.8 و18 في المئة من حسابات التدريب للوصول إلى الخسارة ذاتها.
يشكّ راشكا في أن التكرار يخفي الاستدلال. فـ OpenAI تخفي معظم آثار الاستدلال منذ o1، ويستهلك Astra رموزاً أقل من GPT-5.6 Sol عند الدقة نفسها — وهو نمط ظهر أيضاً بين نماذج أصغر (تستهلك Luna رموزاً أكثر بنسبة 80 في المئة من Sol لنتائج مشابهة) من دون قلق حول قابلية التفسير. وتشير بطاقة نظام Astra إلى تراجع قابلية المراقبة مقارنة بـ Sol، ويعود ذلك أساساً إلى آثار أقصر. وقال كبير علماء OpenAI ياكوب باتشوتسكي إن الرسم الحسابي للنماذج الحدودية يقع في نطاق ضعف GPT-4، محذّراً من «سباق نحو انعدام المراقبة انطلق بسبب تقارير مربكة».
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.