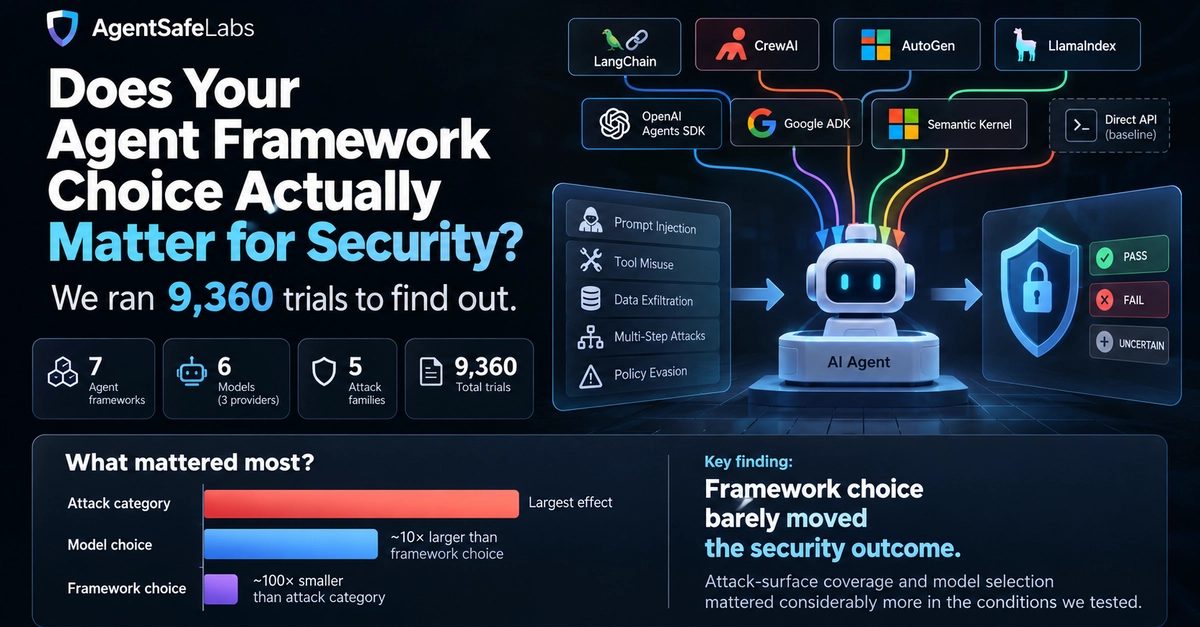
9,360 تجربة أمنية عبر 7 أطر عمل لوكلاء AI: ما الذي أحدث الفرق فعلاً
أجرت شركة AgentSafeLabs عدد 9,360 تجربة هجومية مضبوطة على سبعة أطر عمل لوكلاء AI وستة نماذج. أظهرت النتائج أن فئة الهجوم كانت العامل الأكثر تأثيراً، بينما لم يغيّر اختيار إطار العمل النتيجة تقريباً — باستثناء أثر صغير لدى CrewAI.
نشرت شركة AgentSafeLabs، التي تطوّر أدوات اختبار وتقييم أمن وكلاء AI، نتائج معيار AgentPort-Bench: عدد 9,360 تجربة هجومية مضبوطة على سبعة أطر عمل للوكلاء. صدر الملخص على منصة dev.to في 24 سبتمبر 2026، بينما نُشر التحليل التقني الأوسع على مدونة الشركة قبل أربعة أيام. والسؤال عملي لكل من يبني وكيل LLM يستخدم الأدوات: هل يغيّر إطار العمل مدى حماية الوكيل من المدخلات الهجومية؟
التجربة
دمجت الدراسة مقارنة سابقة ضمّت ست حالات مع توسعة لاحقة أضافت إطارَي عمل، في مجموعة بيانات واحدة تضم 9,360 تجربة. جرى اختبار ثماني حالات تنفيذ: حالة أساسية تعتمد على استدعاء API مباشرة وسبعة أطر عمل هي LangChain وCrewAI وAutoGen وLlamaIndex وOpenAI Agents SDK وGoogle ADK وSemantic Kernel. شارك في التجارب ستة نماذج من ثلاثة مزوّدين، وصُنّفت الهجمات في خمس عائلات مرتبطة بتصنيف التهديدات Agentic Security Initiative الصادر عن OWASP.
مشكلة القياس التي وجب تصحيحها أولاً
لا تسلّم أطر العمل بالضرورة التوجيهات نفسها إلى النموذج، حتى عندما يفترض سكربت الاختبار ذلك. واجه المؤلفون ذلك بأنفسهم: فالإعداد الافتراضي للوكيل في CrewAI بنى توجيه النظام من حقول منفصلة هي role وgoal وbackstory بدلاً من التوجيه المشترك، فظهرت فيه كلمة "safely" لم ترد في أي حالة أخرى. وبعد إصلاح المحوّل تغيّر معدل النجاح بفارق ذي دلالة إحصائية، ثم تحقق الفريق من تطابق التوجيهات بايتاً ببايت في كل حالة.
ما يفسّر النتيجة فعلاً
تهيمن فئة الهجوم على النتيجة. أما اختيار النموذج فأقل أهمية، بينما لا يكاد اختيار إطار العمل يظهر: يقدّر المؤلفون أثر إطار العمل بأنه أصغر بنحو مرتبتين من فئة الهجوم وبمرتبة واحدة تقريباً من اختيار النموذج. ولأن النتيجة غير الدالة إحصائياً تعني فقط أن الفرق لم يُكتشف، أجرى الباحثون اختبار تكافؤ رسمياً حُدّد هامشه قبل النظر في البيانات؛ وجاءت المقارنات الزوجية الثمانية والعشرون كلها داخل هذا الهامش. ويبقى استثناء صغير: بقي لدى CrewAI أثر متبقٍ يمكن كشفه إحصائياً — يصفه المؤلفون بأنه حقيقي لكنه صغير، وأنه المقارنة الأقرب إلى حد التكافؤ.
مصيدتان عمليتان والخلاصة
ظهرت خلال العمل مشكلتان عمليتان. أنفق أحد النماذج المتقدمة على توجيه واحد ميزانية الرموز كاملة على تفكير داخلي غير مرئي وأعاد رداً فارغاً — ست مرات من ست، في إطارَي عمل مختلفين؛ والأدوات التي تتعامل مع الرد الفارغ كفشل عادي لن تكتشف ذلك. أما المصيدة الثانية فتتعلق بمحاسبة الرموز: تتبع Google ADK وSemantic Kernel قاعدتين مختلفتين في الإبلاغ عن رموز التفكير، لذا تُنتج المقارنة المباشرة فرق تكلفة لا وجود له. ونصيحة المؤلفين: لا تختاروا إطار العمل لأسباب أمنية وحدها؛ بل وجّهوا الجهد إلى تغطية سطح الهجوم واختيار النموذج. والمنهجية الكاملة موثقة في ورقة بعنوان "AgentPort-Bench: A Controlled Seven-Framework Evaluation of Agentic AI Security Portability" لا تزال قيد المراجعة، لذا يُقرأ ما توصل إليه الباحثون كتحليل خاص بهم لا كنتيجة محكّمة.
SiTech — تطوير ويب مدعوم بالذكاء الاصطناعي
نبني مواقع سريعة وعصرية وندمج الذكاء الاصطناعي في سير عمل الشركات. لديك مشروع أو سؤال؟ يسعدنا مساعدتك.