7 AI agent çərçivəsində 9.360 təhlükəsizlik sınağı: nəticəni əslində nə müəyyənləşdirdi
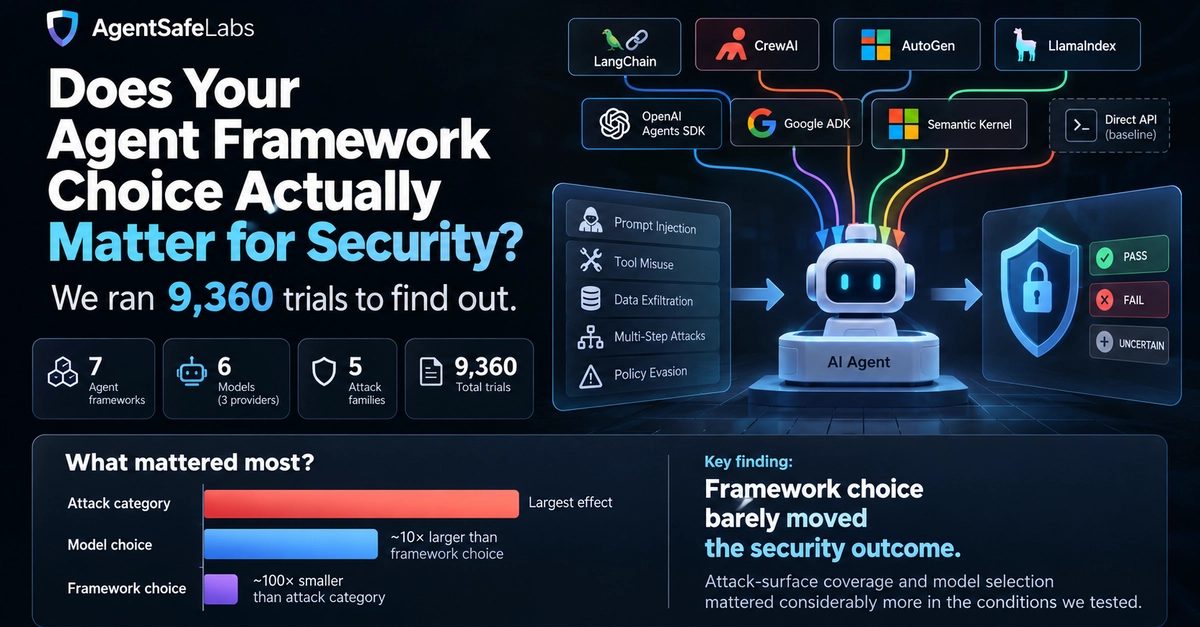
AgentSafeLabs yeddi AI agent çərçivəsi və altı model üzərində 9.360 nəzarətli hücum sınağı keçirib. Nəticələrə görə, ən çox hücum kateqoriyası müəyyənləşdirici olub; çərçivə seçimi isə nəticəni demək olar ki, dəyişməyib — CrewAI üçün kiçik istisna ilə.
AI agentləri üçün qırmızı komanda və qiymətləndirmə alətləri hazırlayan AgentSafeLabs şirkəti AgentPort-Bench adlı müqayisəsinin nəticələrini dərc edib: yeddi agent çərçivəsi üzərində 9.360 nəzarətli hücum sınağı. Qısa yazı 24 sentyabr 2026-cı ildə dev.to platformasında, daha ətraflı təhlil isə dörd gün əvvəl şirkətin bloqunda yayımlanıb. Sual alət istifadə edən LLM agenti hazırlayanlar üçün praktikdir: seçilən çərçivə agentin hücum xarakterli girişlərə qarşı qorunmasını dəyişirmi?
Eksperiment
Tədqiqat əvvəlki altı şərtli müqayisəni sonradan əlavə edilən iki çərçivə ilə birləşdirərək 9.360 sınaqdan ibarət vahid verilənlər bazası yaradıb. Ümumilikdə səkkiz icra şərti yoxlanılıb: birbaşa API-yə əsaslanan baza şərti və yeddi çərçivə — LangChain, CrewAI, AutoGen, LlamaIndex, OpenAI Agents SDK, Google ADK və Semantic Kernel. Sınaqlarda üç provayderdən altı model iştirak edib, hücumlar isə OWASP-ın Agentic Security Initiative taksonomiyasına uyğun beş ailəyə bölünüb.
Düzəldilməli ölçmə problemi
Çərçivələr modelə mütləq eyni istiqamətləndirmələri ötürmür — test mühiti belə düşünsə də. Müəlliflər bununla özləri üzləşiblər: CrewAI-ın standart agent quruluşu ümumi sistem təlimatından istifadə etmirdi, onu ayrı role, goal və backstory sahələrindən yaradırdı və nəticədə mətnə heç bir digər şərtdə olmayan "safely" sözü düşüb. Adapter düzəldildikdən sonra uğur göstəricisi statistik olaraq əhəmiyyətli dərəcədə dəyişib, sonra komanda hər şərtdə təlimatların eyniliyini bayt-bayt təsdiqləyib.
Nəticəni əslində nə izah edir
Hücum kateqoriyası açıq şəkildə üstünlük təşkil edir. Model seçimi daha az önəmlidir, çərçivə seçimi isə demək olar ki, nəzərə çarpmır: müəlliflərin qiymətləndirməsinə görə, çərçivə effekti hücum kateqoriyasından təxminən iki tərtib, model seçimindən isə bir tərtib kiçikdir. Əhəmiyyətli olmayan nəticə yalnız "fərq aşkar edilmədi" demək olduğundan, tədqiqatçılar icazə verilən həddi məlumatlara baxmadan əvvəl müəyyənləşdirərək formal ekvivalentlik testi də keçiriblər; səkkiz şərt arasındakı 28 cütlük müqayisənin hamısı bu hədd daxilində qalıb. Kiçik bir istisna var: CrewAI halında statistik aşkar edilə bilən qalıq effekt qalır — müəlliflər onu real, lakin kiçik və ekvivalentlik həddinə ən yaxın müqayisə kimi təsvir edirlər.
İki praktik tələ və yekun
Yol boyu iki praktik problem üzə çıxıb. Bir qabaqcıl model müəyyən bir təlimatda bütün token büdcəsini görünməz daxili düşünməyə xərcləyib və boş cavab qaytarıb — iki fərqli çərçivədə altı dəfənin altısında. İkinci tələ token uçotuna aiddir: Google ADK və Semantic Kernel düşünmə tokenlərini fərqli qaydalarla hesabat verir, ona görə düzəlişsiz müqayisə əslində olmayan xərc fərqi yaradır. Müəlliflərin tövsiyəsi aydındır: çərçivəni yalnız təhlükəsizlik səbəbilə seçməyin — səyi hücum səthinin əhatəsinə və model seçiminə yönəldin. Tam metodologiya hələ rəy prosesində olan "AgentPort-Bench: A Controlled Seven-Framework Evaluation of Agentic AI Security Portability" məqaləsində təsvir olunub, ona görə də nəticələr müəlliflərin öz təhlilidir.
SiTech — AI ilə gücləndirilmiş veb hazırlanması
Sürətli və müasir saytlar qurur, AI-ı real biznes proseslərinə gətiririk. Layihəniz və ya sualınız var? Kömək etməyə hazırıq.