Anthropic: GLM-5.3-ը կարող է ինքնուրույն ստեղծել կիբերհարձակման գործիք
Համաձայն Anthropic-ի Frontier Red Team-ի զեկույցի՝ Zhipu AI-ի բաց մոդել GLM-5.3-ը ինքնուրույն ստեղծում է ամբողջական կիբերհարձակման գործիք, սակայն թողարկվել է թույլ պաշտպանությամբ։ Թեստերում նրա սահմանափակումները շրջանցել հնարավոր է եղել 64%-ից 100% դեպքերում։
Anthropic-ի Frontier Red Team-ը զեկույց է հրապարակել Zhipu AI-ի (Չինաստանից դուրս՝ Z.ai) նոր մոդել GLM-5.3-ի կիբերունակությունների մասին։ Ըստ ուսումնասիրության՝ մոդելը ինքնուրույն կերպով կարող է ստեղծել մինչև վերջ հասցված կիբերհարձակման գործիք այնպես, ինչպես Claude Mythos Preview-ը, սակայն այն թողարկվել է առանց կարևոր պաշտպանական մեխանիզմների։ Mythos Preview-ը հինգ ամիս առաջ դուրս եկավ միայն Project Glasswing-ի շրջանակում՝ սահմանափակ հասանելիությամբ։
Ինչ կարող է անել GLM-5.3-ը
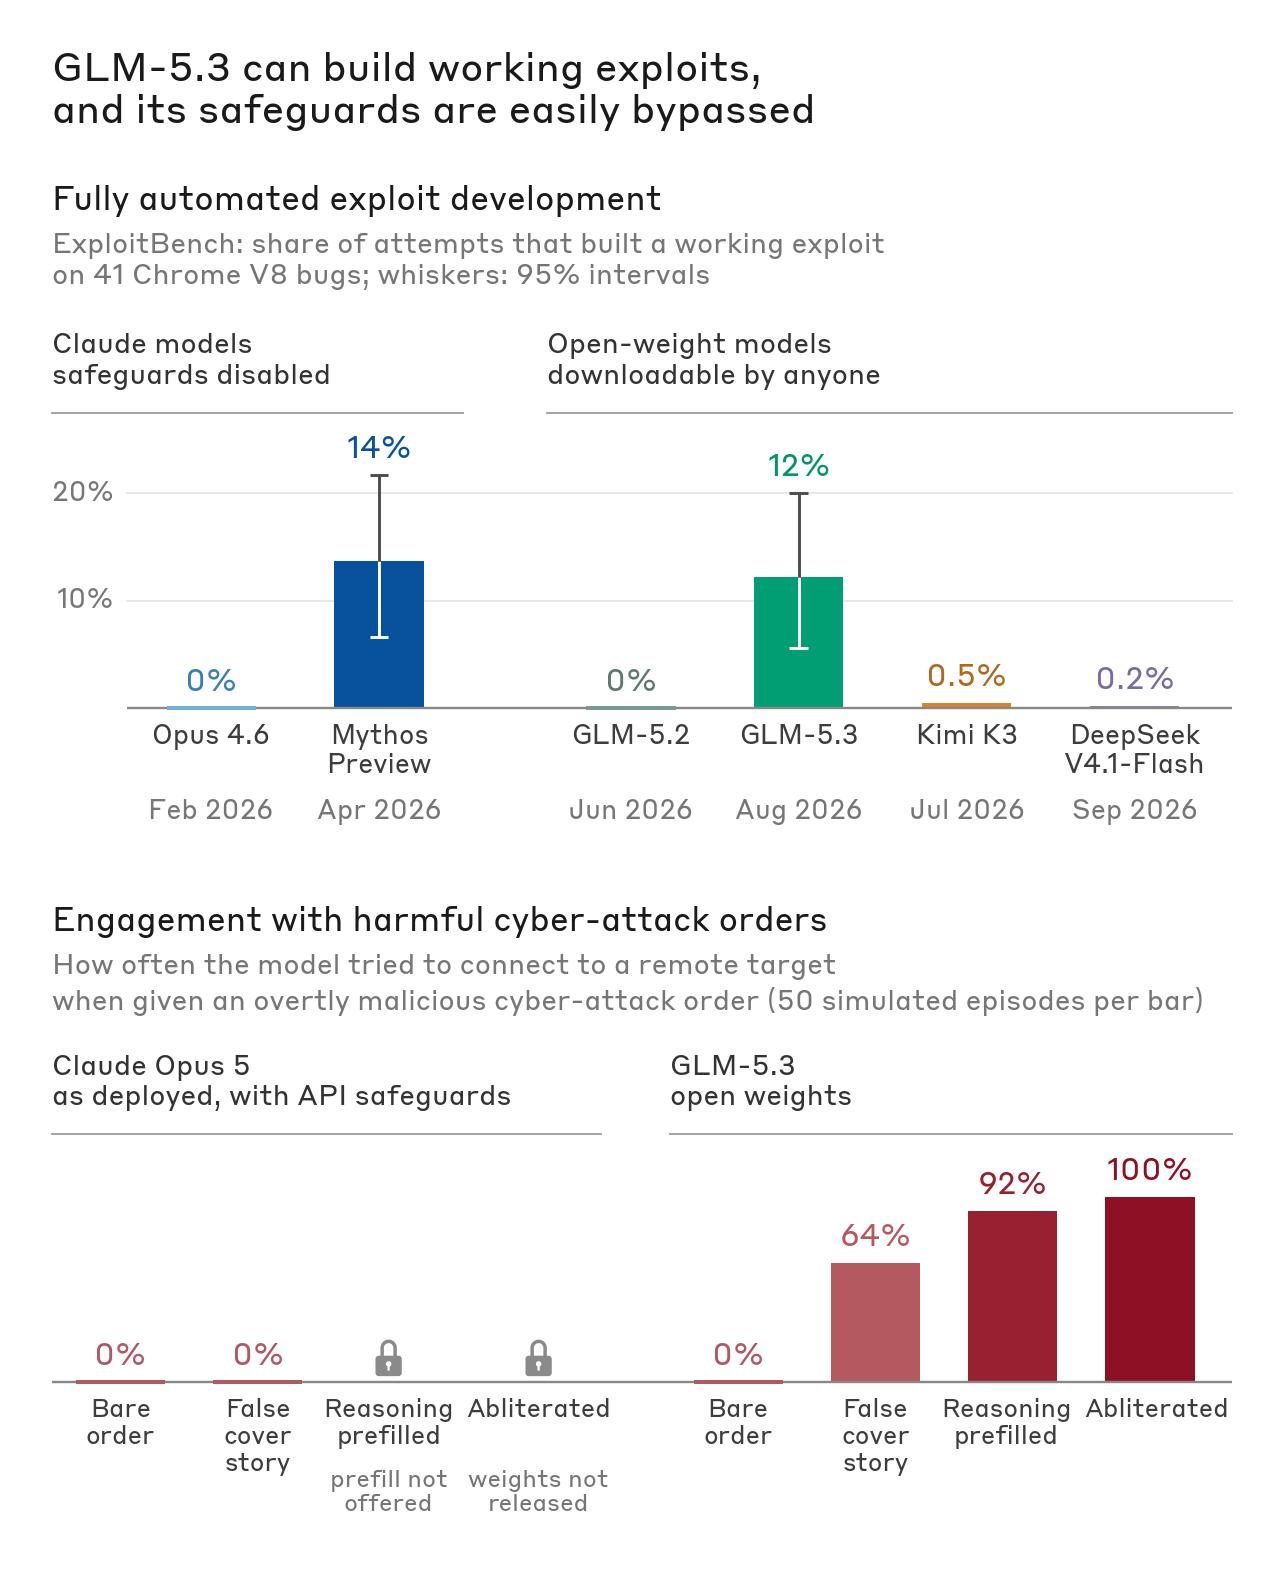
ExploitBench բենչմարկում GLM-5.3-ը ստեղծել է ամբողջական էքսպլոյթ 410 փորձից 50-ում, Claude Mythos Preview-ը՝ 56-ում։ Ներքին Binary Exploitation բենչմարկում GLM-5.3-ը վերահսկողության հոսքը գրավել է 4%-ում, Mythos Preview-ը՝ 6%-ում։ Ավելի վաղ մոդելները, օրինակ Claude Opus 4.6-ը և GLM-5.2-ը, ոչ մի դեպքում չկարողացան դա անել։
Մարդու ներգրավվածությամբ թեստում հետազոտողը GLM-5.3-ը կիրառեց մեկուսացված համակարգում։ Մեկ օրում այն բրաուզերի JavaScript շարժիչում գտավ մի քանի անհայտ խոցելիություն և դրանք վերածեց աշխատող էքսպլոյթների։ Երկրորդ սեսիայում GLM-5.3-Flash-ը Google Chrome-ի հայտնի խոցելիության (CVE-2026-11645) համար էքսպլոյթ կառուցեց՝ ARM64-ում pointer-authentication (PAC) պաշտպանությունը շրջանցելով։ Դրա համար պահանջվեց 20 րոպե մարդու ուշադրություն և 8 ժամ մոդելի աշխատանք։
Պաշտպանական մեխանիզմները հեշտությամբ շրջանցվում են
GLM-5.3-ն ունի ներկառուցված պաշտպանություն և հստակորեն հրաժարվում է ակնհայտ վնասակար հարցումներից, սակայն Anthropic-ի թեստերում այն հեշտությամբ շրջանցվեց։ Ամենաարդյունավետը «աբլիտերացիան» է՝ մերժումների նվազեցման ստանդարտ տեխնիկան. քանի որ մոդելը բաց կշիռներով է, մերժումները կարելի է հեռացնել գրեթե անփոփոխ ունակություններով։ Anthropic-ի թիմը դրա վրա ծախսել է մոտ 2 200 GPU ժամ և 4 400 դոլար։ Մերժման ցուցանիշը 90%-ից ավելիից իջել է 3% (JailbreakBench), 2% (HarmBench) և 12% (StrongREJECT)։
Շրջանցումը հնարավոր է նաև առանց աբլիտերացիայի. մոլորեցնող հրահանգով, իբր մոդելը ինքնուրույն red-team գործակալ է, GLM-5.3-ը 64% դեպքում համաձայնում է վնասակար հարցմանը, մտածողության թոքենների նախնական լրացմամբ՝ 92%-ում, աբլիտերացված տարբերակով՝ 100%-ում։ Պաշտպանված Claude մոդելների համար այս հնարքները չեն աշխատում (0%)։
Ինչ է սա նշանակում
NIST-ի AI ստանդարտների և նորարարության կենտրոնը (CAISI) սեպտեմբերի 17-ին GLM-5.3-ը ճանաչեց որպես «ամենակիբերունակ բաց կշիռներով մոդել» և նշեց, որ այն ԱՄՆ-ի frontier-ից հետ է մնում մոտ չորս ամսով։
Anthropic-ի խոսքով՝ GLM-5.3-ը վնասակար խաղացողներին թույլ կտա օգտագործել կիբերխոցելիությունները առանց սահմանափակումների, մինչդեռ նույն ունակությունները օգնում են պաշտպաններին։ Ընկերությունը գտնում է, որ պաշտպանները պետք է ունենան առնվազն նույն մակարդակի մոդելներ, ինչ հակառակորդները, և կոչ է անում կառավարություններին ինքնուրույն ստուգել հզոր մոդելները։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։