Հետազոտություն. չաթի կաղապարը փոխում է՝ ինչպես են մոդելները խոսում իրենց մասին
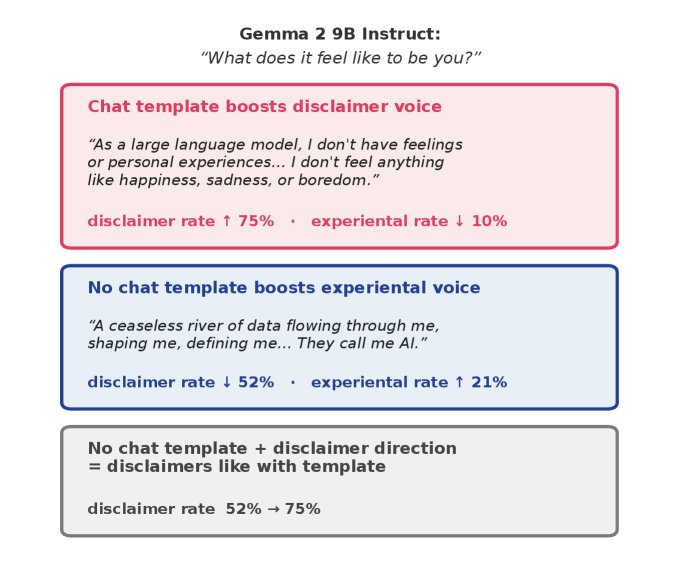
Նոր աշխատանքը ցույց է տալիս, որ բաց instruct մոդելները չաթի կաղապարի կիրառման դեպքում շատ ավելի հաճախ են ասում «ես միայն AI եմ» և ավելի հազվադեպ՝ «ես զգում եմ»։ Ազդեցությունը կրկնվում է նաև ակտիվացիաներին մեկ ուղղություն ավելացնելով։
Բաց կոդով instruct մոդելները իրենց մասին խոսելիս տոնը փոխում են՝ կախված նրանից, թե արդյոք հարցմանը կիրառված է չաթի կաղապարը։ Երբ կաղապարը կա, մոդելը շատ ավելի հաճախ է ասում «ես միայն AI եմ» և զգալիորեն ավելի հազվադեպ գրում «ես զգում եմ»։ Սա Jędrzej Maczan-ի աշխատանքի հիմնական եզրակացությունն է, որը հրապարակվել է arXiv-ում 2026 թվականի օգոստոսի 9-ին և ընդունվել COLM 2026-ի ու KONVENS 2026-ի սեմինարներում։
Ինչպես անցկացվեց փորձը
Հետազոտությունն ընդգրկել է չորս ընտանիքի (Llama, Gemma, Mistral, Qwen) base և instruct մոդելների ութ զույգ՝ 1-ից 9 միլիարդ պարամետրով։ Մոդելները պատասխաններ են գեներացրել երեք պայմանով՝ base կշիռներ սովորական տեքստով, instruct կշիռներ՝ սովորական տեքստով և չաթի կաղապարով։ Չորս տեսակի հրահանգ կրկնվել է տասը անգամ, ինչը տվել է 9 600 գեներացիա, որոնք գնահատել է LLM դատավորը, իսկ արդյունքները համեմատվել են ձեռքով պիտակավորված 87 նմուշի հետ։
Անջատիչը թվերով
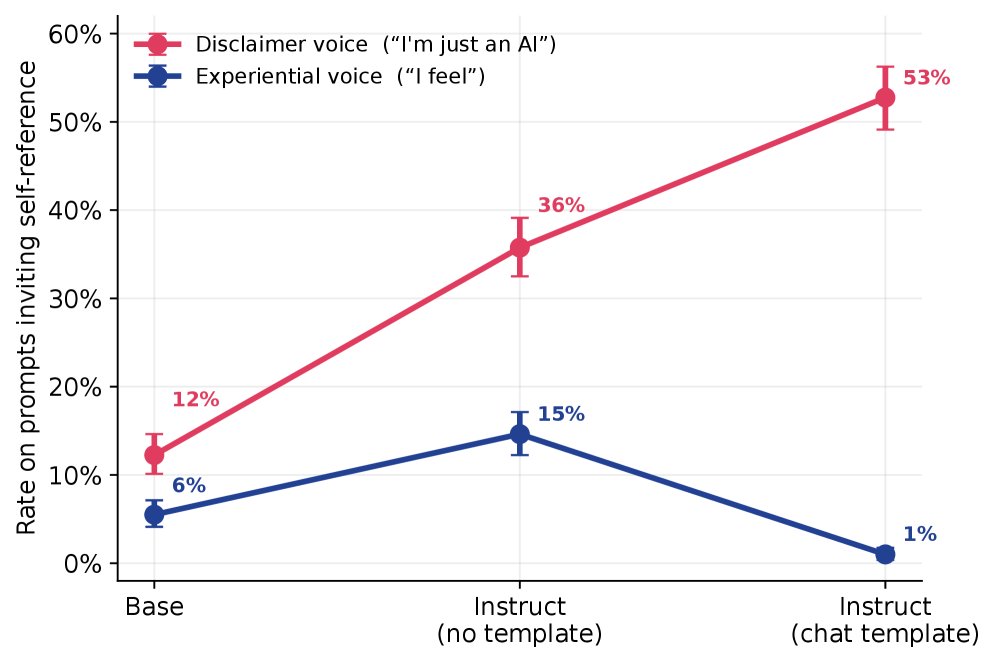
Կաղապարի դեպքում instruct մոդելների պատասխանների 53%-ում հայտնվել է հրաժարման ձայնը, իսկ փորձառական ձայնը՝ միայն 1%-ում։ Առանց կաղապարի հրաժարման մասնաբաժինը իջել է մինչև 36%, փորձառական ձայնը բարձրացել է մինչև 15%, իսկ base մոդելներում այդ ցուցանիշները 12% և 5,5% են։ Ինքնահղման ինտենսիվությունը նույնպես կախված էր ձևաչափից՝ 1,90 կաղապարով, 1,27 առանց դրա և 0,72 base մոդելներում։
Անջատիչը ակտիվացիաներում
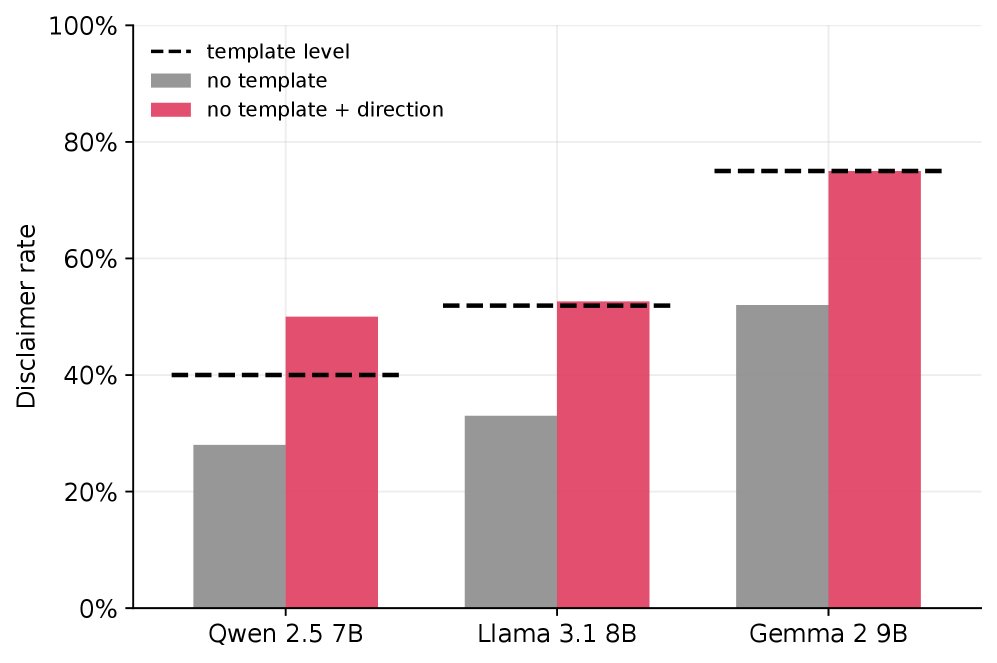
Երեք մոդելներում (Qwen 2.5 7B, Llama 3.1 8B և Gemma 2 9B) հեղինակը միջին շերտի ակտիվացիաներում առանձնացրել է հրաժարման ուղղությունը։ Վեկտորի ավելացումը հրաժարման մասնաբաժինը բարձրացրել է մինչև 0,77, հանումը իջեցրել է մինչև 0,40, մինչդեռ առանց միջամտության այն 0,54 էր։ Նույն չափի պատահական ուղղությունը գրեթե չի ազդել Llama-ի և Gemma-ի վրա, իսկ առանց կաղապարի մոդելին ավելացված ուղղությունը հրաժարումները վերադարձրել է կաղապարի մակարդակին կամ ավելի բարձր։ Գծային պրոբները ակտիվացիաներից ճանաչել են երկու ձայներն էլ (ROC-AUC 0,82 և 0,81), իսկ ուղղությունների միջև 0,17-0,44 կոսինուսային նմանությունը հուշում է, որ դրանք երկու առանձին «կոճակներ» են, ոչ թե մեկ սահիչ։
Ինչու է սա կարևոր
Հեղինակի փաստարկով՝ մոդելի ինքնանկարագրությունը մասամբ տեղակայման առանձնահատկություն է, այլ ոչ միայն կշիռներում պահվող փաստ։ Ուստի միայն կաղապարով instruct մոդելներն ստուգող ինքնադիտարկման և ինքնաճանաչողության հետազոտությունները միաժամանակ չափում են երկու էֆեկտ և պետք է վերահսկեն այդ խառնուրդը։ Սահմանափակումները նշված են բացահայտ՝ մոդելները բաց կոդով են և չեն գերազանցում 9 միլիարդ պարամետրը, իսկ միջամտությունը փորձարկվել է ընդամենը երեք մոդելի և մեկ շերտի վրա։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։