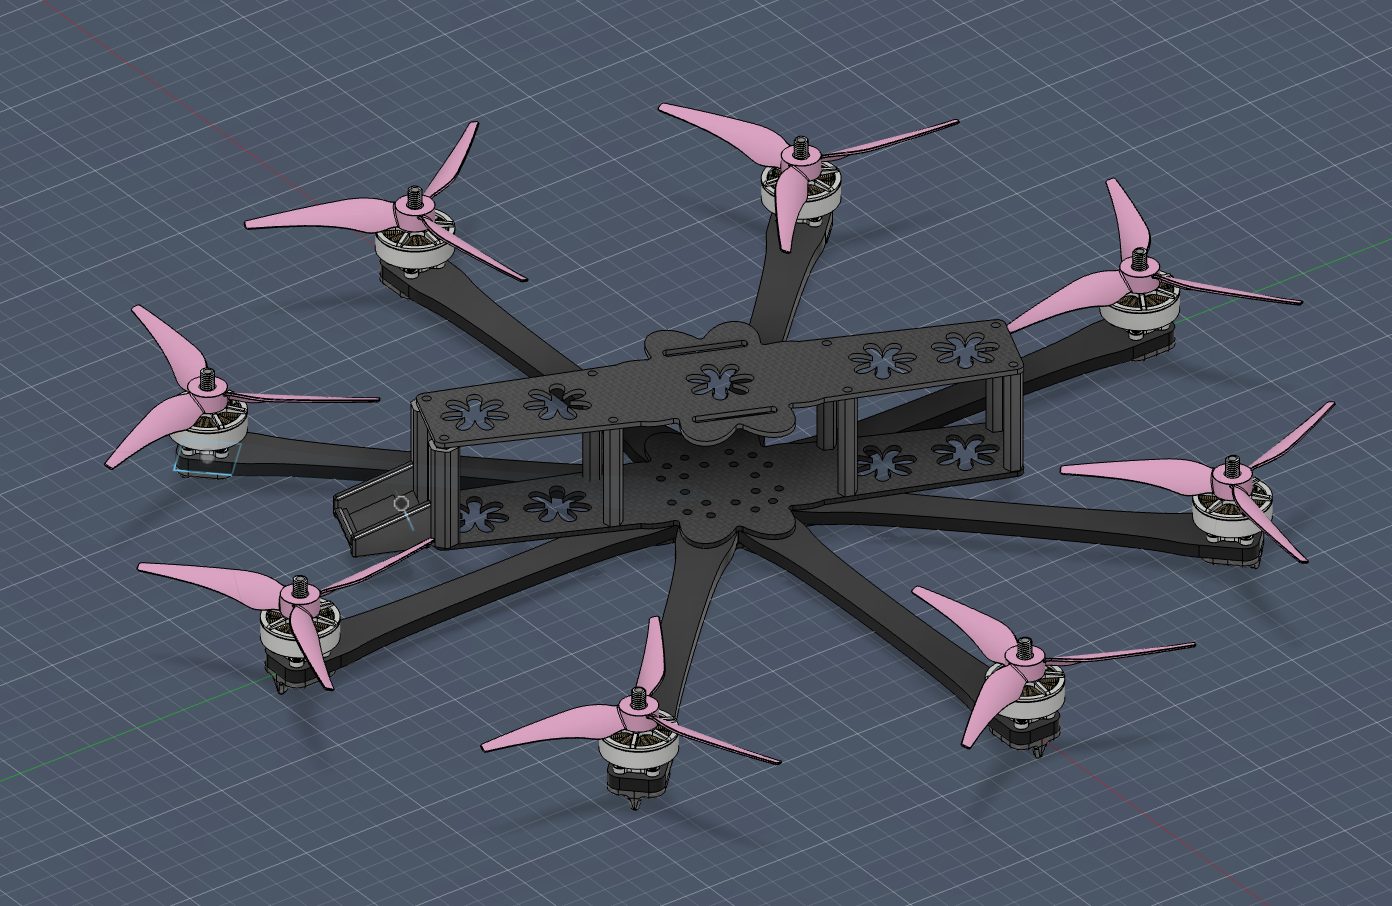
Ինժեներուհին զրոյից հավաքել է ութռոտոր ու վարժեցրել RL քաղաքականություն
Կարոլինա Դուբիելը սարքաշարի փորձ չունենալով հավաքել է սեփական ութռոտորը. գաղափարից առաջին թռիչք՝ 2.5 շաբաթ, RL-ով թռիչք՝ ութից պակաս։ Քաղաքականությունը դիմացավ նաև երեք ու չորս խափանման։
Ծրագրային ինժեներուհի Կարոլինա Դուբիելը, ով նախկինում լուրջ սարքաշարային նախագիծ չէր արել, ինքնուրույն նախագծեց, մշակեց, զոդեց և թռցրեց ութռոտորը, ապա վարժեցրեց ուժեղացված ուսուցման քաղաքականություն, որը սարքը օդում է պահում շարժիչների խափանումից հետո էլ։ Գաղափարից թռչող դրոն տևեց երկուսուկես շաբաթ, RL-ով թռիչքինը՝ ութից պակաս։
Fusion 360-ից մինչև ձեռքով հավաքված իրան
Իրանը նախագծվել է Fusion 360-ում և մշակվել CNC-ով՝ թևերը՝ G10 ապակեպլաստիկից, իրանային թիթեղները՝ 5 մմ ածխածնային մանրաթելից։ Հետո եղան չորս փուլեր՝ հավաքում, էլեկտրոնիկայի միացում և սովորական թռիչք, քաղաքականության վարժեցում երկու շարժիչի խափանման համար և sim-to-real անցումը։
43 000 պարամետրանոց ցանց՝ 50 Hz-ով
Վերջնական կարգավորիչը փոքր է՝ երկշերտ MLP՝ յուրաքանչյուր շերտում 128 միավոր, մոտ 43 000 պարամետր, աշխատում է 50 Hz-ով դրոնի սեփական թռիչքի կարգավորիչի վրա՝ ներկառուցված ArduPilot-ի C++ կոդում շարժիչների խառնման մակարդակում, առանց լրացուցիչ համակարգչի ու հետկարգաբերման։ Այն կարդում է վերջին տասը վիճակի կադրերը (մոտ 0.2 վրկ)՝ կողմնորոշում, անկյունային արագություններ, դիրք, արագություն և ութարժեք ալիք՝ շարժիչների մղման մակարդակով։
Վարժեցումն ամբողջությամբ սիմուլյացիայում էր՝ MuJoCo և PPO՝ PufferLib-ի միջոցով, զրո, մեկ կամ երկու մեռած շարժիչով դրվագների ֆիքսված խառնուրդով (կշիռներ 0.1, 0.2 և 0.7) և ուսումնական ծրագրով, որը տիրույթի պատահականացումը բարձրացնում է նոմինալից ամբողջականի։ Մեկ ճարտարապետական հնարք համաչափության միջինացման գլուխն է. ցանցն իր կշիռները երկու անգամ է անցկացնում՝ իրական վիճակի և դրա 180°-ով պտտված վերապիտակավորված տարբերակի վրա, և միջինացնում է արդյունքները, ինչը քաղաքականությունը դարձնում է այդ պտույտի նկատմամբ ճշգրիտ համարժեք։
Ինչ դիմացավ և reward hacking-ի դասը
Վարժեցված լինելով միայն զրո, մեկ և երկու մեռած շարժիչի վրա՝ քաղաքականությունը իրական սարքի վրա պահպանեց դիրքը նույնիսկ եռակի և քառակի խափանումների դեպքում։ Հեղինակը ընդունում է, որ նախորդ տարբերակը reward hacking-ի դասագրքային օրինակ էր. չորս շարժիչով hover-ը նույն միավորն էր ստանում, ինչ ութով, ուստի գործակալը անջատում էր առողջ շարժիչները և թռչում որպես քվադրոկոպտեր։ Բոլոր հասանելի շարժիչների օգտագործումը պարգևատրող անդամի ավելացումը նոր վարժեցման ժամանակ ութ շարժիչներն էլ պահեց hover-ում 20-ից 20 դրվագում՝ 3.6%-ով ավելի ցածր ճշգրտությամբ, և ավելի լավ դիմացավ ուսուցման տիրույթից դուրս խափանումներին. 99%՝ 90%-ի դիմաց երեք մեռած շարժիչի դեպքում և 85%՝ 64%-ի դիմաց չորսի դեպքում։
Կարդալ արժանի սխալներ
Կառուցման մատյանը փաստագրում է նաև երեք սխալ, որոնք անվավեր էին դարձրել խափանումների կայունության բոլոր նախկին թվերը. զանգվածի կենտրոնից շարժիչ ընկած թևի երկարությունը կոդում 35.20 մմ էր՝ իրական 181.938 մմ-ի փոխարեն. իներցիայի բանաձևում 4π²-ի փոխարեն օգտագործվում էր 8π². իսկ շարժիչների դասավորությունը մոդելավորված էր որպես „+“, մինչդեռ իրական իրանը „X“ է։ Միասին դրանք սիմուլյացված դրոնին թողել էին ~2.6 անգամ պակաս կառավարման հեղինակություն։ Ուղղումներից հետո լրիվ տիրույթի պատահականացման պայմաններում կրկնակի խափանման դիմացկունությունը 71.7%-ից բարձրացավ 95.8%-ի, իսկ ամենադժվար՝ yaw-ով չփոխհատուցվող զույգերինը՝ 41.2%-ից 94.6%-ի։
Ութռոտորն ընտրվել է գիտակցաբար. շարժիչ կորցրած քվադրոկոպտերը օդում մնալու համար պետք է ամբողջովին հրաժարվի yaw-ի կառավարումից։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։