NVIDIA-ն ցույց է տվել MoE մոդելների արդյունավետ ուսուցման ուղին
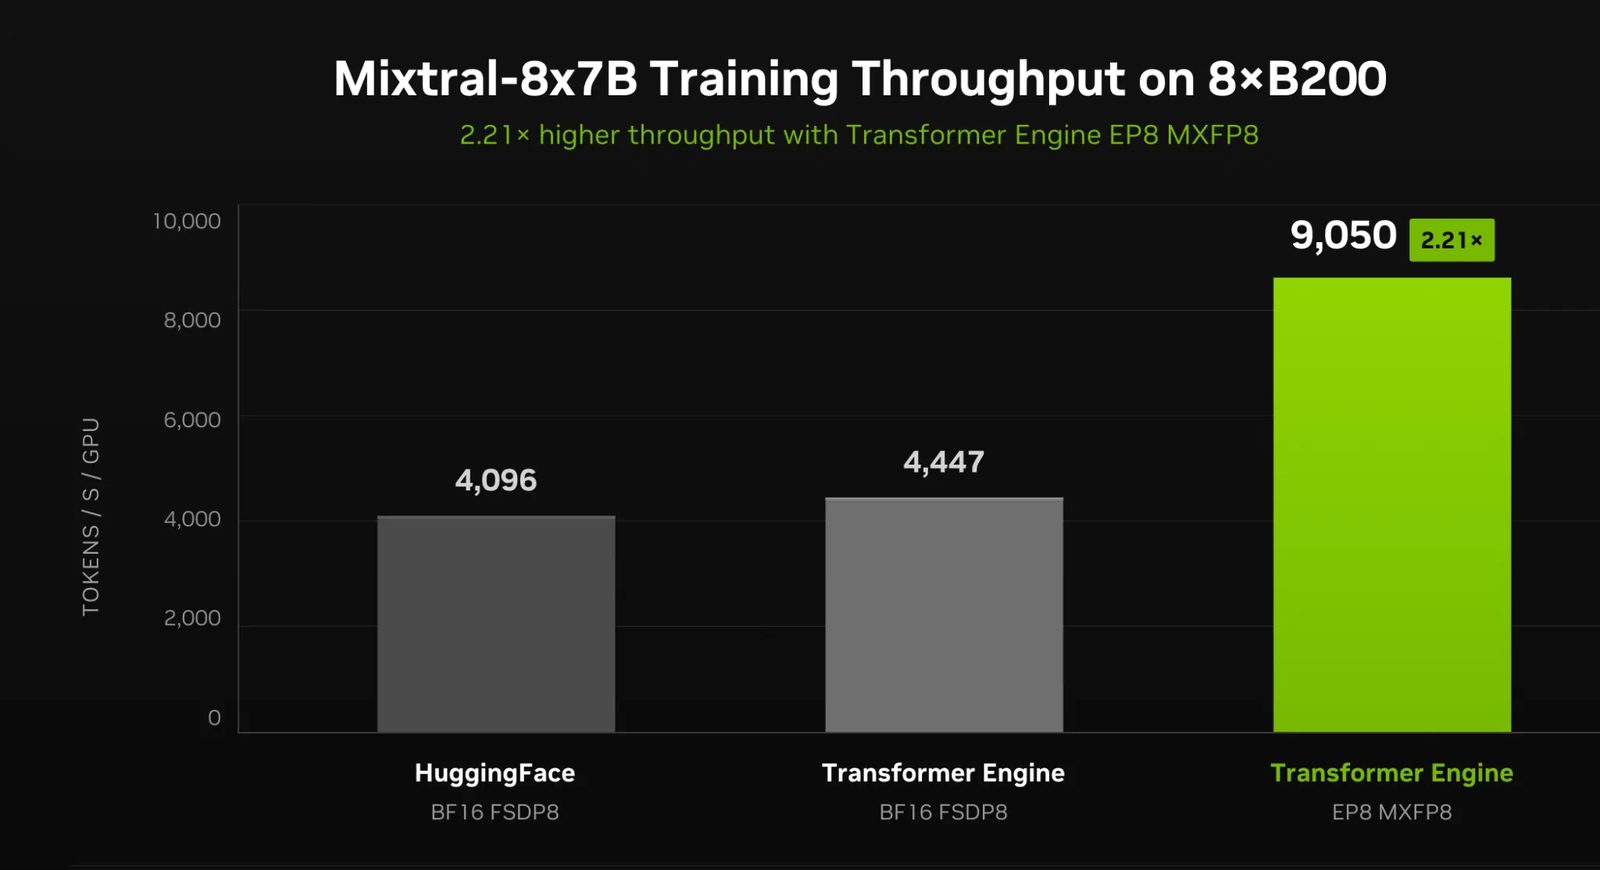
NVIDIA-ի ծրագրավորողների բլոգում հրապարակված ձեռնարկը բացատրում է, թե ինչպես են Transformer Engine-ը և BioNeMo-ի բաղադրատոմսը արագացնում կենսաբանական MoE մոդելների ուսուցումը. ութ B200 GPU-ի վրա արդյունքը 2,21 անգամ գերազանցել է բազային տարբերակին։
NVIDIA-ի ծրագրավորողների բլոգը հրապարակել է ձեռնարկ կենսաբանական հիմնարար մոդելների՝ փորձագետների խառնուրդով (MoE) ուսուցման մասին։ Հեղինակներն են Faradawn Yang-ը, Peter St John-ը, Kyle Tretina-ն և Zoey Zhang-ը։
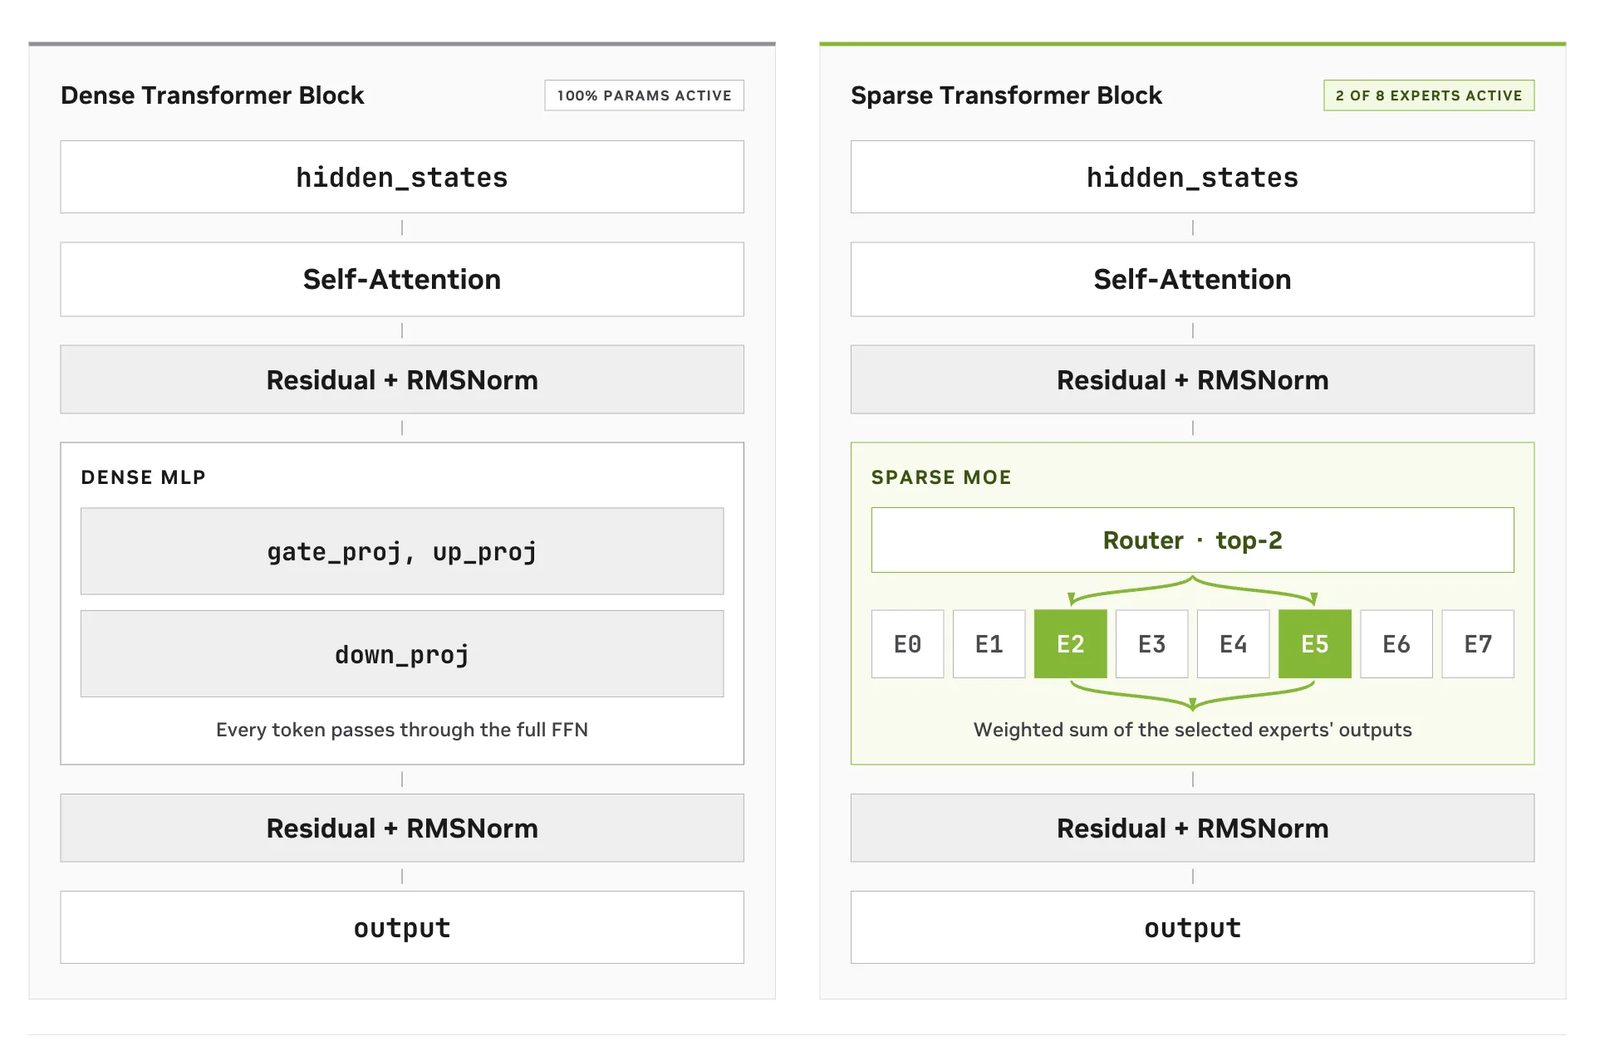
Խիտ տրանսֆորմերները յուրաքանչյուր թոքեն անցկացնում են բոլոր շերտերով, ուստի լրացուցիչ հզորությունը թանկ է թե՛ ուսուցման, թե՛ ինֆերենսի ժամանակ։ MoE ճարտարապետությունները feed-forward բլոկը բաժանում են բազմաթիվ փորձագետների և ամեն թոքենի համար ակտիվացնում են դրանց միայն մի մասը։ Արդյունքը կախված է իրականացումից. մասնատված հաշվարկները նվազեցնում են GPU-ի օգտագործումը, երթուղավորումը՝ ավելացնում հաղորդակցության ծախս, իսկ մեծ ծավալը ծանրաբեռնում է հիշողությունը։
Խմբավորված փորձագետներ՝ Python ցիկլի փոխարեն
Առաջին խնդիրը միջուկների մասնատումն է։ Hugging Face-ի բազային իրականացման մեջ փորձագետները հերթով աշխատում են Python ցիկլով, ուստի ամեն մեկն առանձին միջուկներ է գործարկում։ TE-ի GroupedLinear-ը հավաքում է փորձագետների կշիռներն ու թոքենները և բոլոր գծային ձևափոխությունները կատարում մեկ խմբավորված GEMM կանչով՝ փորձագետի հաշվով թոքենների քանակը ստանալով split_sizes արգումենտով։ NVIDIA-ի շտեմարանը կարող է այդ պրոյեկցիան միավորել MXFP8 քվանտացման հետ GroupedMLP միջուկում։
Հիշողության և քվանտացման ծախսերի կրճատում
MoE մոդելներն ավելի շատ պարամետր ունեն, գենոմիկական աշխատանքները՝ երկար հաջորդականություններ, ինչը ճնշում է ակտիվացիաների հիշողությանը։ BF16-ը արժեքը պահում է 16 բիթով, FP8-ը և MXFP8-ը՝ 8-ով։ MXFP8-ը մասշտաբի գործակից է տալիս 32 արժեքից բաղկացած յուրաքանչյուր բլոկի, իսկ Blackwell GPU-ների վրա այդ GEMM-երը կատարվում են Tensor Core-ի մասնագիտացված հրահանգներով։
Ցածր ճշտությամբ ուսուցումը հիմնական կշիռները դեռ 16 բիթով է պահում, ուստի քվանտացումն ու ապաքվանտացումը լրացուցիչ աշխատանք են ավելացնում։ GroupedLinear, ScaledSwiGLU և GroupedLinear գործողությունները TE-ի Sequential API-ով շղթայելը թույլ է տալիս փոխարինել այդ նախշը մեկ միավորված գործողությամբ՝ ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8-ով։
2,21 անգամ ավելի բարձր թողունակություն ութ B200 GPU-ում
Mixtral-8x7B-ով ութ NVIDIA B200 Tensor Core GPU-ի վրա անցկացված թեստում բաղադրատոմսը հասել է 2,21 անգամ ավելի բարձր թողունակության՝ Hugging Face-ի բազային տարբերակի համեմատ։ Միավորված MXFP8 GroupedMLP միջուկները պահանջում են Blackwell ապարատուրա, իսկ պարալելիզմին՝ առնվազն երկու GPU։
Ձեռնարկը ներառում է գործարկման հրահանգներ՝ երկու GPU-ով L0_sanity կոնֆիգուրացիա միջավայրը ստուգելու համար, ապա L1_8x7B_ep ութ GPU-ի վրա (EP=8, MXFP8)։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։