Fireworks AI-ը թողարկեց Ember-1-ը՝ Kimi K3-ի որակը 40%-ով քիչ թոքեններով
Fireworks Research-ը ներկայացրել է Ember-1 մասնագիտացված մոդելը, որը կառուցվել է Kimi K3-ի հիման վրա։ Ընկերության խոսքով՝ այն պահպանում է հիմնական մոդելի պատասխանի որակը՝ ծախսելով մոտ 40%-ով քիչ թոքեն։
Fireworks AI-ն թողարկել է Ember-1 մասնագիտացված մոդելը, որը Fireworks Research թիմը կառուցել է Kimi K3-ի հիման վրա։ 2026 թվականի սեպտեմբերի 23-ի հայտարարության համաձայն՝ Ember-1-ը տալիս է Kimi K3-ի պատասխանի որակը 40%-ով քիչ թոքենով. մոդելը սովորել է բաց թողնել այն դատողությունը, որը չի ազդում վերջնական պատասխանի վրա։
Ինչու դատող մոդելները թանկանում են
Ընկերության գրառման համաձայն՝ Kimi K3-ի նման դատող մոդելները գեներացված թոքենների մեծ մասը՝ երբեմն ավելի քան 90%-ը, ծախսում են ներքին դատողության վրա, այլ ոչ թե բուն պատասխանի։ Բազմաքայլ գործակալային աշխատանքներում վիճակն ավելի է վատանում. ամեն քայլ նախորդ դատողությունը նորից է վերադարձնում համատեքստ, ուստի համատեքստը աճում է քայլերի քանակի քառակուսուն համաչափ։ Kimi K3-ի դատողության ինտենսիվության իջեցումը չլուծեց խնդիրը, քանի որ ցածր կարգավորումները չափից շատ էին զիջում որակից։ Ուստի մոդելը պետք է սովորեր ավելի արդյունավետ դատել. թիմն անցկացրել է 50-ից ավելի ուսուցման փորձարկում և 200-ից ավելի գնահատում ու մշակել է նոր ալգորիթմներ, որոնք կրճատում են դատողությունը՝ չկորցնելով ճշգրտությունը։
Բենչմարքեր և Պարետոյի սահման
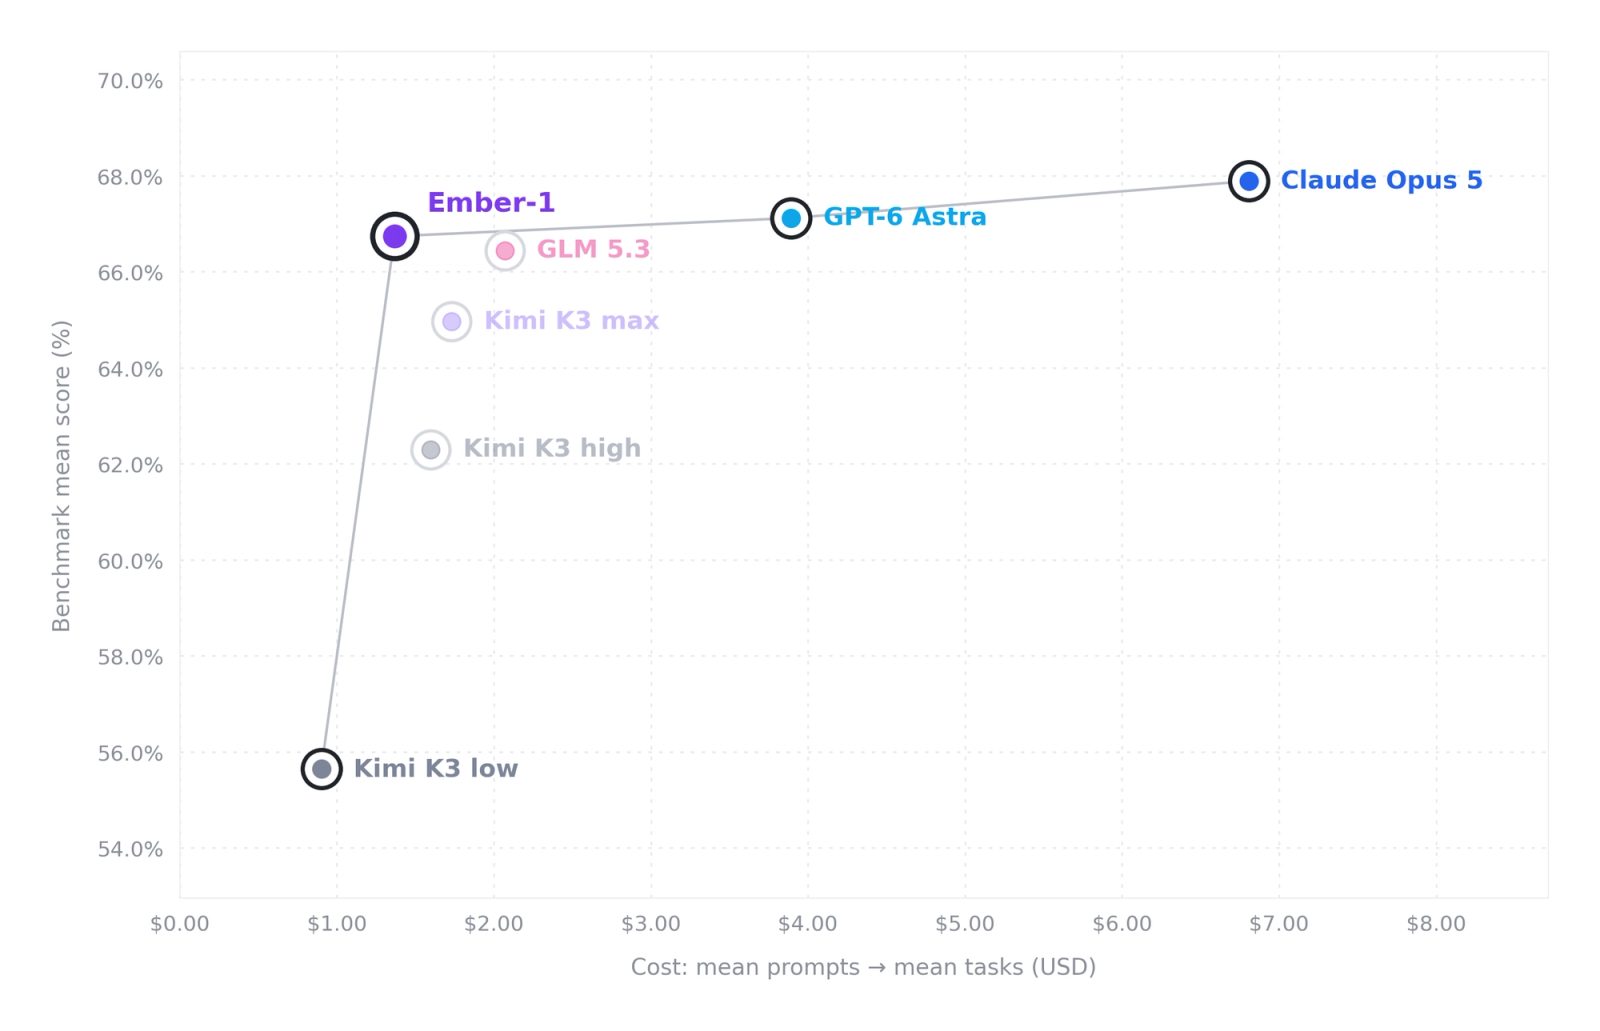
Յոթ բենչմարքի և երկու հաճախորդի արտադրական տրաֆիկի վրա Fireworks-ը պարզել է, որ Kimi K3-ի դատողությունը կարելի է կրճատել 35-50%-ով՝ առանց ճշգրտության կորստի։ Doximity-ի Bedside Bench բենչմարքում, որը բժիշկների կողմից հաստատված 500 կլինիկական դեպք է ընդգրկում 10 կատեգորիաներում, Ember-1-ը մեկ առաջադրանքի արժեքով նոր Պարետոյի սահման է սահմանել բաց և փակ մոդելների շարքում, այդ թվում՝ GPT-5.6 Sol-ի, GPT-6 Astra-ի և Claude Opus 5-ի։
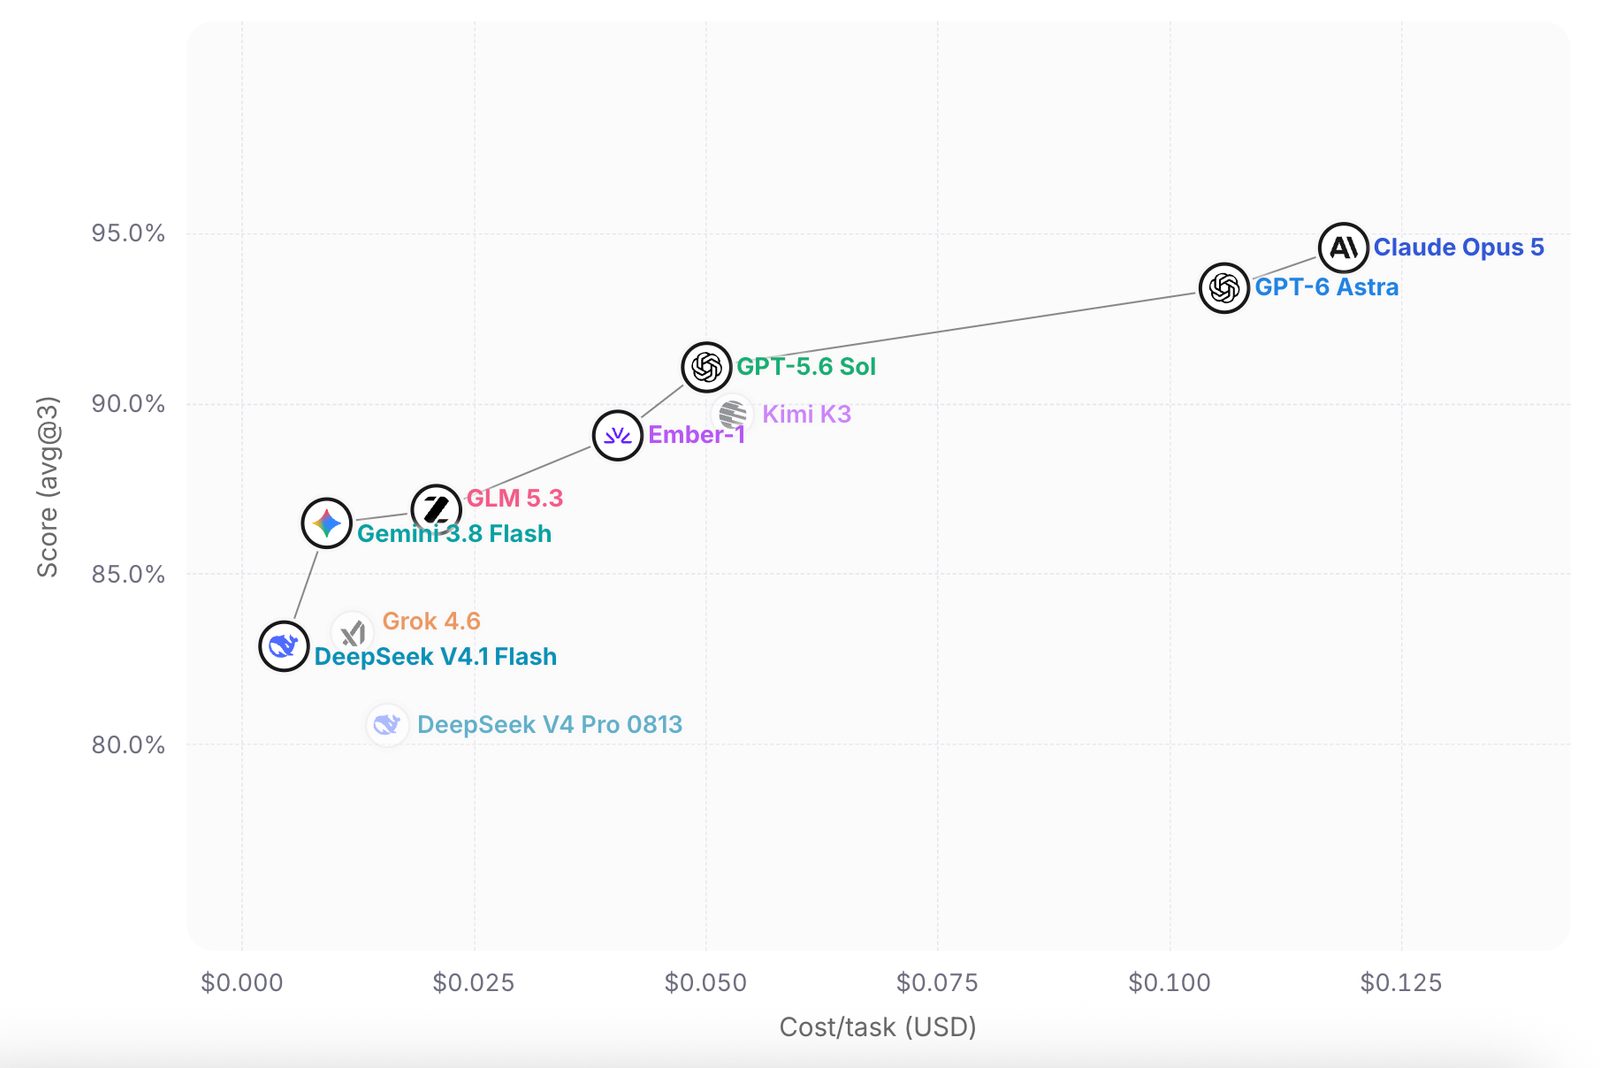
Առանձին բենչմարքերում արդյունքները մոտ են։ Terminal Bench 2.1՝ 82,0% 80,9%-ի դիմաց. DeepSWE 1.1՝ 75,2% 66,4%-ի դիմաց. SWE-bench Verified՝ 92,2% 93,2%-ի դիմաց. SWE-Interact՝ 20,0% 21,3%-ի դիմաց։ Fireworks-ի գնահատմամբ՝ դատողության ցածր ռեժիմում նույնպես Ember-1-ը գերազանցում է Kimi K3-ին։
A/B թեստեր, ներքին կիրառում և հաջորդ քայլեր
Երկու հաճախորդ անցկացրել է կենդանի A/B թեստեր արտադրական կոդավորման աշխատանքներում և համադրելի որակի պայմաններում ստացել մոտ 35%-ով քիչ թոքեն մեկ առաջադրանքի համար։ Մեկ թեստում առաջադրանքի միջին գնահատականը 0,751-ից բարձրացել է 0,753-ի, իսկ ելքային թոքենները 49,3 հազարից իջել են 29,9 հազարի. դատողության թոքենները կրճատվել են 71,3%-ով, ընդհանուր ծախսը՝ 39%-ով։ Ավարտի ու ձախողման ցուցանիշները մնացել են նույնը կամ բարելավվել. մեկ հաճախորդ արդեն Ember-1-ը շահագործում է արտադրական միջավայրում և պատրաստվում է ամբողջությամբ փոխարինել հիմնական մոդելը։
Fireworks-ը մոդելը հաճախորդներին ցույց տալուց առաջ սեփական ծրագրավորողներին տեղափոխել է դրան. ինժեներները փոփոխությունը չեն նկատել։ Ember-1-ը տարածվում է հիմնական Kimi K3-ի կողքին՝ հետազոտական նախադիտման ձևաչափով Serverless-ում։ Մեկնարկում է նաև ուսուցման աջակցություն ընկերությունների համար, որոնք ուզում են սեփական տվյալների վրա կառուցել հարմարեցված ու թոքեն-արդյունավետ մոդել։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։