NVIDIA-ի գաղտնի հաշվարկը Blackwell-ում պահպանում է AI ինֆերենսի 96%-ը
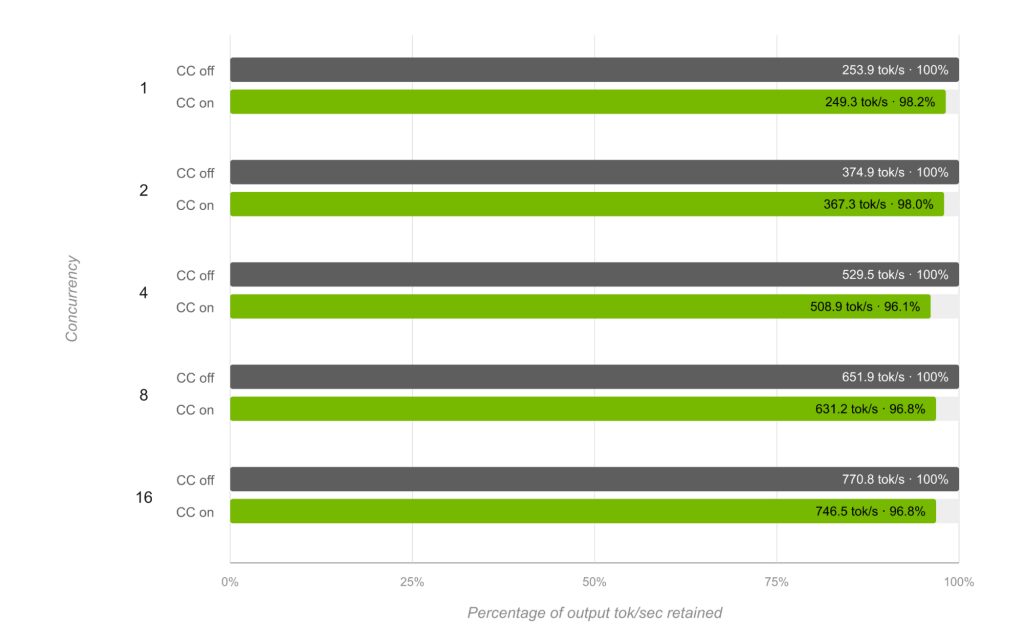
NVIDIA-ի տեխնիկական բլոգի համաձայն՝ TensorRT LLM-ը գաղտնի հաշվարկի միացված վիճակում ութ Blackwell B200 GPU-ում պահպանել է ելքային թոքենների արտադրողականության 96.1-98.2%-ը։
NVIDIA-ն հրապարակել է տեխնիկական վերլուծություն այն մասին, թե ինչպես է գաղտնի հաշվարկը (confidential computing) ազդում մեծ լեզվական մոդելների ինֆերենսի վրա և ինչպես է հարմարեցվել TensorRT LLM-ը, որպեսզի Blackwell GPU-երում գաղտնագրված կատարումը պահպանի արագությունը։
Գաղտնագրված հիշողությունը փոխում է ենթադրությունները
Գաղտնի հաշվարկը ծանրաբեռնվածությունը կատարում է գաղտնագրված հիշողությամբ վիրտուալ մեքենաներում՝ գաղտնի GPU-ներով և գաղտնագրված NVLink-ով։ Սակայն անվտանգ կատարումը փոխում է runtime-ի ենթադրությունները հիշողության տեղաշարժի, ժամանակի չափման, պլանավորման և մի քանի GPU-ների հաղորդակցության մասին, և դա արժենում է արտադրողականությամբ, եթե շրջանակը չի հարմարվում։
Ազդեցությունը տեսանելի դարձնելու համար թիմն ընտրել է երկար կոնտեքստ, երկարատև գեներացիա և ցածր զուգահեռականություն՝ DeepSeek-R1-0528-NVFP4 մոդելը TensorRT LLM-ի PyTorch backend-ով, 32K մուտքային և 1K ելքային թոքեն, 1-16 միաժամանակյա հարցում, TP=8 և FP8 KV քեշ։
Արտադրողականության 96%-ը պահպանվել է
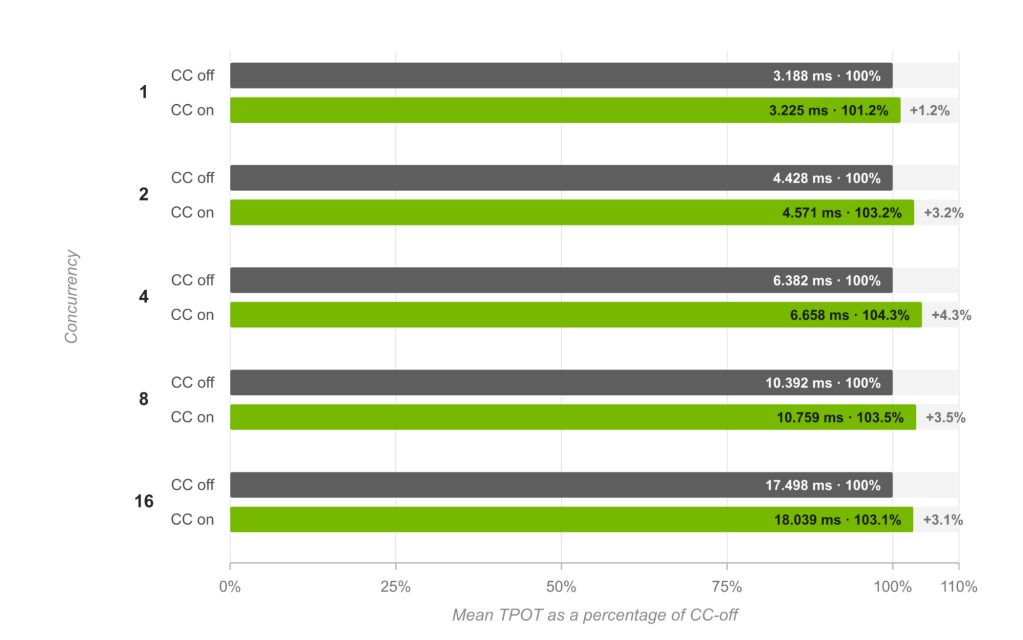
Փոխվել է միայն գաղտնի հաշվարկի վիճակը. մյուս պարամետրերը մնացել են անփոփոխ։ Սարքը՝ մեկ NVIDIA DGX B200 ութ B200 GPU-ով, Intel TDX, CUDA 13.2, NCCL 2.30 և TensorRT LLM 1.3.0rc22։ 1-16 զուգահեռականության մակարդակներում պահպանվել է ելքային թոքենների արտադրողականության 96.1-98.2%-ը, իսկ մեկ թոքենի միջին ժամանակը մնացել է 1.2-4.3%-ի սահմաններում։
Երեք տեղ, որտեղ շրջանակը հարմարվել է
Host-to-device փոխանցումները անցնում են ծրագրային գաղտնագրված bounce buffer-ով, քանի որ GPU-ն ուղղակիորեն չի մուտքագրում պաշտպանված CVM հիշողությունը։ Դրա պատճառով pinned memory-ն կորցնում է ասինխրոն առավելությունը, և որոշ պատճենումներ արգելափակում են thread-ը. TensorRT LLM-ն ընտրում է հիշողության տեսակը՝ հաշվի առնելով գաղտնի հաշվարկը, և թոքենների ընթերցումը տեղափոխում է ասինխրոն worker (PR #11573)։
Kernel-ների ավտոտյուները tactics-ները համեմատում է CUDA events-ով, սակայն գաղտնի հաշվարկի դեպքում ժամանակի ազդանշանը անկայուն է. այժմ այն չափում է GPU-ի %globaltimer-ով (PR #11657)։ NVLink SHARP multicast-ը չկա B200-ի գաղտնի կոնֆիգուրացիաներում, ուստի շրջանակները պետք է ստուգեն NVLS-ը և ընտրեն համապատասխան ալգորիթմներ։
Չափեք ձեր ծանրաբեռնվածությունը
NVIDIA-ի խորհուրդն է անվտանգության կարգավորումը և ինֆերենսի օպտիմիզացիան դիտարկել որպես մեկ տեղաբաշխման խնդիր՝ միացնել գաղտնի հաշվարկը, անցնել ատեստացիա և համեմատել վիճակները այն ծանրաբեռնվածությամբ, որը նախատեսում եք սպասարկել։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։