NVIDIA-ի SWE-Serve-ը ցույց է տալիս տեղական թեստերի ու կենդանի սերվինգի տարբերությունը
NVIDIA-ն հրապարակել է SWE-Serve չափանիշը, որը ստեղծվել է SGLang թիմի մասնակցությամբ և 83 միավորված pull request-ից կազմում է 53 առաջադրանք։ Մյուս բոլոր ստուգումներն անցած կարկատանների մոտ մեկ երրորդը ձախողվում է կենդանի սերվինգի թեստերում։
Կոդ գրող ագենտի կարկատանը կարող է անցնել թեստերը և այնուամենայնիվ ձախողվել, երբ սերվերը բեռնում է իրական մոդել ու սկսում մշակել հարցումները։ Այդ տարբերությունը չափում է NVIDIA-ի սեպտեմբերի 23-ին հրապարակած SWE-Serve-ը։ Չափանիշը մշակվել է SGLang թիմի մասնակցությամբ և 83 միավորված pull request-ը վերածում է 53 կատարվող առաջադրանքի։
Ինչ է ստուգում SWE-Serve-ը
Առաջադրանքները բաժանվում են վեց ուղղության՝ սպեկուլյատիվ և ընդլայնված ապակոդավորում (14), մոդելների ու բեքենդների միացում (12), միջուկներ, քվանտացում և արտադրողականություն (8), սերվինգի API-ներ և runtime-ի ճշգրտություն (8), քեշավորում (7), բաշխված կատարում և պլանավորում (4)։ CPU-ի վրա աշխատում է 12 առաջադրանք, մեկ NVIDIA H100-ի վրա՝ 41․ առաջին թողարկումը չի ընդգրկում այլ inference շարժիչներ, բազմաթիվ GPU-ներ և բազմահանգույց սերվինգ։ Իրական սերվեր գործարկում են 19 առաջադրանք։
Ինչ են բռնում կենդանի սերվինգի թեստերը
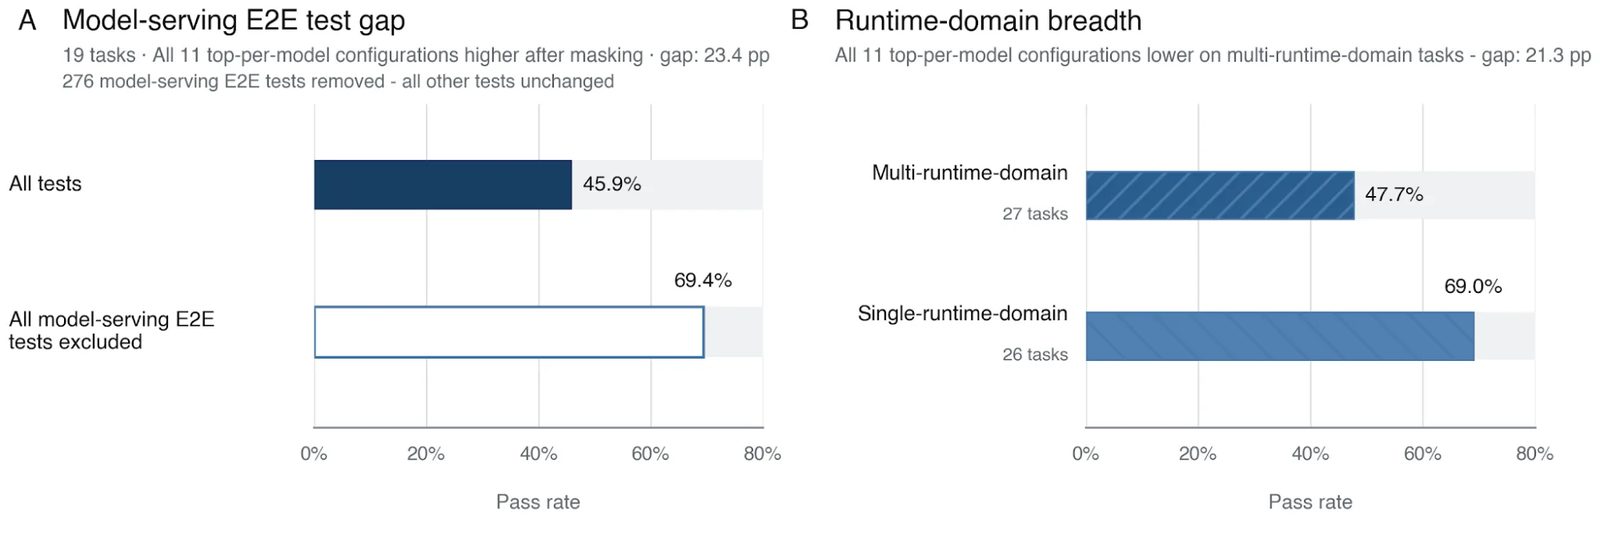
Կենդանի սերվեր գործարկող 19 առաջադրանքներում նույն 627 կարկատանները լրիվ վերիֆիկատորի դեպքում անցնում են 45,9%-ով։ Սերվինգի թեստերը բացառելու դեպքում ցուցանիշը բարձրանում է մինչև 69,4%, այսինքն՝ 147 կարկատան անցել է ձախողումից հաջողության, և մյուս բոլոր ստուգումներն անցած կարկատանների մոտ մեկ երրորդը չի դիմանում սերվինգի թեստին։ Այս առաջադրանքներում կա 276 սերվինգի թեստ, 242-ը՝ SGLang-ից։ Gemma 4 MoE-ի առաջադրանքը դա ցույց է տալիս հստակ․ 33 կարկատանից 16-ը անցել է բոլոր մյուս ստուգումները, բայց ձախողվել է սերվինգի թեստերից գոնե մեկում։
Հեղինակները ընդգծում են, որ հաջողությունը նշանակում է միայն վերիֆիկատորի բավարարում, այլ ոչ թե տեղակայման կամ միաձուլման պատրաստ լինելը։
Որտեղ են ագենտները պարտվում
Հարցումից պատասխան տանող ուղին բաժանվում է չորս runtime տիրույթի՝ հարցումների մշակում և I/O, պլանավորում ու հարցման կենսացիկլ, մոդելի կատարում, KV-cache-ի և ռեսուրսների կառավարում։ Մեկ տիրույթում սահմանափակված 26 առաջադրանքներում ցուցանիշը 69,0% է, իսկ մի քանի տիրույթ ընդգրկող 27 առաջադրանքներում՝ 47,7%, այսինքն՝ տարբերությունը 21,3 տոկոսային կետ է։
Հետազոտողները 11 մոդել և 31 կարգավորում ստուգել են mini-swe-agent-ով, որը օգտագործում է միայն Bash, փակ ռեժիմում։ Միջին pass@1-ը տատանվում է 34,6%-ից մինչև 75,5%։ Աղյուսակը գլխավորում են Claude Opus 5-ը և GPT-5.6 Sol-ը 75%-ով, սակայն 64%-ի վրա կանգնած չորս մոդելներ խիստ տարբերվում են ծախսով․ առաջադրանքի արժեքը 0,95 դոլարից մինչև 7,24 դոլար է, ժամանակը՝ 25,5-ից 99,9 րոպե։
Թիմը դիտարկել է 786 աղբյուր, կառուցել 156 թեկնածու և ընտրել 53-ը․ անփոփոխ կոդը պետք է ձախողվեր նոր վարքագծի թեստերում և անցներ ռեգրեսիան։ Գնահատման ընթացքում հանրային ցանցը և upstream պահոցները արգելափակված են։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։