Qwen3.6 27B՝ տեղական մշակման գործնական ոսկե միջինը
Quesma-ի բլոգի հեղինակը պնդում է, որ խիտ 27B մոդելը լավ է աշխատում նոթբուքի վրա, իրական առաջադրանքներում գերազանցում է ավելի արագ MoE տարբերակին և հասնում է 2025 թվականի կեսերի frontier մակարդակին։
Տեղական լեզվական մոդելները հազվադեպ էին դիտվում որպես ամենօրյա աշխատանքի լուրջ տարբերակ, սակայն Quesma-ի բլոգի հեղինակը պնդում է, որ Qwen3.6 27B-ը առաջինն է, որը արժե մշտապես գործարկել։ Մոդելը թողարկվում է երկու տեսքով՝ փորձագետների խառնուրդ Qwen3.6 35B A3B, որն ավելի արագ է, և խիտ Qwen3.6 27B, որն ավելի դանդաղ է, բայց ավելի ուժեղ. այն է, ինչ հեղինակը խորհուրդ է տալիս։
Ինչ փորձարկեց հեղինակը
Սովորական ստեղծագործական թեստերից բացի, մոդելին հանձնարարվեց OpenCode-ի միջոցով pnpm-ով վեցանկյուն «սակրավոր» խաղ կառուցել։ Այն մեկ հրահանգից, առաջին իսկ փորձից, պատշաճ Node փաթեթով աշխատող նախագիծ ստեղծեց։ Ավելի արագ 35B A3B-ն անտեսեց փաթեթ ստեղծելու հրահանգը և ամեն ինչ լցրեց մեկ index.html ֆայլի մեջ։ Մոմերի խանութի լենդինգ էջի ավելի երկար հրահանգը աշխատեց մի քանի րոպե և վերադարձրեց ադապտիվ էջ՝ խելամիտ լռելյայն կարգավորումներով։ Հեղինակի եզրակացությունը՝ frontier չափանիշներով ոչ արտառոց, բայց արդեն գործնական արդյունք։
Տեղական գործարկում
Կարգավորումը հենվում է llama.cpp-ի, ոչ թե Ollama-ի վրա, և Hugging Face-ից վերցնում է 8-բիթ քվանտացում՝ unsloth-ի Qwen3.6-27B-MTP-GGUF Q8_0 տարբերակը, որն աջակցում է բազմատոկեն կանխատեսմանը (MTP)։ Մեկ llama-server հրահանգը գործարկում է մոդելը MTP նախագծմամբ, բոլոր շերտերով GPU-ի վրա, միացված flash attention-ով, 64k կոնտեքստով և ամրացված պորտով. մոդելի բնական կոնտեքստը 256k է։ 8-բիթ քվանտացումը BF16 տարբերակի ծավալը կրկնակի կրճատում է գրեթե առանց որակի կորստի, իսկ 4-բիթ տարբերակը տեղավորվում է 18 ԳԲ-ից պակաս ծավալում՝ բավարար 32 ԳԲ-անոց սարքի համար։
Արտադրողականություն և համեմատություն
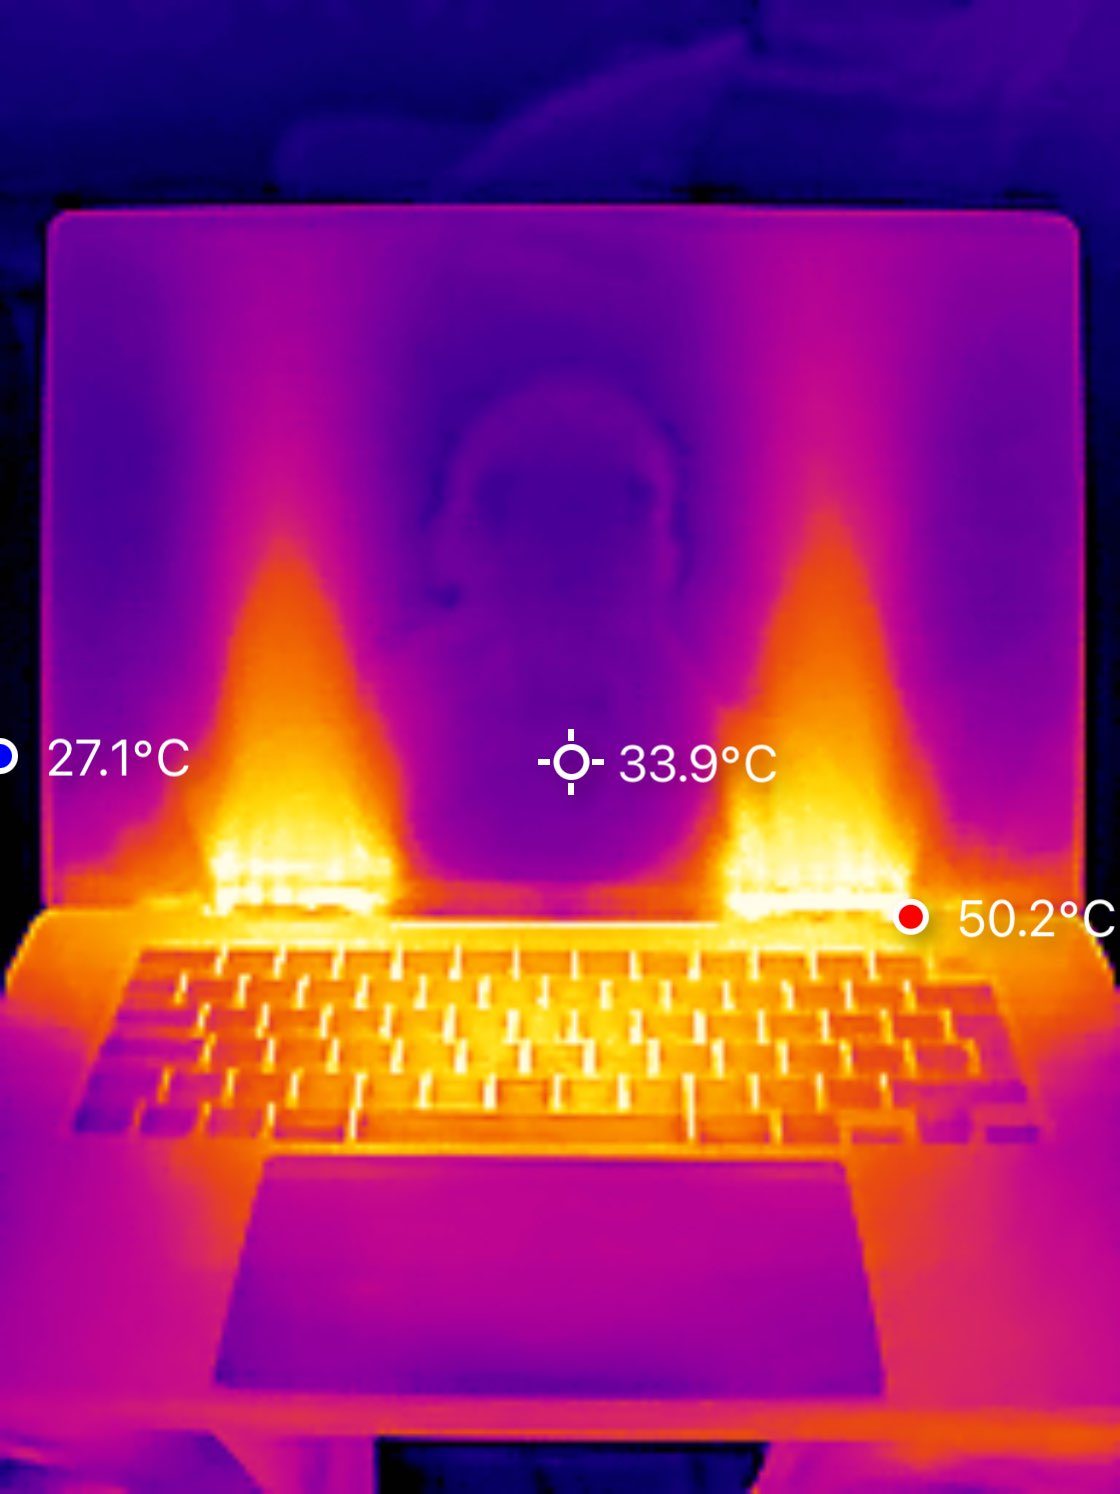
128 ԳԲ միասնական հիշողությամբ MacBook M5 Max-ում մոդելը վայրկյանում մոտ 30 տոկեն է արտադրում՝ frontier API-ների սովորական միջակայքում, և օգտագործում է GPU-ի մոտ 95 տոկոսը։ llama.cpp-ն ավելի արագ գտնվեց, քան mlx-lm-ը, թեև վերջինս նախատեսված է Apple չիպերի համար. Qwen3.6-ի երկու տարբերակներն էլ տեղավորվում են 48 ԳԲ հիշողության սահմաններում։ Սպառողական Nvidia RTX 5090-ում Hacker News-ի մի օգտատեր Q6_K քվանտացմամբ և Q4_0 KV քեշով 123k կոնտեքստում գրանցել է վայրկյանում մոտ 50 տոկեն։ Artificial Analysis ինդեքսում 27B-ն ստանում է 37 միավոր, ինչը հեղինակը համեմատում է 2025 թվականի կեսերի frontier մակարդակի հետ՝ 35B A3B-ի 32 և Gemma 4 31B-ի 29 միավորից առաջ։ Հեղինակը միևնույն է նախընտրում է 27B-ը՝ երեք անգամ պակաս կոդ, բայց ավելի բարձր որակով։ Նրա լայն արգումենտն այն է, որ տեղական մոդելները կարելի է լրամշակել, դրանք հնարավոր չէ հետ վերցնել, և դրանք պիտանի են զգայուն տվյալների համար։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։