Qwen 3.8 27B. գերազանց արդյունք 17 ԳԲ-ում, բայց լռելյայն չափից շատ է մտածում
Alibaba-ի Qwen լաբորատորիան Apache 2.0 լիցենզիայով թողարկել է տեսողության ունակությամբ 27 միլիարդ պարամետրով մոդել։ Այն աշխատում է սովորական սարքավորումների վրա, սակայն reasoning-ի լռելյայն կարգավորումը ավելորդ ռեսուրսներ է ծախսում։
Օգոստոսի 14-ին Alibaba-ի Qwen հետազոտական լաբորատորիան հրապարակեց Qwen 3.8 27B մոդելը՝ 27 միլիարդ պարամետրով, պատկերներ ճանաչելու ունակությամբ և Apache 2.0 լիցենզիայով։ Կշիռները հասանելի են Hugging Face-ում, իսկ մոդելը տեղային կարելի է գործարկել LM Studio-ի կամ llama.cpp-ի միջոցով։
Ցուցանիշներ և առաջին տպավորություններ
Qwen-ի հրապարակած արդյունքները նոր մոդելին հստակ առաջ են դնում ինչպես նախորդ Qwen 3.6 27B-ից, այնպես էլ փակ կշիռներով Qwen 3.7-Plus-ից, որը մայիսի դրությամբ համարվում էր Qwen-ի ամենաուժեղ մոդելներից մեկը՝ անկախ չափից։ Անկախ գնահատականներ դեռ չեն հրապարակվել։ Ծրագրավորող Սայմոն Ուիլիսոնը, ով փորձարկել է մոդելը 128 ԳԲ հիշողությամբ M5 Max MacBook Pro-ի և NVIDIA DGX Spark-ի վրա, 27B չափը համարել է իդեալական սովորական նոթբուքում ուժեղ մոդել գործարկելու համար։
Ավելորդ մտածողությունը՝ լռելյայն
Մոդելն ունի reasoning_effort պարամետր, որի լռելյայն արժեքը «xhigh» է, և LM Studio-ի GGUF տարբերակը պահպանում է այդ կարգավորումը։ Գործնականում սա նշանակում է, որ նույնիսկ ամենապարզ հարցումները ծախսում են հազարավոր reasoning token-ներ. LM Studio-ի լռելյայն 8 192 token-անոց կոնտեքստը արագ լցվում էր, և խնդիրը վերացավ միայն 262 144 token-անոց ամբողջական կոնտեքստը բեռնելուց հետո։
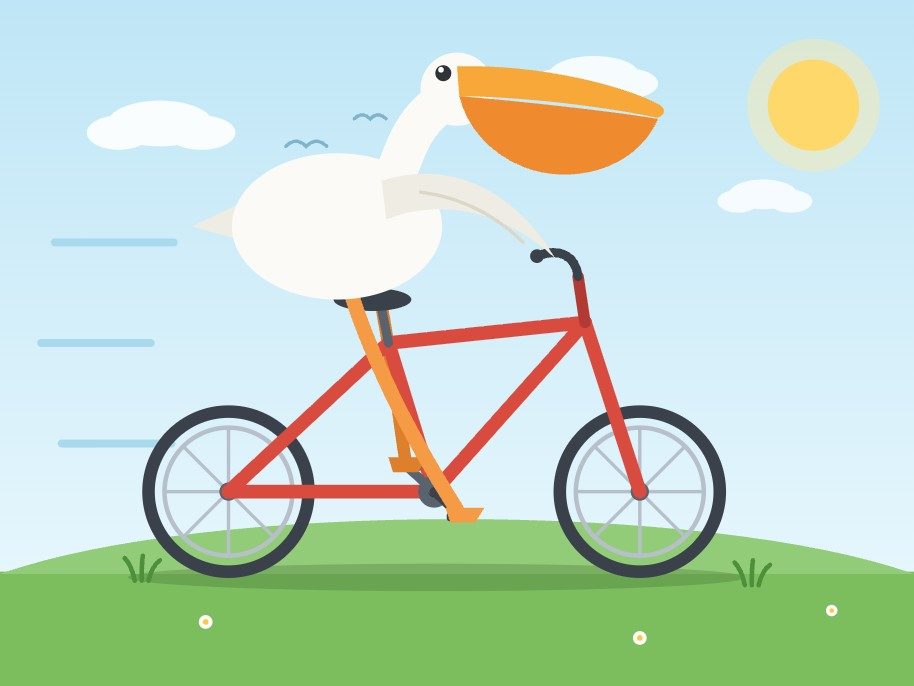
Փորձարկումներից մեկում մոդելին պահանջվեց 21 րոպե և 22 276 reasoning token, որպեսզի ստեղծի 3 223 token-անոց SVG պատկեր՝ հեծանիվ վարող հավալուսն։ Reasoning-ն անջատելու դեպքում նույն հարցումը տևեց 137 վայրկյան՝ 3 715 token-ով։ Իսկ պարզ «նկարիր շրջանագծի SVG» հարցմանը մոդելը պատասխանեց բարդ, անիմացիոն կոմպոզիցիայով։ Հեղինակի գործնական խորհուրդը՝ մոդելը սկզբում գործարկել ցածր մակարդակով կամ reasoning-ն ամբողջությամբ անջատած։
Տեսողություն, գործիքներ և արագություն
Մոդելը ուժեղ դրսևորվեց տեսողական վերլուծության մեջ. լուսանկարում հավալուսիների համար 0–1000 սանդղակով JSON շրջանակներ պահանջելիս այն վերադարձրեց օբյեկտների սահմաններին ճշգրիտ համապատասխանող կոորդինատներ։ Մեկ հրահանգով այն նաև կառուցեց փոքրիկ HTML գործիք, որը պատկերի վրա նկարում է նման շրջանակներ և ամբողջությամբ աշխատում է օֆլայն. արդյունքը չափից բարդ էր, բայց ֆունկցիոնալ։
Գլխավոր թերությունը արագությունն է։ LM Studio-ն տվեց մոտավորապես 15–30 token/վայրկյան, մինչդեռ Artificial Analysis-ի չափումներով OpenAI-ի հոսթինգում աշխատող 5.6 Sol-ը և 5.6 Luna-ն հասնում են համապատասխանաբար 74 և 184 token/վայրկյանի։ Համայնքային բարելավում արդեն կա. Qwen-ը աջակցում է Multi-Token Prediction-ին, և draft-mtp սպեկուլյատիվ վերծանման ռեժիմով գործարկված llama.cpp սերվերը DGX Spark-ի վրա անցկացված թեստում շուրջ 72%-ով գերազանցեց LM Studio-ի լռելյայն տարբերակին։
Հիմնական եզրակացությունն այն է, թե ինչ է ցուցադրում 17 ԳԲ-անոց ֆայլը. երկար կոնտեքստ, գործիքների կանչ, տեսողություն և որակյալ կոդի գեներացիա՝ մշակողի արդեն իսկ ունեցած սարքավորումների վրա։ Բաց հարցը մնում է, թե արդյոք inference-ի արագությունը կհասնի այդ հնարավորություններին։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։