Qwen3.8-27B-ը մեկ և երկու RTX 3090-ի վրա. +20% decode, +14% սառը prefill, 3x քեշավորված հարցումներում
Qwen3.8-27B-ի անձնական չափումը vLLM-ում. մեկ RTX 3090՝ tensor parallelism-ում երկու քարտի դեմ։ Երկրորդ քարտը 15–30% է ավելացնում decode-ին և միջինում 14%՝ սառը prefill-ին, իսկ տաք հարցումների առավելությունը prefix cache-ինն է։
Qwen3.8-27B-ը՝ 27.8 միլիարդ պարամետրանոց խիտ մոդելը, որը թողարկվել է օգոստոսի 14-ին, W4A16 քվանտացմամբ տեղավորվում է մեկ 24 գիգաբայթանոց քարտի վրա։ Arsen Apostolov-ը չափել է, թե ինչ է տալիս երկրորդ RTX 3090-ը tensor parallelism ռեժիմում։
Փորձարկման միջավայրը
Երկու սերվերներն էլ աշխատում են vLLM-ով, prefix caching-ը միացված է, նույն իմիջից և նույն Qwen3.8-27B-W4A16-AutoRound-fast կշիռներով։ Մեկ քարտն ունի 22.6 ԳԲ VRAM և 131,072 token-ի կոնտեքստ, իսկ զույգը կշիռները բաժանում է երկու քարտի վրա՝ 21.7 ԳԲ ամեն մեկին, և կոնտեքստը կրկնապատկում է մինչև 262,144 token։ Մեքենան ունի երեք RTX 3090, երկու Xeon E5-2660 v4, 60 ԳԲ RAM և Ubuntu 26.04։
Չափումը 150 տողանոց սկրիպտ է. հարցումներ չորս չափի prompt-ով (600-ից 9,300 token), ամեն մեկը երեք անգամ՝ մեդիանով, max_tokens=256 և temperature=0։ Սառը հարցումները եզակի առաջին տող ունեն, որ քեշավորված prefix-ը չհամընկնի։
Decode. երկրորդ քարտից 15–30%
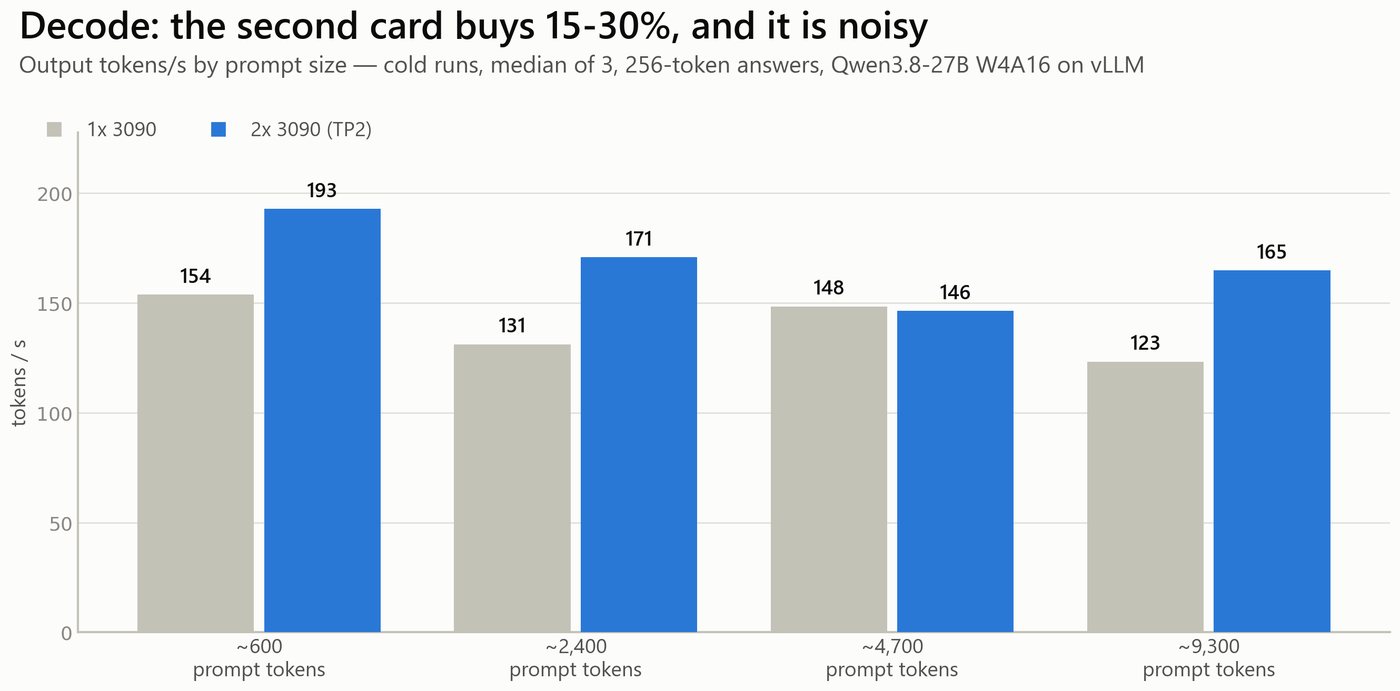
Մեկ քարտը վայրկյանում պահում է 123–154 token, զույգը՝ 146–193։ Միջին աճը այս արձակման ժամանակ +22% էր, մեկ ժամ առաջ՝ +13%, որովհետև մեկհոսք decode-ը մեկ ժամվա տարբերությամբ տատանվում է մոտ 10%-ով։ Հեղինակը արդյունքը դիտմամբ չի կլորացնում՝ 15–30%։
Prefill. սառը՝ քարտերի, տաքը՝ քեշի
Սառը prefill-ը կախված է հաշվարկներից. մեկ քարտը վայրկյանում մշակում է 1,100–1,220 token, զույգը՝ 1,230–1,360։ Առաջին token-ին սպասելու ժամանակը մեկ քարտի վրա 0.53 վայրկյանից հասնում է 8.5-ի, երբ prompt-ը 600-ից աճում է 9,300 token, իսկ երկուսի վրա՝ 0.50-ից 6.9-ի. տարբերությունը 6% է 600 token-ի դեպքում, 23%՝ 9,300-ի, միջինը՝ 14%։
Տաք հարցումները այլ պատկեր են ցույց տալիս. կրկնվող prompt-ը զույգի վրա վերադառնում է 0.5–0.75 վայրկյանում, մեկ քարտի վրա՝ 0.5–1.7 վայրկյանում. այս 2–3 անգամ տարբերությունը prefix cache-ինն է, ոչ ապարատին։ Հուշումը թվաբանության մեջ է. 8,600 token-ը 0.56 վայրկյանում վայրկյանում 15,000 token է նշանակում՝ տասը անգամ ավելի, քան երկու 3090-ը տալիս է 27B մոդելի վրա։
Ինչ արժե
Երկու կոնտեյներները սպասարկելիս մեքենան պատից քաշում է 620 Վտ։ Վայրկյանում 150 token տեմպով միլիոն token արտադրելը տևում է մոտ 6,667 վայրկյան, այսինքն՝ 1.15 կՎտ/ժ. Բուլղարիայի երկսակագնային սակագնով դա ցերեկը 0.34 BGN է, գիշերը՝ 0.21 BGN, մոտավորապես $0.20 կամ $0.12։ DeepInfra-ն Qwen3.8-27B-ը գնահատում է $3.00 միլիոն ելքային token-ի դիմաց։
Apostolov-ը չի պնդում, թե դա API-ն վատ ընտրություն է դարձնում. գնի մեջ ներառված են դատակենտրոնի էներգիան և սառեցումը։ Ավելի նեղ դիտարկումը. արդեն աշխատող սարքավորման վրա յուրաքանչյուր token գրեթե մաքուր մարժա է։ Հեղինակը նշում է թեստի սահմանը. մեկ հարցում, continuous batching-ը չի փորձարկվել։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։