Qwen3.8-Flash-Next․ Alibaba-ի Qwen թիմը ներկայացրել է Qwen4-ի ճարտարապետությունը
Qwen թիմը հրապարակել է Qwen3.8-Flash-Next-ը՝ 125 միլիարդ պարամետրով բաց կշիռներով մոդել, որից ակտիվ է միայն 6 միլիարդը, հիբրիդային նոսր ուշադրությամբ և 262 144 թոքեն համատեքստով։
Alibaba-ի Qwen թիմը օգոստոսի 26-ին հրապարակեց Qwen3.8-Flash-Next-ը՝ բաց կշիռներով փորձարարական մոդել, որը, ընկերության խոսքով, հիմք է դնում Qwen4-ի ճարտարապետությանը։ Կշիռները հրապարակված են Hugging Face-ում qwen-community-1.0 արտոնագրով և համատեղելի են Transformers, vLLM, SGLang և TokenSpeed գործիքների հետ։
Հիբրիդային ուշադրություն և QSA
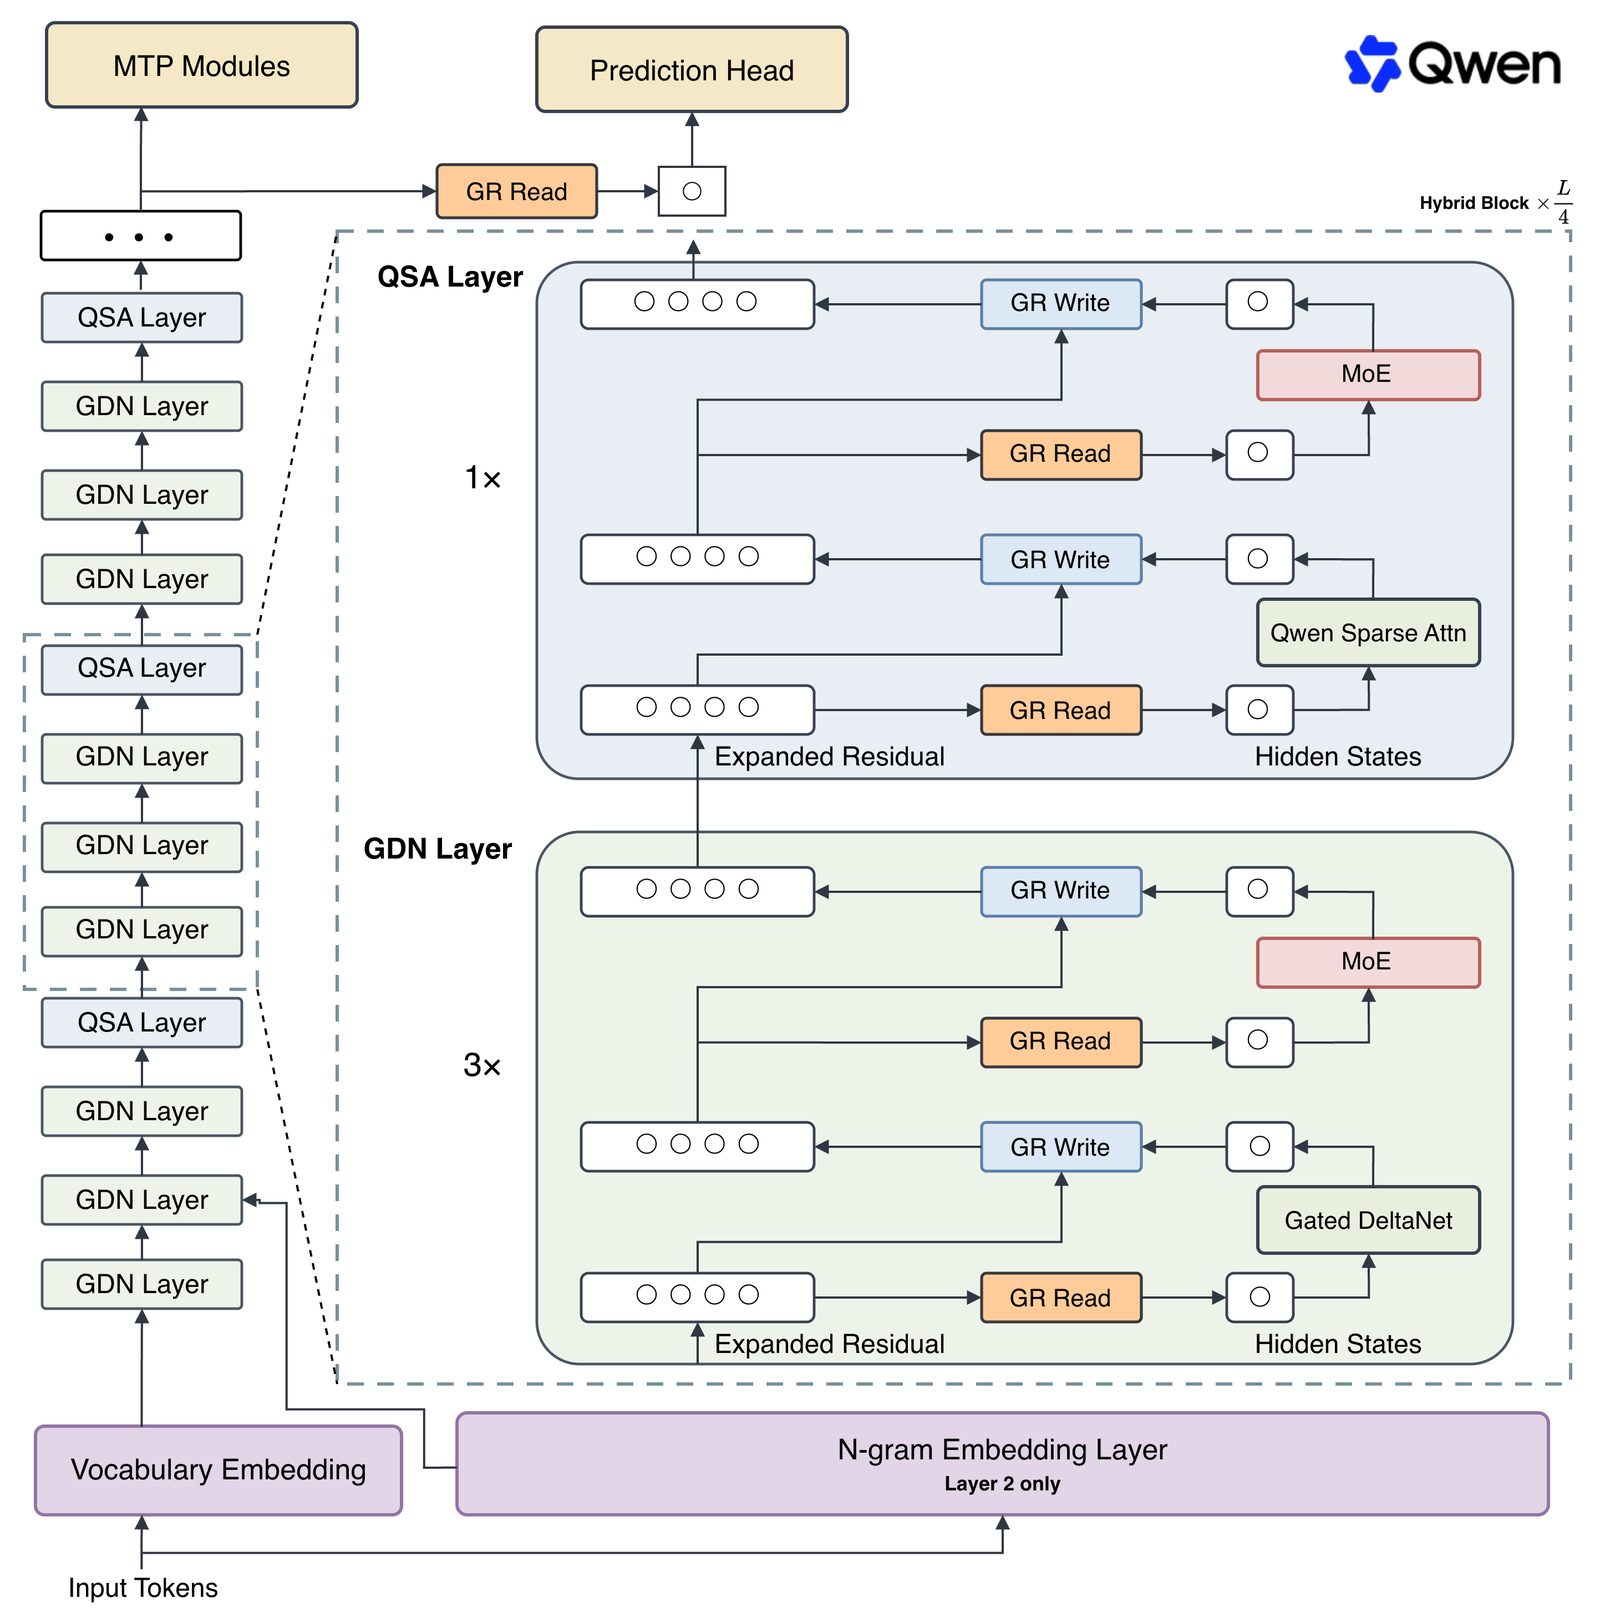
Հիմնական փոփոխությունը ճարտարապետական է․ Gated DeltaNet-ի և Gated Attention-ի զույգը վերամշակվել է Gated DeltaNet և Qwen Sparse Attention (QSA) կառուցվածքի։ QSA-ն առանձին թոքենների փոխարեն ընտրում է համատեքստը միկրոբլոկերի մակարդակով, ինչը զգալիորեն նվազեցնում է ուշացումը երկար համատեքստերում․ դա կարևոր է գործակալային ծանրաբեռնվածության համար, որը գնալով գերակշռում է իրական օգտագործման մեջ։
Gated Residual և n-gram ներկառուցում
Gated Residual-ը կարգավորում է տեղեկատվության հոսքը ընդլայնված residual հոսքերում՝ տվյալներից կախված տարրական ընթերցման դարպասով և ամեն ճյուղի սկալյար գրառման դարպասով, ինչը պահպանում է ուսուցման կայունությունը։ n-gram ներկառուցումը պարամետրերի մասշտաբավորման առանձին առանցք է․ այն ավելի քիչ հաշվարկ է պահանջում, քան mixture-of-experts-ը, և ավելի հեշտ է տեղափոխվում արտաքին հիշողություն՝ օգնելով սահմանափակ հիշողությամբ արագացուցիչներին։
Մասշտաբ և թեստերի արդյունքներ
Մոդելն ունի 125 միլիարդ պարամետր, որոնցից միաժամանակ ակտիվ է միայն 6 միլիարդը, գումարած 51 միլիարդ n-gram ներկառուցման և 4 միլիարդ MTP պարամետր։ Այն բաղկացած է 48 շերտից և 512 փորձագետից (10 ուղղորդվող և մեկ ընդհանուր)։ Համատեքստի պատուհանը բնականաբար 262 144 թոքեն է և ընդարձակելի է մինչև մեկ միլիոն։ Հրապարակված արդյունքներում Qwen3.8-Flash-Next-ը ստանում է 62.5 SWE-bench Pro-ում, 58.7՝ DeepSWE 1.1-ում, 81.0՝ SWE-bench Multilingual-ում, 48.1՝ NL2Repo-Bench-ում և 73.9՝ CoWorkBench-ում։
Ինչ է սա նշանակում մշակողների համար
Ուսուցման մասում Qwen-ը նշում է, որ Muon և AdamW օպտիմիզատորները կիրառվում են կշիռների որոշակի կատեգորիաների վրա, իսկ batch-size-ի ավանդական տաքացումը հանվել է՝ ուսուցումը սկսվում է անմիջապես թիրախային չափով։ Արտադրական տարբերակը՝ Qwen3.8-Flash-ը, աշխատում է ամպում՝ լռելյայն մեկ միլիոն թոքեն համատեքստով և ներկառուցված գործիքներով, մինչ բաց կշիռները մնում են ինքնուրույն տեղակայման համար։ Տեխնիկական զեկույցը հրապարակված է Qwen-ի GitHub պահոցում։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։