AWS-ն MoE մոդելների RL ուսուցումը EKS-ում EFA-ի և DeepEP-ի միջոցով 40%-ով արագացրել է
AWS-ը հրապարակել է MoE մոդելների մեծածավալ RL ուսուցման տեղեկատու ճարտարապետություն Amazon EKS-ում՝ EFA-ի և DeepEP-ի հետ։ P5en-ի 48 ինստանսում DeepEP-ի միացումը EFA-ի վրայով rollout-ի թողունակությունը բարձրացրել է 40 տոկոսով։
AWS-ը տեղեկատու ճարտարապետություն է հրապարակել MoE մոդելների մեծածավալ RL ուսուցման համար Amazon EKS-ում՝ EFA-ի և DeepEP-ով։ Սեպտեմբերի 25-ին AWS Machine Learning բլոգում հեղինակները հայտնում են, որ DeepEP-ը EFA-ի վրայով rollout-ի թողունակությունը բարձրացրել է 40 տոկոսով։
Rollout-ի ցիկլ, որը սահմանափակվում է հաղորդակցությամբ
Ավելի նոսր MoE ճարտարապետությունները էժանացնում են ինֆերենսը, բայց ուսուցումը դարձնում են հաղորդակցությամբ սահմանափակված։ Հիմնական աղբյուրը Expert Parallelism-ն է (EP), Tensor, Data և Pipeline Parallelism սխեմաներին ավելանում է թոքենների դինամիկ all-to-all երթուղավորումը ապարատների միջև։
Ասինխրոն RL աշխատանքը միաժամանակ երկու ծանրաբեռնվածություն է կրում, rollout-ի գեներացումը բաշխված ինֆերենս է և բարձրացնում է ընդհանուր թողունակությունը, իսկ քաղաքականության ուսուցումը պահանջում է համաժամանակյա, խստորեն կապված աշխատողներ, որտեղ մեկ հետ մնացողը կանգնեցնում է ամբողջ աշխատանքը։ Մեկ ինստանսից դուրս երթևեկությունն անցնում է միջհանգույցային ավելի դանդաղ գծերին։
Ինչպես է DeepEP-ը թոքենները փոխանցում EFA-ով
DeepEP-ը սովորական all-to-all կոլեկտիվները փոխարինում է երկու kernel-ով, dispatch-ը թոքեններն ուղարկում է հեռավոր փորձագետներին, combine-ը հավաքում է արդյունքները, հանգույցի ներսում դրանք օգտագործում են NVLink, հանգույցների միջև՝ libfabric։ AWS-ը upstream-ում փոփոխություններ է մտցրել, որոնք DeepEP-ի պրիմիտիվները տեղափոխում են libfabric, այդ պատճառով DeepEP v2-ը ստացել է EFA-ի բնիկ աջակցություն, իսկ NCCL 2.31-ը ավելացնում է EFA-ի վերջին օպտիմիզացիաները։ P5 և P6 ինստանսներում EFA-ն NVIDIA GPUDirect RDMA-ի հետ տվյալները փոխանցում է ուղղակիորեն GPU-ի հիշողության միջև։
Ինչ է ցույց տալիս չափումը և ինչ է անհրաժեշտ
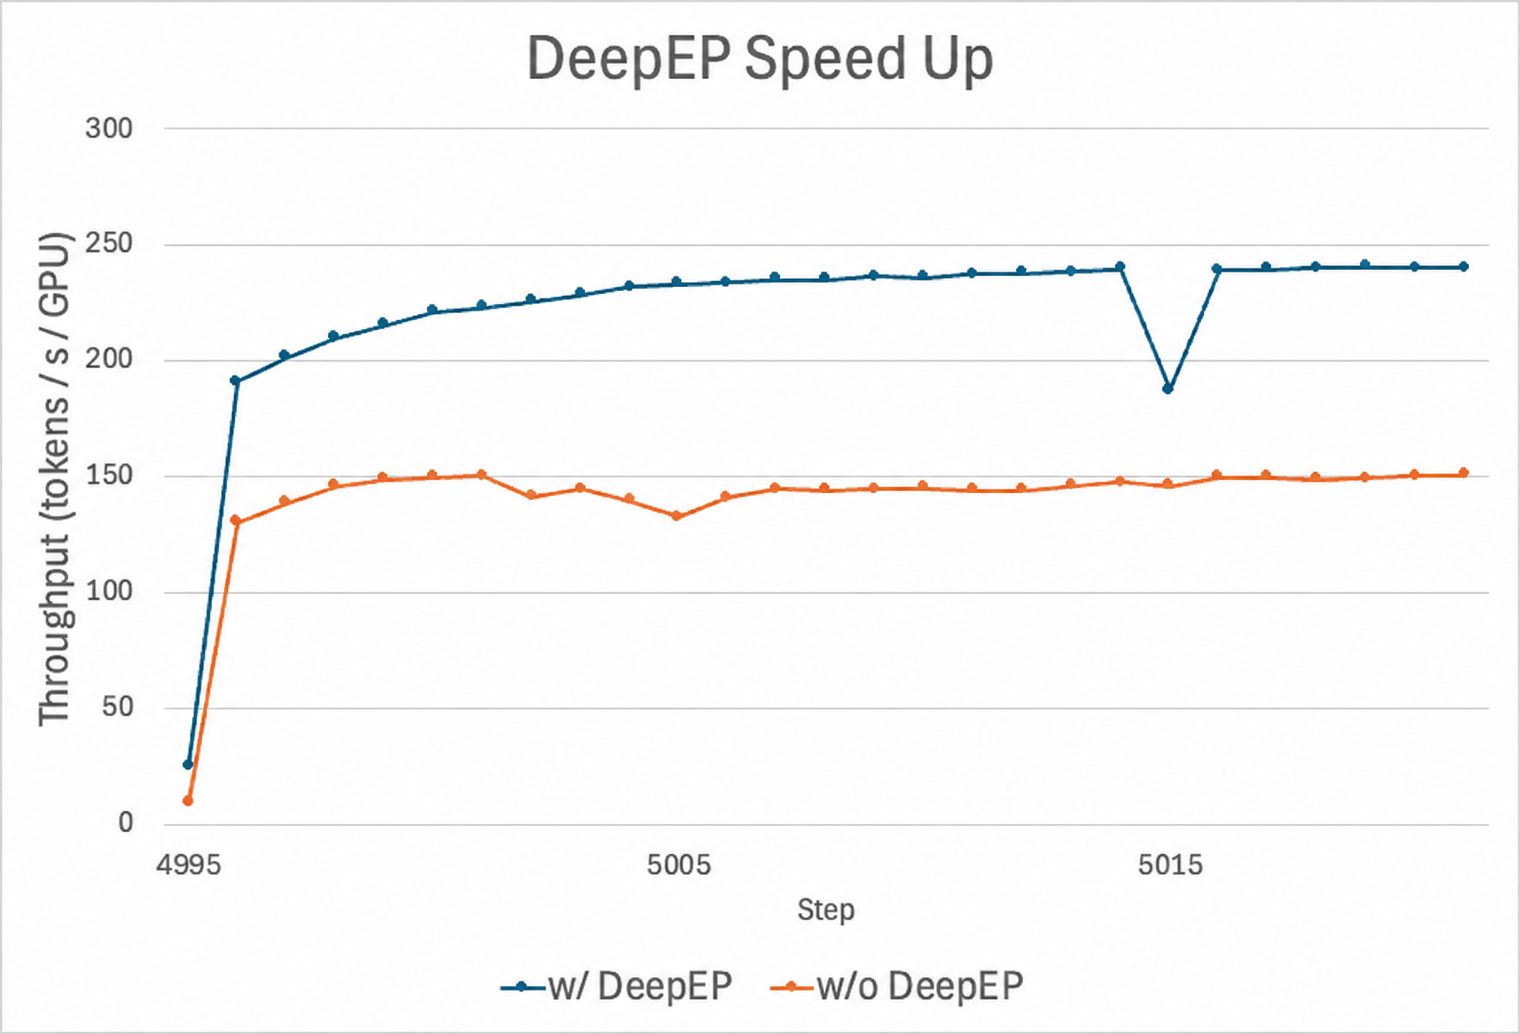
Ըստ AWS-ի՝ P5en-ի 48 ինստանսների վրա, 16-ը՝ ուսուցման, 32-ը՝ ինֆերենսի, նույն գերբարակ MoE մոդելով DeepEP-ի միացումը EFA-ի վրայով rollout-ի թողունակությունը բարձրացրել է 40 տոկոսով և հասել մոտ հազար արագացուցիչի մասշտաբի։ Բազային տարբերակը Slime-ի վրա կառուցված ստեկն էր (CUDA 12.9, PyTorch 2.9.1, NCCL 2.27, SGLang 0.5.9, Slime 0.2.4), բարելավվածը՝ DeepEP-over-EFA ստեկը (CUDA 13.0, PyTorch 2.12, NCCL 2.31, EFA 1.49, DeepEP 2.0, SGLang 0.5.17, Miles 0.1.0)։
Նյութում թվարկված են Amazon EKS 1.31 կամ ավելի նորը, EFA installer 1.49-ը AWS OFI NCCL plugin-ով և p5.48xlarge կամ p6-b200.48xlarge ինստանսները, հանգույցները պետք է լինեն նույն Availability Zone-ում։ Rollout-ի համար լավ են համապատասխանում Amazon EC2 Spot ինստանսները, չավարտված առաջադրանքները վերադառնում են հերթ, իսկ ուսուցումը մնում է կայուն։ Աշխատանքները ուղարկվում են TorchX-ով, checkpoint-ները պահվում են Amazon S3-ում։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։